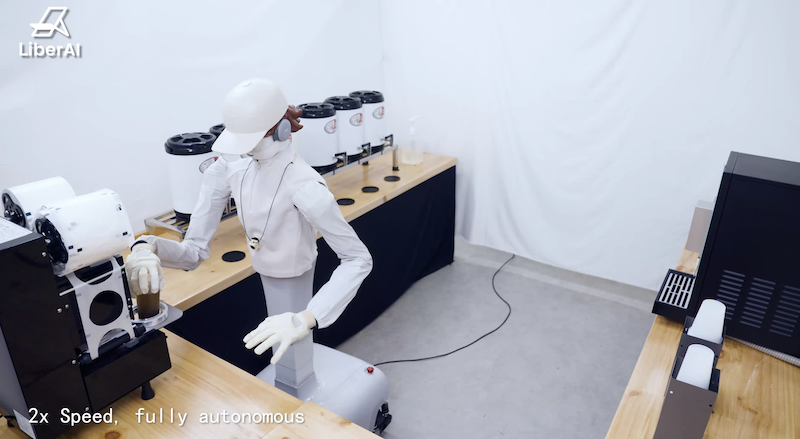
LiberAI一家物理AI创业公司正在为一般机器人开发基础系统,正在推出Liber-0,这是一个以超过2200万小时的人体经验预训练的世界行动模型,
Liber-0将大规模的人类视频与直接记录的手动,视觉和体现的调整和体现的学习结合在一起,目的是将人体体验转化为可通用的机器人操纵能力.
成立于2025年12月,LiberAI设计了其世界行动模型,以将人类经验转化为可通用的机器人操纵能力.
该公司设定了一个雄心勃勃的目标:通过寻找更可扩展的方式来教机器执行物理任务,将一般用途的家庭机器人带入日常生活中.
在Liber-0背后的基本理念令人惊地容易理解.
我们知道如何拿起杯子,打开一个抽,折叠一个毛巾,旋转一个,开一个瓶子,准备食物,
LiberAI希望机器人能够从人类积累的经验中获益.
传统上,教导机器人操纵物体主要依赖于使用机器人收集的示范.这种数据是有价值的,因为它直接记录机器可以执行的操作,但收集它需要访问机器人硬件和重复操作员的努力.
人体经验,相比之下,存在于巨大的规模.
Liber-0是LiberAI试图利用该资源的尝试.该公司将其描述为一个世界行动模型,或WAM,旨在学习视觉观测,物理行动和接下来世界发生的事情之间的关系.
当LiberAI说Liber-0在人类经验的2200多万小时上进行了预训练,
许多体验以大规模的人类活动视频形式进行,
更详细的训练数据,包括用仪器手套拍摄的人类示范和使用机器人进行的示范,有助于将模型所看到的与产生这些结果的物理行动联系起来.
我们的目标是将观看转化为行动.
为什么观察人类只是一个开始
视频似乎几乎提供了机器人所需的一切.
例如,一个人可以观看有人打开瓶子,并立即理解正在发生的事情.但视频不一定会告诉人工智能系统,一个人手指是如何移动的,一个物体是如何坚定地被抓住的,手腕是如何旋转的,或者是什么物理运动序列产生了可见的结果.
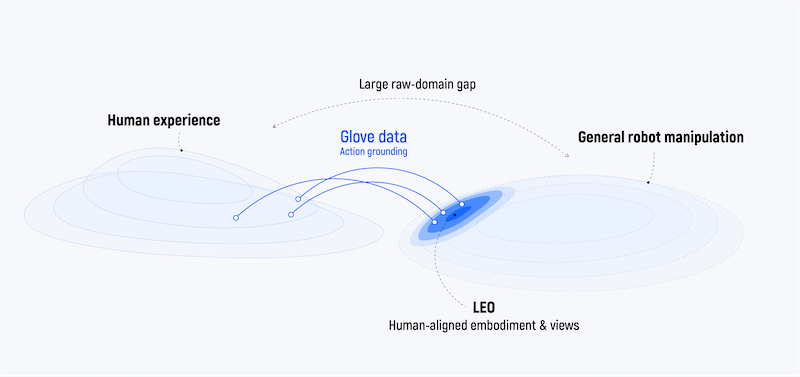
在将人类经验转移到机器人方面,LiberAI确定了三大挑战.
第一个是视觉. 人类录音和机器人摄像头可以从非常不同的角度看到同样的活动.
其次是该公司所谓的行动监督差距. 由于遮蔽,深度估计错误和其他局限性,从普通视频中推断的手头位置和轨迹可能是不完整或不准确的.
第三个是体格差距.人类和机器人有不同的身体.人类的手,手腕和手臂可以使用无法被特定机器人同样复制的运动来完成操作.
为了弥合这些差距,LiberAI的方法结合了几种类型的培训材料.
大量的人类视频为Liber-0提供了对象,环境和交互的广泛视觉体验.机器人示范提供了机器可以物理执行的行动的例子.两者之间是LiberAI研究中最有趣的元素之一:使用仪器手套记录的人类示范.
公司的轻量级数据手套记录了人们操纵物体时的手姿势和轨迹. 一台第一人摄像头和两个手腕安装的摄像头同时记录了活动.
这提供了比普通视频更丰富的信息,因为系统可以将视觉事件与人手实际移动的测量联系起来.
而手套本身被设计以尽可能少地干扰自然手指运动.
结果是观察人类活动和理解它们背后的身体行为之间的桥梁.
通过人类经验教导机器人
这种手套方法也有重要实用优势:收集人类操纵数据不需要机器人.
这将使人类体验成为更可扩展的物理AI训练数据来源.
而不是每次演示都需要机器人和操作员, 戴着LiberAI的数据收集设备的人可以在记录他们的运动和视觉观察时执行操纵任务.
因此,Liber-0不应该简单地被视为单个程序的目录, 制作咖啡应用程序, 炸蛋应用程序或 打开瓶脚本,
LiberAI正在尝试一些更基本的东西:构建一个潜在的物理行动模型,可以从以前的经验中学习,并将所学到的知识概括在不同的对象和操纵任务中.
同样,从人类中学习并不意味着机器人只是站在一个人的身边,一次观看一个新任务,然后立即重复它.
人类示范反而成为训练模型所使用的积累经验的一部分. 长期目标是让这种经验产生越来越普遍的物理能力,减少了教导新行为所需的机器人特定示范数据.
LiberAI已经通过将机器人示范与手套录制的人类示范结合,
在一个八任务评估中,使用25%的全机器人示范池和100%的手套示范池的培训政策取得了75.6的进步分数.
根据LiberAI的说法, 整个机器人和手套示范库包含了相同数量的示范, 这表明手套记录的人体验可以补充更少的机器人特定训练数据.
这一比较并不意味着训练数据总量减少了75% 大量的人类示范数据被添加.但它确实表明,人类经验可以使相对较小的机器人示范集合更有用.
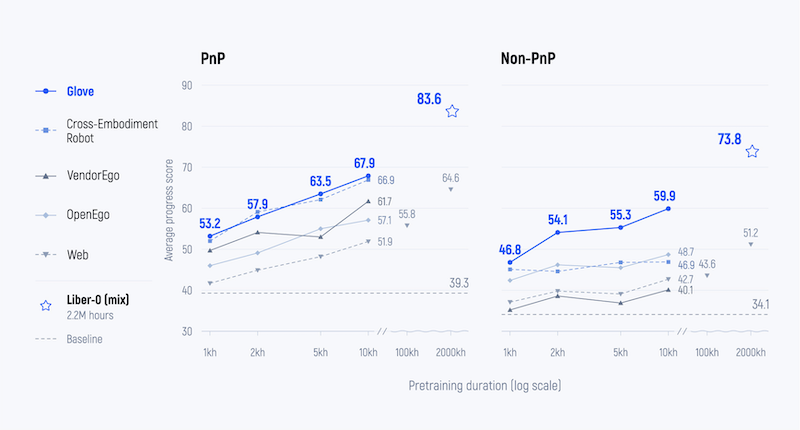
LiberAI还调查了手套数据是否可以引入机器人示范中缺失的操纵行为.
当机器人训练示范只涉及取放活动时,该政策在其他类型的操纵方面记录了2.2的进展分数. 增加涉及取放以外的人类手套示范增加了这一分数到47.5,而更广泛的手套数据将其提高到54.6 ,接近Teleop All参考记录的56.3.
对于LiberAI来说,这是朝着更大的目标迈出的重要一步:利用人类经验不仅仅提高了已知机器人行为的性能,
让机器人能够更好地从人身上学习
另一方面,LiberAI也在从另一个方向来解决人与机器人的问题.
如果人工智能可以从人类身上学习物理技能,那么如果机器人能够复制至少人类使用的一些运动来执行这些技能,就有所帮助.
因此,该公司的LEO机器人采用了精巧的手,动的手腕和可调节的腰部,而其摄像头则被定位以提供与训练使用的人类录像更紧密的视图.
想象一下一个简单的东西,
在手腕旋转时,手指需要建立和保持适当的抓住.打开抽需要手指与手柄接触,而手,手腕和手臂协调拉动.在地板附近的东西可能需要身体的上部以及手臂和手动移动.
LiberAI认为,减少人类和机器人运动之间的不必要差异使人体验更容易转移.
在公司技术材料中描述的测试中,LiberAI为其LEO机器人和另一台机器人平台Tianji培训了不同的政策,
在三项任务中,使用匹配的手套数据和同等数量的平台特定的远程操控数据,LEO记录了旋转扣的91.3分,排列拖鞋的80.0分和开放抽的100.0分,而Tianji的平均分分分分分分别为76.3,35.0和75.0.
除了硬件方法之外,Liber-0还使用了该公司所谓的统一体现.
这给模型提供了对执行行动的物理身体的信息.包括身高,臂长,身体配置和手几何等的人类特征,与机器人手臂和精明手的几何和运动能力相结合.
重要的是,模型不需要假设每个身体都以完全相同的方式执行任务.
相反,体现成为适当行动预测的环境的一部分.
一个高身的人,一个矮身的人和一个机器人都会用不同的动作打开相同的抽.LiberAI希望其模型能够学习潜在的物理行为,同时考虑到这些差异.
构建身体行动的基础模型
因此,Liber-0可以被理解为机器人基础模型的新一代的一部分,尽管LiberAI专门将其系统描述为世界行动模型.
有一个有用的比喻与大语言模型改变了生成人工智能.
大型语言模型从大量的人类语言中学习,而不是被单独编程以回答每一个可能的问题.LiberAI在物理世界中追求一个相关的想法:将模型暴露于大量的人类经验中,并教它感知,行动和物理结果之间的关系.
但物理AI引入了额外的并发症.
文字为计算机提供了人类知识的相对常见表现.身体行动没有.人类的手和机器人握手基本上是不同的机制,甚至两个机器人也可能需要不同的运动来完成相同的任务.
Liber-0试图通过多个阶段的培训来克服这一问题.
首先,该模型从涵盖各种人类活动,物体和环境的视频中学习广泛的视觉预测.
下一个阶段将未来视觉观测的预测与行动的预测结合在一起,将人类视频与手套和机器人录音的运动信息结合在一起.
最后一个以操纵为重点的阶段更重视了精确的运动和持续的物理互动.
在其研究中评估的训练配置中,LiberAI表示,Liber-0的完整训练方法产生了最强的整体操纵性能.
此外,该公司还正在探索未经评估的模型未经使用专门用于这些任务收集的机器人示范训练的零射操纵任务.
该公司表示,Liber-0在整个评估中取得了36%的成功率. 该公司表示,LiberAI已经组装了60项此类任务的单独套件,分为取放活动,其他操纵任务和更具挑战性的长活动.
此外,LiberAI还开发了一种互动模拟,其中该政策获得了100个小时的模拟远程操控后训练. 在这种适应后,用户可以介绍自己的对象并观看Liber-0在虚拟环境中试图操纵它们,而没有额外的对象特定训练.
对于更长时间和更复杂的活动,LiberAI表示Liber-0可以与更高层次的AI代理合作.该代理将更大的目标分解成中间目标,而Liber-0将这些目标转化为物理行动序列,随着任务的进展,新的观测提供反.
这种结合指向比预定义的机器人程序库更广泛的东西:机器能够利用积累的物理经验来确定如何实现新的目标.
从观看人类到表现得像他们一样
终极目标是将一般用途的机器人带入日常生活中.
实现这一目标需要能够处理各种物体,环境和情况的机器人,这些机器人很难单独预测.
例如,一台家庭机器人不能依靠其开发人员为每一杯子,抽,瓶子,衣服,厨房器具或其他可能遇到的物体编程单独的程序.
这就是为什么LiberAI认为人类经验可以成为如此重要的资源.
此外,该公司还看到可扩大其模型可用的丰富和多样性的经验的巨大空间.
目前的数据手套记录了手姿势和轨迹,但LiberAI表示接触和力仍然是未来发展的重要维度.看起来几乎相同的两个运动可以产生非常不同的结果,具体取决于接触发生在哪里以及使用的力量.
因此,添加触觉和力感应可以为插入和固定物体或操纵灵活和变形材料等活动提供更丰富的监督.
此外,LiberAI还计划将数据收集扩展到日常环境中.
由于基于手套的收集不需要在每一个位置都有机器人,人们可能会在更广泛的家庭,布局,物体和日常活动中展示有用的行为,
这将使Liber-0回到这个错误的简单想法,
人们不会独立学习每一个物理任务.遇到一个陌生的抽的人通常不需要学习如何打开抽.一个人可以拿起他们以前从未见过的杯子,操纵一个新瓶子,或者弄清楚一个陌生的物体可能会如何移动,因为他们可以利用一的相关物理经验.
一般用途的机器人需要类似的东西:不仅需要不断增长的编程行动,
解放AI的方法是从可用的最大的物理体验来源开始 人类自己,并找到将人们学到与世界互动的知识转化为机器人可以执行的行为.
换句话说,目标不仅仅是教机器人更多个性任务.
这就是教导他们如何从经验中学习.
在GPT-6提出的60项任务的零射评估中,Liber-0取得了36%的总体成功.