摘要
机器人学习通常被认为受到数据稀缺的制约,但研究社区实际上已经积累了数万小时公开可用的示范数据。因此,关键挑战在于如何有效复用不同机器人平台采集的异构数据集。
我们提出以相机为中心的动作表示,作为机器人数据的统一接口。这种表示刻画了视觉与动作之间的关系,同时抽象掉不同机器人本体特有的运动学差异。基于这一思路,我们构建了 CamX:一个包含 2 万小时开源机器人示范数据的统一数据集,数据来自 37 个来源,并被转换为统一的以相机为中心的表示。
为了利用 CamX,我们训练了统一视频-动作模型 CamUVA。该模型采用以相机为中心的动作表示,并通过相机位姿识别每个相机视角和动作流。这一设计使模型能够从跨本体数据集中获取价值,并直接泛化到未见过的机器人本体。
CamX 和 CamUVA 共同为系统研究两个问题提供了基础:一是什么因素重要,即哪些设计选择能够实现有效 Scaling;二是能够实现什么,即 Scaling 带来了哪些能力。最终,我们希望通过这项实证研究展示一条扩展机器人学习规模的路径:有效复用不断增长的异构开源机器人数据。
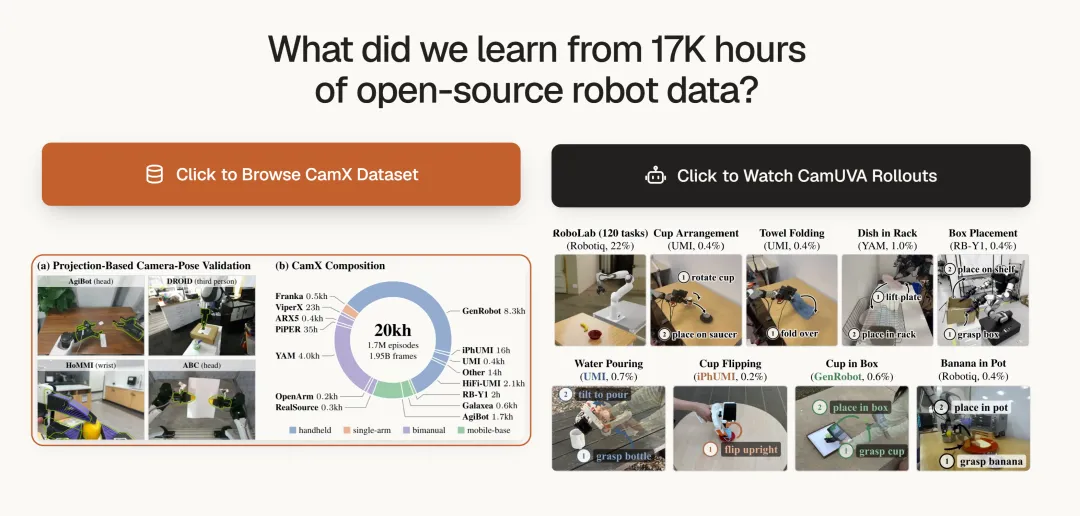
数据样本和策略 rollout 查看
camx-anonymous.github.io
1 引言
机器人学习领域有一种常见说法:这个领域缺乏数据。然而,机器人社区已经积累了数量惊人的公开机器人数据。如今,开源数据集包含数万小时的示范,覆盖不同的机器人、任务和环境。https://umi-data.github.io/
然而,大多数现有策略——即便是跨多个本体训练的策略——也没有充分利用这些来自不同机器人本体的大量数据。因此,挑战更多在于如何有效利用已有数据。
更好地利用现有数据的主要障碍是异构性:机器人数据集采用不同的本体、动作空间、相机配置、坐标系和传感器模态进行采集。Open X-Embodiment 等工作已经展示了聚合多个机器人平台数据的好处,但在这些数据集上训练的策略通常仍需要额外微调,才能适配目标本体及其动作空间。这表明,仅仅积累数据集是不够的:用于统一数据的表示方式,与数据规模同样重要。
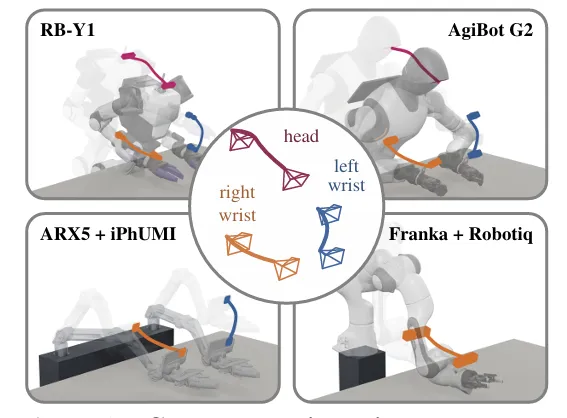
图 1:以相机为中心的动作表示统一异构机器人数据。 刚性安装在机器人可移动连杆上的相机,例如末端执行器或头部相机,能够直接对应相关动作和任务相关的观测,而不与特定本体绑定。
我们如何统一不同的机器人数据集?我们的核心直觉是:以相机为中心的动作表示,为感知与动作之间建立了一个自然的、本体无关的接口。如图 1 所示,刚性安装在机器人连杆上的相机,例如腕部、躯干或头部相机,与该连杆之间保持固定的刚体变换,并随其一起运动。因此,相机运动能够捕获与任务密切相关的关键信息——机器人应如何移动双手——同时抽象掉关节配置和运动学等本体特有的细节。这使得以相机为中心的动作能够在不同本体之间保持一致,同时保留视觉观测与物理运动之间的几何关系。
为了在大规模数据上验证这一思路,我们构建了 CamX:一个统一数据集,汇集了来自 37 个来源、约 2 万小时的公开机器人数据,共 170 万条 episode,如图 2 所示。构建 CamX 需要将不同机器人本体和相机配置下采集的数据集转换为统一的以相机为中心的格式,并通过数据校正和过滤 pipeline 处理标定、坐标约定、时间对齐以及动作表示中的不一致问题。坐标约定的细节见附录 C.1。
基于 CamX,我们开发了 CamUVA,即 Camera-Centric Unified Video-Action Model。这是一个联合预测视觉观测和以相机为中心的动作的视频-动作模型。CamUVA 旨在处理不同机器人之间相机配置和数据格式的巨大差异,包括相机数量与安装位置、图像分辨率、帧率和序列长度。
为此,我们通过相机位姿识别不同视角,而不是使用固定的相机身份标识,使模型能够泛化到任意相机配置。为了适应异构观测空间,观测和动作被打包为可变长度序列,而不是填充至固定形状。此外,CamUVA 在视频与动作目标上进行联合训练,既支持视频动力学建模,策略性能也优于仅使用动作目标训练的对应模型。
CamX 和 CamUVA 使我们能够系统研究大规模训练机器人模型时什么因素重要——即设计决策——以及能够实现什么——即模型能力。这帮助我们确定了一组能够提升跨本体性能的关键设计选择,包括:将相对相机轨迹作为动作表示、使用相机位姿进行多视角编码,以及联合训练视频和动作。
更重要的是,CamUVA 展现出了一些仅靠单个数据集难以研究的能力:无需针对特定本体进行微调,它在训练中出现过的不同本体上达到了与单本体策略相当的性能;它也能够直接在未见过的机器人配置上运行,包括具有不同相机视角和夹爪形状的配置,展现出零样本跨本体泛化能力。
本文的贡献包括:
CamX: 一个经过验证的数据集,包含来自 37 个来源、共 2 万小时的开源机器人示范数据,并采用统一的以相机为中心的表示。
CamUVA: 一个灵活的统一视频-动作模型,支持任意相机配置,同时具备视频动力学建模与策略学习能力。
实证研究: 系统研究从异构机器人数据中学习时的设计选择,并分析影响跨本体迁移能力的因素。
2 相关工作
跨本体数据集与策略。 开源机器人数据如今涵盖单臂、双臂和 Humanoid 平台、手持式腕部相机平台,以及聚合式数据集。通用策略通过以下方式弥合本体差异:为不同本体配备各自的动作头或编码器;使用归一化、离散化的末端执行器动作;填充动作向量;或使用本体提示。这些设计在面对新机器人时,可能需要微调,或调整输入、输出映射。
另一类工作寻求共享的动作接口,例如从视频中学习潜在动作、从机器人动作标签中学习通用动作编码、使用语言,或使用在参考相机坐标系中表示的末端执行器动作。
最后一类方法仍然将末端执行器作为受控对象,并使用经过标定或估计的变换,将预测映射到机器人坐标系;CamVLA 则在不提供相机外参的情况下预测这一变换。相比之下,CamX 将刚性安装在可移动连杆上的相机视为受控对象,使手持式、单臂、双臂和 Humanoid 示范能够共享同一种 轨迹格式和统一的相机坐标系约定,详见第 3.1 节。
视频-动作模型。 视频预测可用于策略预训练、结合逆动力学动作解码的视觉规划,以及合成示范生成;V-JEPA 2 则通过以动作为条件的潜在空间预测进行规划。联合视频-动作模型同时生成未来视频帧和动作,近期一些方法还对预训练视频生成模型进行了适配。
Cosmos Policy 为不同视角分配时间槽位,并将动作编码为潜在帧;DreamZero 在空间维度上平铺不同视角,并使用动作编码器和解码器;UVA 则使用独立的扩散头解码视频和动作。这些方法的视角布局和动作接口各不相同,迁移到新机器人时可能需要微调。
此外,已有工作将相机几何信息注入视觉 Transformer:一种方式是使用逐像素射线条件,另一种方式是在注意力机制中使用相对几何编码;Gamma-World 则在 3D RoPE 的基础上增加了一个 agent 轴。CamUVA 通过相机位姿识别每个视角和动作流,使单个模型能够处理任意数量的视角和末端执行器组。
3 方法
3.1 CamX 数据集构建
面向不同本体的统一格式。 对于末端执行器轨迹,我们将每个数据集的末端执行器坐标系转换到其腕部相机坐标系,使用二者之间的固定变换消除坐标系约定的差异,详见附录 C.1。
对于关节轨迹,我们使用机器人的 URDF 计算正向运动学,并将得到的法兰位姿与法兰到相机的固定变换进行复合。对于静态第三人称相机,我们使用公开的相机外参。对于移动操作机器人,我们将底座运动纳入相机轨迹:固定在底座上的相机记录底座运动,腕部相机则同时记录底座和机械臂的运动。
我们将数据组织为多个执行器组,例如左腕、右腕和头部。每个组都包含一条主相机轨迹、一条夹爪宽度数据流,以及一个或多个 RGB 视角,其中也包括双目相机视角。
刚性安装在某个执行器组上的视角,通过其相对于该组主相机的固定变换进行存储。我们还记录固定第三人称相机的外参,用于识别视角。这些转换一次性解决了不同数据集各自存在的差异,使策略在单臂机器人、双臂系统和移动操作机器人上都能接收相同的以相机为中心的输入,并预测相同的以相机为中心的输出。
部署时,我们通过经过标定的相机到法兰变换,将预测的相对相机轨迹映射为法兰目标位姿。
数据验证。 我们使用相机内参和相机到夹爪的变换渲染夹爪网格,并通过目视检查渲染结果与实际观测到的夹爪是否对齐,以验证相机与夹爪之间的对齐关系,如图 2a 所示。
通过检查每个数据来源和采集配置的叠加图,我们发现了一些原始元数据中没有标出的标定错误,详见附录 C.3。
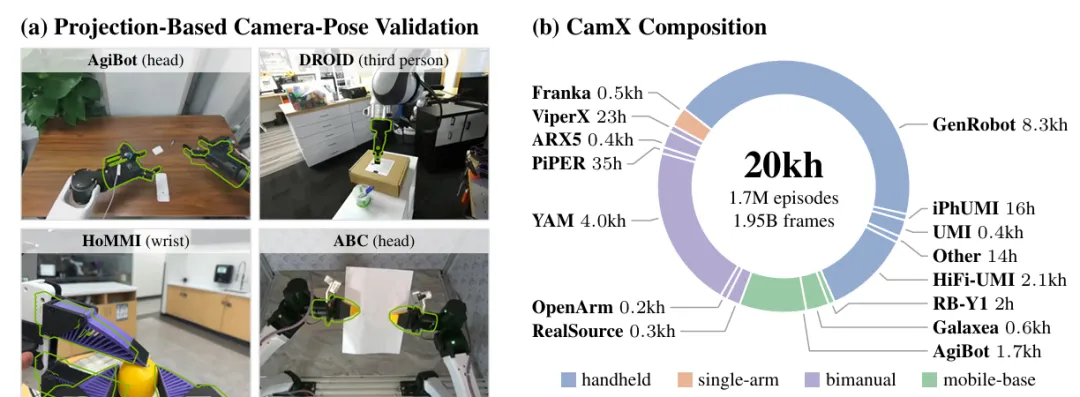
图 2:CamX 数据集。 我们在每个相机视角中渲染夹爪网格,图中绿色轮廓表示渲染结果,以验证相机坐标系以及相机到夹爪的变换。细微的间隙来自不同机器人之间的制造差异,以及每条 episode 中的跟踪误差,不会影响相对相机轨迹。
CamX 共包含约 2 万小时、170 万条 episode 和 19.5 亿帧,涵盖手持式设备、单臂机器人、双臂机器人和移动底座平台。
3.2 CamUVA 模型设计
模型架构。 CamUVA 是一个 Mixture-of-Transformers 模型。每一层包含三个分支,并在同一条打包后的 token 序列上共享注意力机制。
其中,70 亿参数的理解分支处理语言指令,70 亿参数的视频分支处理视频潜变量;两个分支均使用 Cosmos3-Nano 初始化。10 亿参数的动作分支从头初始化,用于处理相机轨迹和夹爪宽度 token。
遵循 Fast-WAM 的设计,干净 token 只关注语言 token 和干净 token。因此在部署时,这些 token 的 key 和 value 只需计算一次;只有带噪 token 需要经过每一步去噪。
用于视角识别的位姿编码。 以往的多视角模型通过空间拼接或时间拼接识别视角,如图 3a、3b 所示。这使视角身份与所选择的布局绑定。Simplex Rotary Agent Encoding 则使不同身份在旋转角度空间中保持等距,但不对相机几何信息进行编码。
相比之下,我们对每个输入 token 应用 Camera Pose Encoding,简称 CaPE,如图 3d 所示。对于携带相机位姿 的 token,我们以连续的四个通道为一组,将其 query 变换为 ,将 key 变换为 。

图 3:视角识别。(a、b)通过槽位识别;(c)通过等距相位识别,但不包含几何信息;(d)通过为所有 token 编码绝对相机位姿,在注意力计算过程中得到相对变换 。
来自相机 和相机 的 token 之间的注意力 logit 因此变为 ,仅取决于二者之间的相对位姿 。
视频 token 携带其相机在条件帧中的位姿,动作 token 携带所属组的腕部相机位姿,语言 token 则携带腕部相机的平均位姿。所有位姿均相对于腕部相机的平均初始位姿表示,从而消除各数据来源世界坐标系原点的差异;推理时,这些位姿由相机标定结果提供。
本体无关的编码与灵活的序列打包。 如图 4a 所示,我们在所有本体之间共享同一个 Wan2.2 视频 VAE、相机轨迹 MLP 和夹爪宽度 MLP,从而无需为特定本体设置专属权重。
随后,我们对每个数据流应用交错式 3D MRoPE,并根据时间戳对齐视频序列和动作序列的时间索引;动作 token 的 和 索引设为零。因此,两个视角会获得相同的 MRoPE 索引,仅通过 CaPE 区分。这种设计在架构上不限制相机视角、轨迹和夹爪宽度数据流的数量。
最后,我们将所有输入字段展平为一条一维 token 序列,并使用 FlexAttention 为每个样本实现独立的注意力掩码。训练时,每个 token 只能关注同一样本中当前或更早 chunk 的 token,如图 4b 所示。
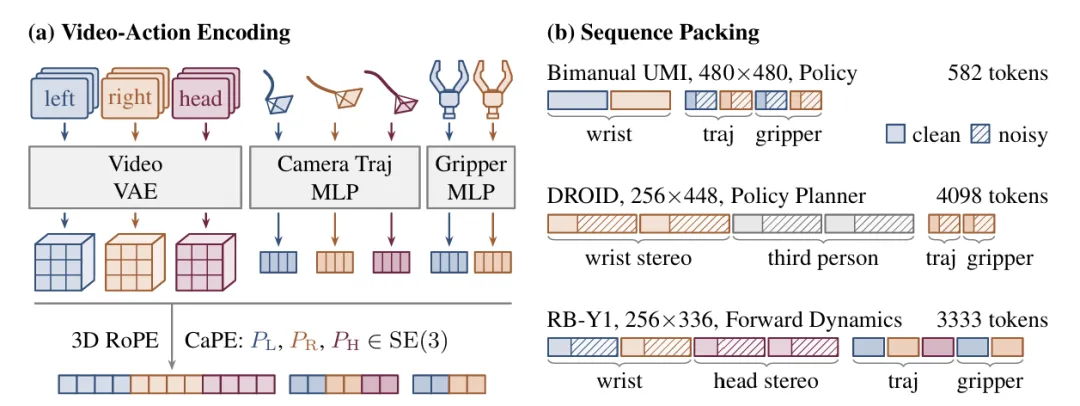
图 4:异构数据的编码与打包。(a)每种模态使用一个编码器,并由所有视角共享;每个 token 都获得 3D RoPE,以及其对应相机的 CaPE。因此,视角或轨迹由其位姿识别,而非由其槽位识别。(b)一个模型服务于所有本体和 UVA 模式:变化的只有序列中包含哪些数据流,以及其中哪些 token 作为已知条件提供。模型同时对所有带噪 token 进行去噪。
视频-动作训练目标。 我们使用 UVA 的五种目标进行训练:Policy(P)、Policy Planner(PP)、Video Generation(VG)、Forward Dynamics(FD)和 Inverse Dynamics(ID),如图 7 所示。在本文后续内容中,我们使用这些缩写和颜色指代相应模式。
对于所有 UVA 模式,每个 chunk 均由 33 帧观测 和动作 组成,其中 。我们以随机采样的噪声水平,向生成帧中需要去噪的模态添加噪声,同时保持条件帧不加噪声,示例见图 4b。
我们使用 Flow Matching 训练两种模态,并且只在需要生成的 token 上计算损失。采样时,我们使用适配 Flow Matching 的 UniPC。
4 实验
4.1 什么因素重要?——设计决策研究
我们使用统一的训练配置,对各项设计选择进行消融实验,详见附录 B.4。除非另有说明,我们使用 Cosmos3-Nano-Policy-DROID 初始化理解分支和视频分支,从头训练 10 亿参数的动作分支,并在 DROID 上使用约 4,000 GB300 GPU 小时训练模型,每 500 GPU 小时保存一个 checkpoint。
我们在 RoboLab 基准的全部 120 项任务上评估每个 checkpoint,每项任务运行 10 条 episode,并报告每次训练中表现最好的三个 checkpoint 的均值和标准差。
RoboLab 的 rollout 配置见附录 D.1。
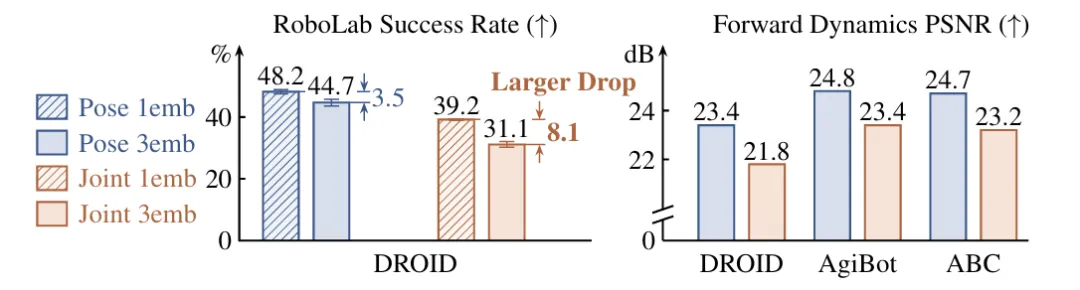
图 5:相机位姿是跨本体一致性更好的动作表示。 使用相同的模型,分别仅在 DROID 上训练(1emb),或在 DROID、AgiBot 和 ABC 上联合训练(3emb)。跨本体训练时,两种动作空间的成功率均有所下降,但关节空间策略的降幅是相机位姿策略的 2.3 倍。
动作表示。 我们在 CamX 中三个通过遥操作采集的数据集上,比较第 3.1 节介绍的相机位姿动作与关节位置动作:DROID、AgiBot-World 和 ABC-130k。
关节动作使用 7 维关节空间,所有机械臂共享一个 MLP 编码器;对于 ABC 中的 6 自由度 YAM 机械臂,其动作通过补零扩展到 7 维。
即使仅在 DROID 上训练,将相机位姿动作替换为关节动作也会降低 RoboLab 成功率,如图 5 所示,尽管基础 checkpoint 是使用关节动作训练的。
在跨本体训练中,我们从三个数据集中均匀采样,并使用三倍的计算量。加入另外两种本体后,两种动作空间在 DROID 上的成功率均有所下降,但关节空间策略下降了 8.1 个百分点,超过相机位姿策略降幅 3.5 个百分点的两倍。
在全部三个数据集上,Forward Dynamics 的 PSNR 结果也支持使用相机位姿。因此,相机位姿为不同本体提供了共享的动作空间,而关节动作需要针对每种本体分别学习。
发现 1: 对于策略学习,相机位姿作为跨本体动作表示优于关节空间,尤其是在异构机器人数据上训练时。
相机位姿编码。 我们比较了第 3.2 节介绍的视角识别方法。受双臂 UMI 中“夹爪间本体感觉”的启发,我们假设将相机位姿注入位置编码能够改善双臂协调。
为了验证这一假设,我们在 RoboLab 中使用双臂 YAM 配置构建了一个 Shared Grasp 任务:两条机械臂必须从两侧夹住一个箱子,将其抬起,并放到红色目标区域。目标区域的分布叠加显示在图 6 中。
所有策略均以两个腕部相机视角作为输入,并预测相对相机轨迹。如果不使用位姿信息识别视角,双臂放置箱子的精度会显著下降:在大多数 episode 中,箱子落地后接触到目标轮廓线,或超出轮廓线,成功率分别下降 22 和 19 个百分点。
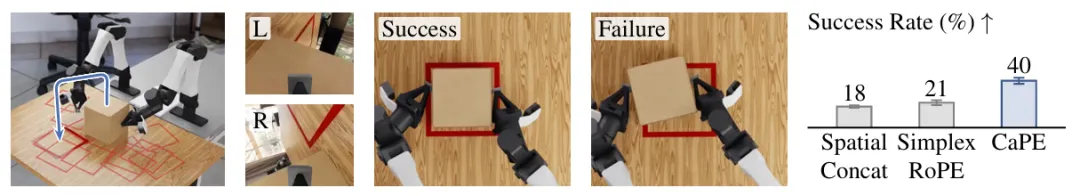
图 6:双臂协调——Shared Grasp。 两条机械臂共同搬运一个单个夹爪无法夹住的宽箱子,并将其放在随机生成的红色目标区域内;成功要求箱子的整个底面都位于轮廓线内。初始状态中,其他 episode 的位置以淡色显示。
发现 2: 根据相机位姿识别视角,既能支持灵活的相机数量——第 4.2 节中,同一个 checkpoint 可使用一至四个视角运行——也能改善双臂协调。
视频-动作训练目标。 我们在保持 4,000 GPU 小时预算和 batch size 不变的情况下,研究 UVA 模式的采样策略如何影响模型性能。令人意外的是,与仅使用 P 或仅使用 PP 进行训练相比,直接以相同概率采样五种 UVA 模式,会同时损害 P 和 PP 的性能,如图 7 所示。
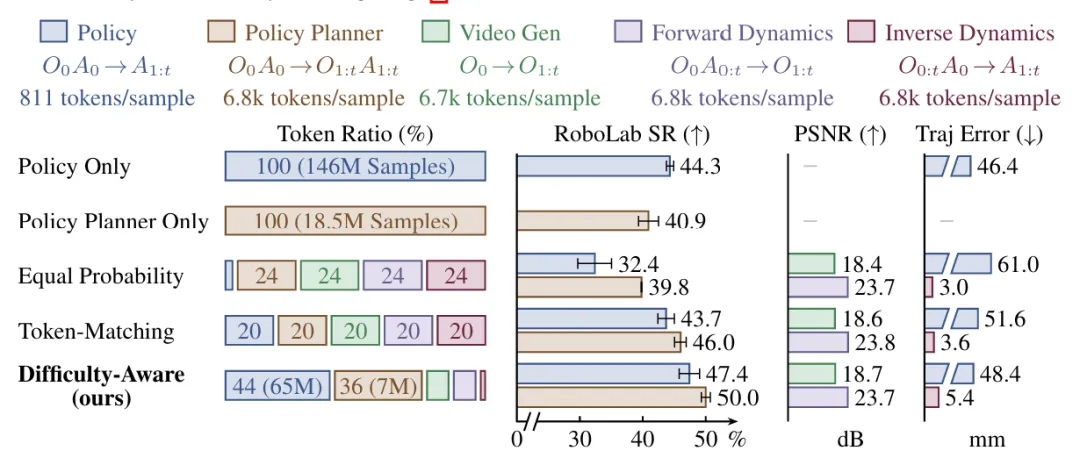
图 7:UVA 模式采样策略。 一个 Policy 样本只包含一帧观测,因此其 token 数量约为其他四种模式样本的 。提高 Policy 的采样比例,使其 token 数量与其他模式匹配(Token-Matching),可以恢复 Policy 的成功率;根据难度调整采样比例(Difficulty-Aware),则使 Policy 和 Policy Planner 的成功率均超过单模式训练,同时 Video Generation 和 Forward Dynamics 的 PSNR 保持不变。
我们发现了两个主要原因。
首先,Policy 样本只包含一帧观测,因此 token 数量少得多。在等概率采样下,Policy 样本所占的 token 比例远低于其他模式,导致性能不佳。提高 P 的采样比例,使其 token 数量与其他模式匹配后,P 的性能恢复到与仅使用 P 训练相当的水平,同时 PP 的性能超过了仅使用 PP 训练的结果。
其次,我们使用任务难度作为采样启发式:P 和 PP 需要进行与任务相关的规划,动作也可能是多模态的,因此我们优先采样这两种模式。我们为 VG 分配较少样本,因为 PP 同样需要预测未来视频;也为 FD 和 ID 分配较少样本,因为它们分别以动作为条件或以未来观测为条件。
这些额外条件可以降低不确定性,但在部分观测条件下,并不会使这两个任务中的任何一个变为确定性任务;这里的难度排序是一个设计假设。
采用手动调整的 Difficulty-Aware 采样比例 后,P 和 PP 的成功率均超过各自的单模式训练结果,同时 VG 和 FD 的 PSNR 与 Equal Probability 和 Token-Matching 策略下保持一致。ID 的轨迹误差略有增加,但仍比 P 的误差低一个数量级。
发现 3: 根据任务难度混合多个 UVA 训练目标,可以提高策略成功率,同时保持动力学建模能力。
模型 Scaling 研究。 为研究性能如何随模型规模变化,我们训练了一个 Cosmos3-Edge 变体:冻结的 13 亿参数理解分支、经过微调的 13 亿参数视频分支,以及从头训练的 5 亿参数动作分支,总计约 40 亿参数。其中,文本嵌入和视频编码器与 160 亿参数的 Nano 模型相同。
对于两个模型,我们将每次迭代的全局 batch size 从 100 万 token 调整到 1,600 万 token,并最多训练 4,000 GPU 小时。Nano 每 1,000 次迭代评估一次,Edge 每 2,500 次迭代评估一次。训练期间,两个模型的 GPU 利用率和功耗相近。
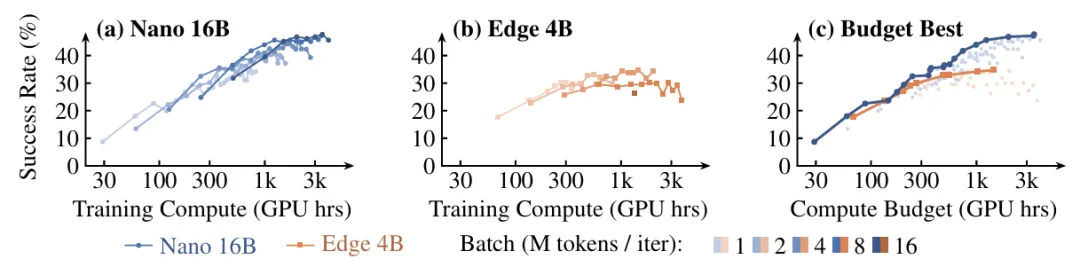
图 8:模型 Scaling 研究。(a)五次 Nano 训练和(b)五次 Edge 训练在 Policy 模式下的 RoboLab 成功率随训练计算量的变化;每条曲线对应一种全局 batch size。(c)在给定计算预算内,两个模型各自达到的最佳成功率;所有 checkpoint 以淡色点显示。
图 8a、b 展示了每次训练的 RoboLab 成功率随训练计算量的变化。160 亿参数的 Nano 模型达到饱和的速度比 40 亿参数的 Edge 模型慢得多,最终也取得了高得多的成功率。
较大的 160 亿参数模型在使用更大 batch 时,也达到了更高的峰值性能;较小的 40 亿参数模型则在 batch size 为 400 万 token 时达到峰值,在相同计算预算下继续增大 batch 没有带来收益。
在图 8c 中,我们将前两张图叠加,并标出了每个计算预算下表现最好的 checkpoint。在较低预算下,两个模型的性能相近;当预算超过 1,000 GPU 小时后,160 亿参数的 Nano 模型明显更强。
我们将这一优势归因于较大预训练 backbone 所具有的更强先验和更大容量:它们改善了语言 grounding 和任务泛化,而这两者对 RoboLab 评估都至关重要。
发现 4: 在较高计算预算下,较大模型优于较小模型,并且更适合使用较大的 batch;在较低预算下,较小模型性能相近,增加迭代次数更有利。
4.2 能够实现什么?——模型能力研究
采用第 4.1 节中的设计选择后,我们从 Cosmos3-Nano-Policy-DROID 初始化最终的 CamUVA 模型,并在 CamX 训练混合数据上训练 30,000 GB300 GPU 小时,详见附录 B.4。
由于所有机器人共享同一个以相机为中心的接口,并使用灵活的序列打包方式,这一个 checkpoint 无需任何针对特定本体的微调,就能控制具有不同相机视角的单臂、双臂和移动机器人。
此外,每个单任务基准数据集最多只占训练 token 的 1%,我们也没有进行任何针对特定任务的微调。本节所有评估均使用同一个 CamUVA checkpoint,并采用速度最快的 Policy 模式。
第 4.2.1 节评估分布内本体:机器人和夹爪与该任务训练数据中的配置完全一致。第 4.2.2 节评估跨本体表现,包括仅在其他任务中出现过的本体,即本体迁移;以及训练时未见过的本体,即零样本跨本体迁移。
4.2.1 分布内本体评估
我们在标准基准上评估最终的 CamUVA checkpoint,并与针对各个基准单独优化或训练的先进方法进行比较。
在仿真 RoboLab 基准中,我们将 CamUVA 与四个先进基线进行比较:两个在 DROID 上后训练的 checkpoint,即 Cosmos3-Nano-Policy-DROID 和 -DROID;以及两个跨本体模型,即 LAP-3B 和 Cloak。
我们在包含全部 120 项任务的完整基准上评估每个模型,每项任务运行 10 条 episode。rollout 配置、运行次数和不确定性估计详见附录 D.1。
结果: 在 P 模式下,CamUVA 的延迟为 0.15 秒,详见附录 B.1。它的成功率比表现最好的跨本体基线高 32 个百分点,速度也远快于仅支持 PP 模式、延迟为 2.6 秒的 Cosmos3-Nano-Policy-DROID。
这表明,经过跨本体训练后,模型仍保有较强的任务泛化和指令遵循能力。
图 9:CamUVA 在分布内本体上的表现。 所有评估均使用同一个 CamUVA checkpoint,且未针对基准进行专门的后训练。括号中标明各任务使用的夹爪本体,以及对应数据占 CamUVA 训练 token 的比例。RoboLab 图中误差线的定义见附录 D.1。
在真实世界中,我们使用标准单臂 UMI 配置测试 CamUVA。评估场景根据 UVA 的设置进行调整,并与 UVA 在原始评估集上报告的结果进行比较。
我们还在相同的非受控环境中、使用相同的物体,分别测试 CamUVA 和 ABC-VLA 在双臂 YAM 上的表现。此外,我们在移动机器人 RB-Y1 上运行 CamUVA,并将其成功率与 ModPack 报告的结果进行比较。
所有基线都是针对相应任务训练的本体专用模型;CamUVA 则是一个统一的跨本体模型,且这些基准数据集各自最多只占 CamX 训练 token 的 1%,如图 9 所示。
结果: 在 Cup Arrangement 和 Towel Folding 任务上,CamUVA 优于多任务 UVA 和 Diffusion Policy 专用模型。尤其是,CamUVA 能够从自身错误中恢复,而这些任务的示范数据中并不存在这种行为,详见附录 E.5。
在 Dish in Rack 任务中,CamUVA 在未见过的环境中连续放置两个盘子,成功率为 ;ABC-VLA 能够拿起盘子,但在分布外环境中难以完成放置,详见附录 E.4.1。
在 Box Placement 任务中,CamUVA 预测相机轨迹,并将其传递给 HoMMI 基于逆运动学的全身控制器,详见附录 E.3。其成功率与 ModPack 报告的全相机、无力矩输入的关节空间 Diffusion Policy 相同,均为 30%;低于使用关节力矩的版本,后者成功率为 60%。
发现 5: 在 CamX 混合数据上训练的策略可以直接部署到多种训练中出现过的本体上,其性能能够与针对各个基准专门优化或后训练的先进模型相竞争。
4.2.2 跨本体评估
我们评估 CamUVA 开箱即用的本体泛化能力。机械臂运动学差异可以通过以相机为中心的动作表示直接抽象掉;与之不同,夹爪和相机的差异需要跨本体模型自身具备泛化能力。
具体而言,我们在四种不同任务上测试 CamUVA,每种任务的数据都使用一种特定本体采集:
UMI 数据中的 Water Pouring;
iPhUMI 数据中的 Cup Flipping;
GenRobot V4 任务集中的 Cup in Box;
DROID 和 RoboMIND 数据集中使用 Robotiq 夹爪采集的 Banana in Pan。
对于每项任务,我们使用同一个 checkpoint,在五种不同本体上进行评估:其中三种出现在 CamX 中,分别是 UMI、iPhUMI 和 GenRobot;另外两种在训练中未见过,分别是配备 iPhone 相机的新夹爪,以及配备 RealSense 相机的 UMI 夹爪。
在训练数据中,UMI 夹爪只与 GoPro 和 iPhone 相机配对使用。所有配置均安装在同一台 ARX5 机械臂上。
因此,图 10 中的每根柱子对应以下三种情况之一:用于采集该任务数据的本体,即作为参考的分布内本体;在 CamX 中出现过、但从未执行过该任务的本体,即本体迁移;或者训练中未见过的本体。
每根柱子对应 10 条评估 episode,使用不同的背景、物体和位置,以测试策略的鲁棒性。
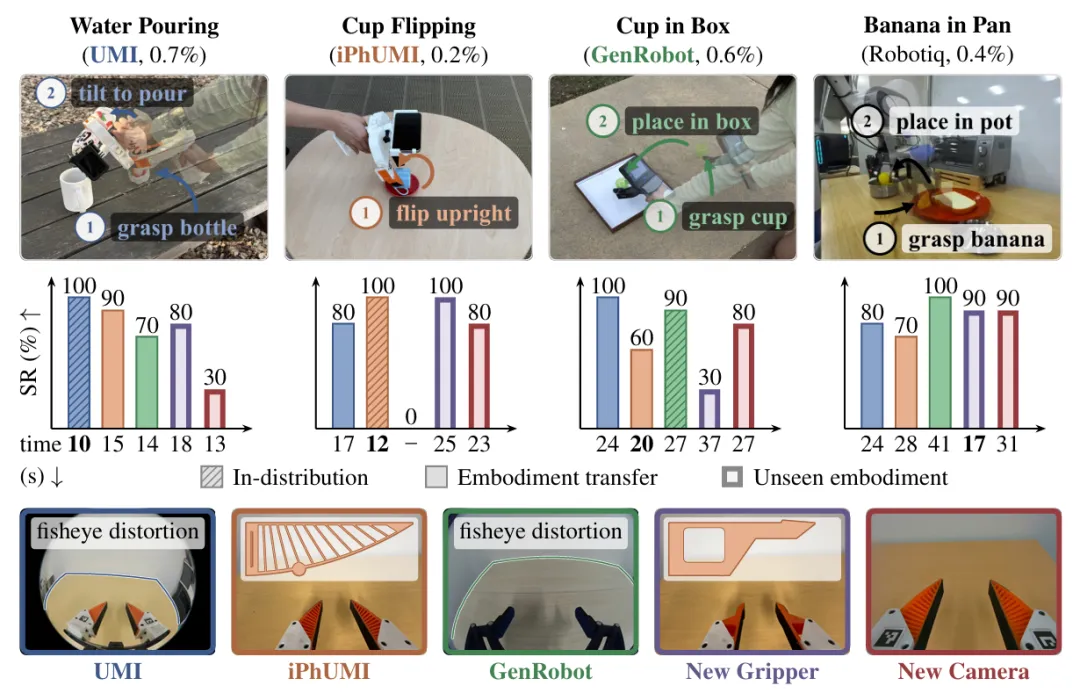
图 10:跨本体任务结果。 上方:四项任务、采集各任务数据时使用的夹爪本体,以及该任务数据占训练 token 的比例。中间:每项任务在不同本体上的成功率;每根柱子下方为成功 episode 的平均完成时间。下方:各本体的腕部相机视角。
结果: 在每项任务对应的分布内本体上,CamUVA 均表现良好,且完成时间通常更短。
在跨本体评估中,我们发现有两个因素最为重要:夹爪形状和相机类型。
相似的夹爪形状意味着夹爪与物体之间具有相似的交互动力学。UMI 和 iPhUMI 使用完全相同的夹爪手指,因此在彼此的任务上都表现良好;GenRobot 夹爪的形状与 Robotiq 最为接近,因此在 Robotiq 任务上表现最好。
相似的相机类型——透视相机或鱼眼相机——能够改善模型的空间估计。GenRobot 和 UMI GoPro 都使用鱼眼相机,因此尽管两者的夹爪外观完全不同,它们在彼此的任务上仍表现良好。
另外三种受测本体以及 Robotiq 均使用透视相机,因此它们之间的跨本体成功率也更高。
最大的本体差异出现在 iPhUMI 和 GenRobot 之间:两者的夹爪形状和相机类型都不同。GenRobot 夹爪在 Cup Flipping 任务中全部失败,原因是空间估计和动力学估计存在误差,详见附录 E.4.2。
发现 6: 使用统一的相机动作空间进行跨本体训练后,在一种本体上学习到的任务知识能够迁移到训练中出现过的其他本体以及未见过的本体上,并取得较高成功率。相似的夹爪形状和相机类型有助于提高迁移能力。
5 结论
当 2 万小时的开源机器人示范数据共享一个以相机为中心的接口后,就可以用于训练同一个模型。CamX 将 37 个数据来源转换为相机轨迹和通过位姿识别的视角;CamUVA 则无需任何机器人专属模块即可处理这些数据。
相机位姿动作、根据难度混合 UVA 训练目标,以及基于位姿的视角识别,均对性能有影响;将计算量用于更大的 backbone 仍是最主要的性能提升手段。
在 CamX 混合数据上训练得到的单个 checkpoint 能够在多种本体上运行,性能可与专用策略相竞争,并且无需新数据,就能将任务知识迁移到未见过的夹爪与相机组合上。
来源:human five