如果机器人学习有族谱,那就是 RoboLineage
——一条可追溯的进化链
教机器人一项新技能,常常要来回做很多轮:采集示范、训练模型、上机测试,再根据结果继续调整。每次测试留下的视频、每轮训练用过的数据、每个模型版本,都可能影响下一步怎么做。
可在实际工作中,这些信息往往分散在不同人的记录和不同工具里,上一轮为什么这样做,未必能完整地带进下一轮。
忆生科技联合香港大学等机构提出 RoboLineage,让智能体(agent)按一套共同的工作标准,组织和推进机器人学习的完整流程,并把每一轮的证据、判断与结果留给后续工作使用。
相关论文已被机器人学习国际会议 CoRL 2026 收录。
让智能体接手整套学习工作
采集、审查和训练常常由不同的人负责。什么算完成任务,哪些记录可以用于训练,下一轮该补哪些场景,都有赖于各自的经验。同一段执行,有人关注动作是否完成,有人更看重最后的结果;换一位操作者,判断和记录的方式也可能跟着变。团队需要反复对齐这些约定,才能把工作接下去。让智能体接手这套工作,能够减少人工在不同工具和环节之间反复整理、确认的时间。更重要的是,整套流程可以遵循共同的工作标准。智能体结合执行画面、任务要求和历史记录理解当前情况,再调用数据处理、训练和评估工具,接续完成各阶段的工作。
RoboLineage 将这一思路贯穿完整流程:从机器人与任务接入,到采集组织、数据审查、训练准备,再到模型版本管理、评估和下一轮安排。
每个智能体都要明确自己负责什么、读取哪些输入、交付什么结果;做出判断时,要留下依据,也要说明不确定之处。结果经过检查,才能交给后续环节。
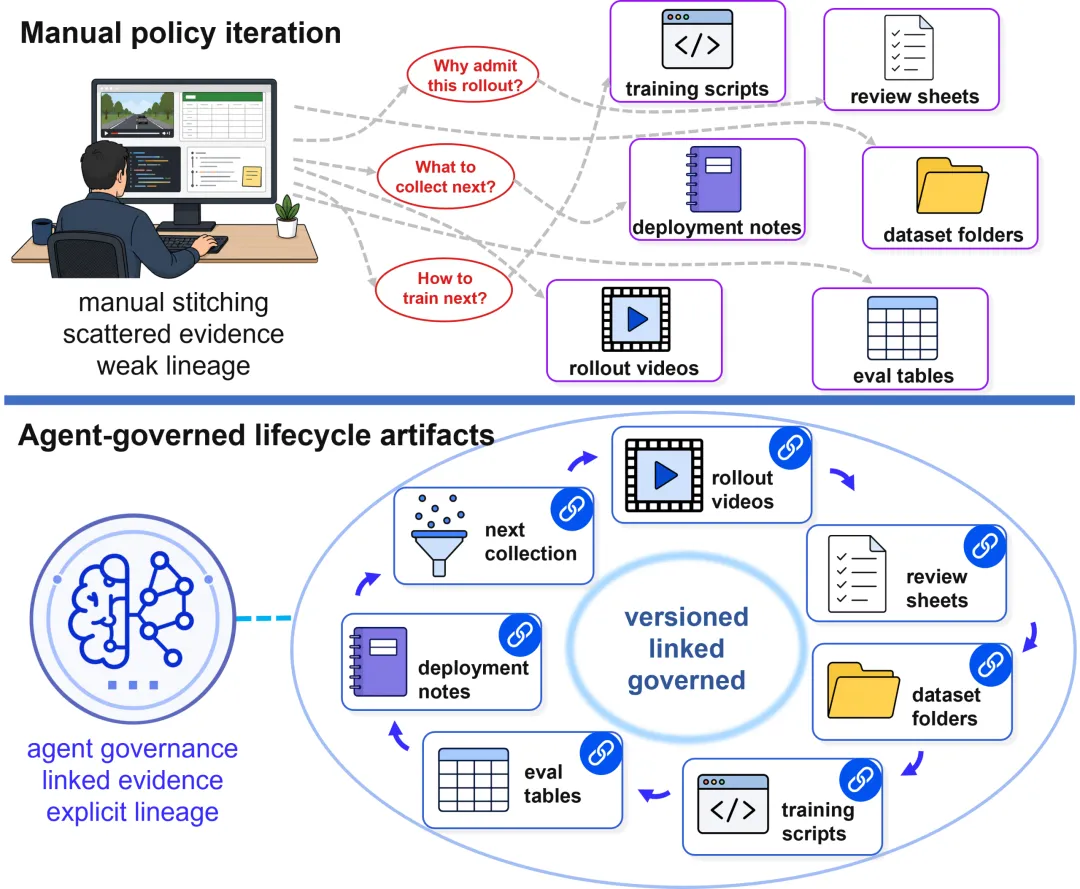
▲图1 | 论文Teaser©【深蓝具身智能】编译
有了这样的约定,不同任务仍然可以保留各自的成功条件,不同机器人和学习器也可以使用各自的配置与适配方式。
同时,判断依据怎样记录、数据怎样获得训练资格、训练结果怎样对应到模型版本,都有一致的处理方式。
 Lineage 把每一步工作连成记忆
各阶段有了共同的标准,还需要知道彼此做过什么。审查结果要能找到对应的执行,数据选择要能找到审查依据,训练、模型和评估也要连在一起。
RoboLineage 把这些工作连成持续更新的工作状态,供各阶段的智能体读取、更新,并带入后续轮次。
这正是名字中 lineage(谱系)的含义:一项结果从哪里来,经历过哪些处理,又影响了什么。
沿着这些联系,可以从一个模型找到对应的训练数据,再找到数据来自哪次执行、为什么获准训练;也可以从一次测试失败,回看当前模型的训练背景和此前的改进过程。系统总览呈现了各环节的衔接,图中的百分比仅作流程示意。
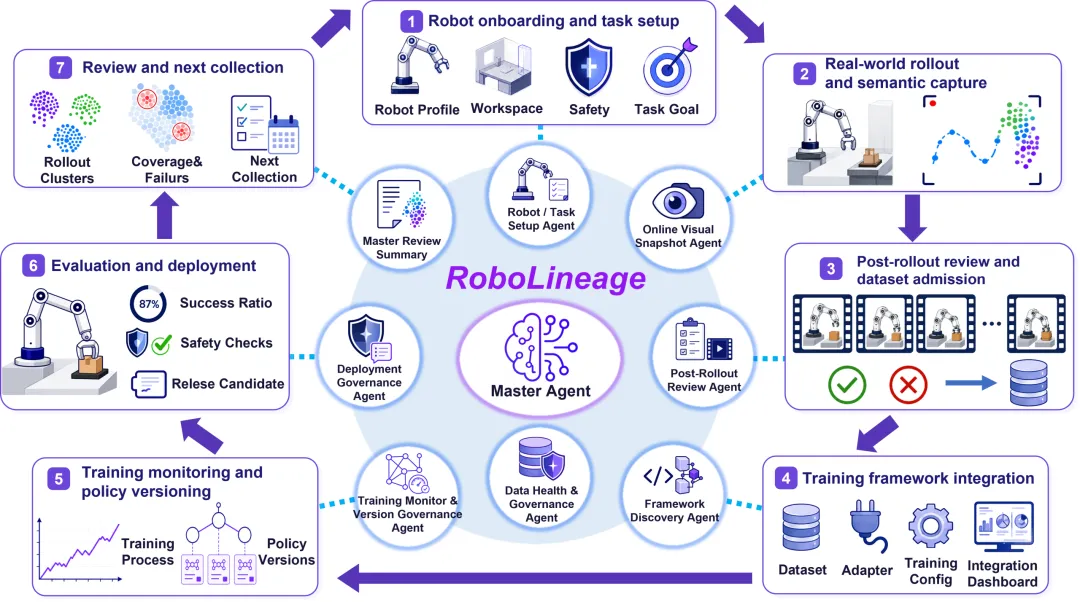
▲图2 | 论文系统主图©【深蓝具身智能】编译
这些联系也决定了后续工作怎样继续。
每轮训练前,系统固定所选数据和相关配置;训练得到的模型,与本次输入、训练记录及它所继承的模型版本关联起来。数据转换为另一种学习器需要的格式时,仍保留与原记录的联系。测试结果再与对应模型关联,成为判断下一步的依据。
Master Agent 在此基础上汇总当前状态和此前历史,整理待解决的问题,形成下一步建议。
各阶段共享的这段学习经历,也就形成了 RoboLineage 的“记忆”:前面的判断和结果,能够继续被后面的工作使用。
 从一次执行,到可用的训练数据
具体到一次操作,首先要回答的是:这段数据是否值得用于训练。
以叠积木为例,机器人已经把积木搬到目标上方,释放时仍可能滑落。中途看起来顺利,最后几帧却可能改变审查结论。判断一段执行,需要同时理解任务标准、执行过程和最终状态。
RoboLineage 将执行记录的处理安排在三条线上。原始画面和机器人状态持续采集;在线视觉快照智能体(VSA)标记关键动作和风险;本次采集及在线处理结束后,异步审查再结合关键片段、最终状态和前后过程进行复核。
模型响应较慢时,原始采集仍照常进行,异步审查也可以与后续采集重叠。
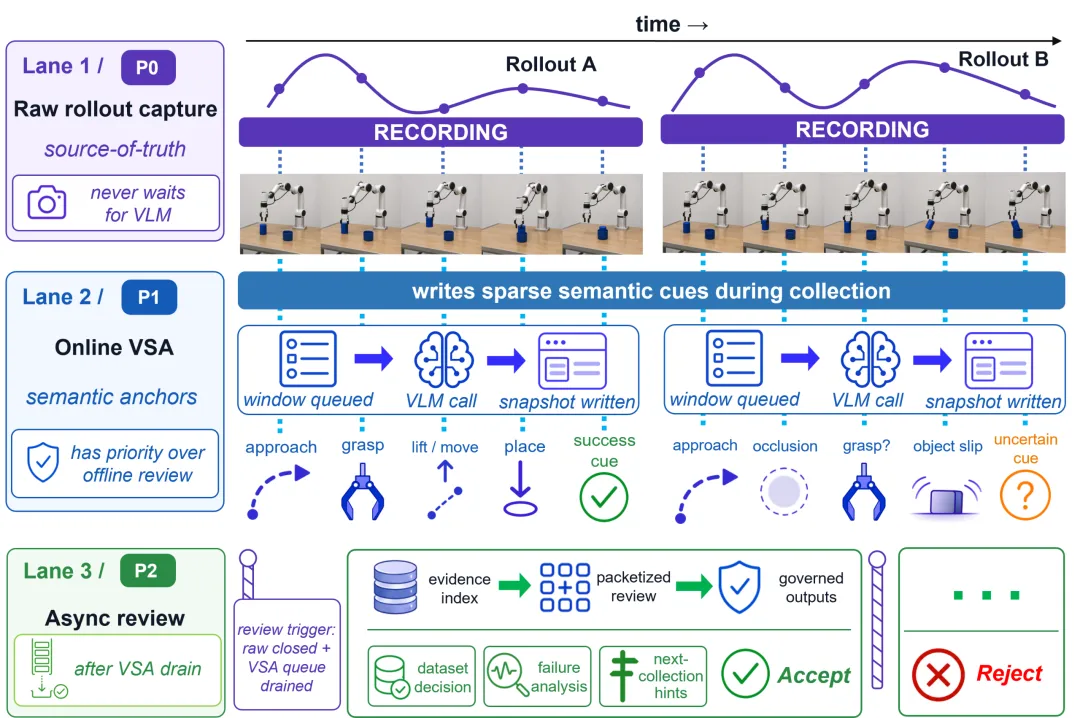
▲图3 | 论文三线机制©【深蓝具身智能】编译
执行结果与数据用途分别处理。
审查留下结论和证据,数据治理再按任务规则决定是否纳入训练。证据不清楚的记录交给人工复核;有诊断价值的失败可以留在失败池,用于分析缺口和安排补采。这样,一次失败也能为后续学习留下有用的信息。
同样的工作标准延续到训练和评估。
智能体检查既有学习器需要的数据格式,准备适配信息,跟踪训练与模型版本,再整理测试结果。策略训练仍由已有的学习器完成,流程中的选择、输入和结果则在 lineage 中保持关联。
操作员通过前端查看这些工作:回看执行画面,检查审查引用的证据,复核或修改数据用途,以及准备训练、比较模型和查看补采建议。人工确认及修改也会留下记录,后续智能体据此继续工作。界面预览中的实时画面区域以占位图呈现。
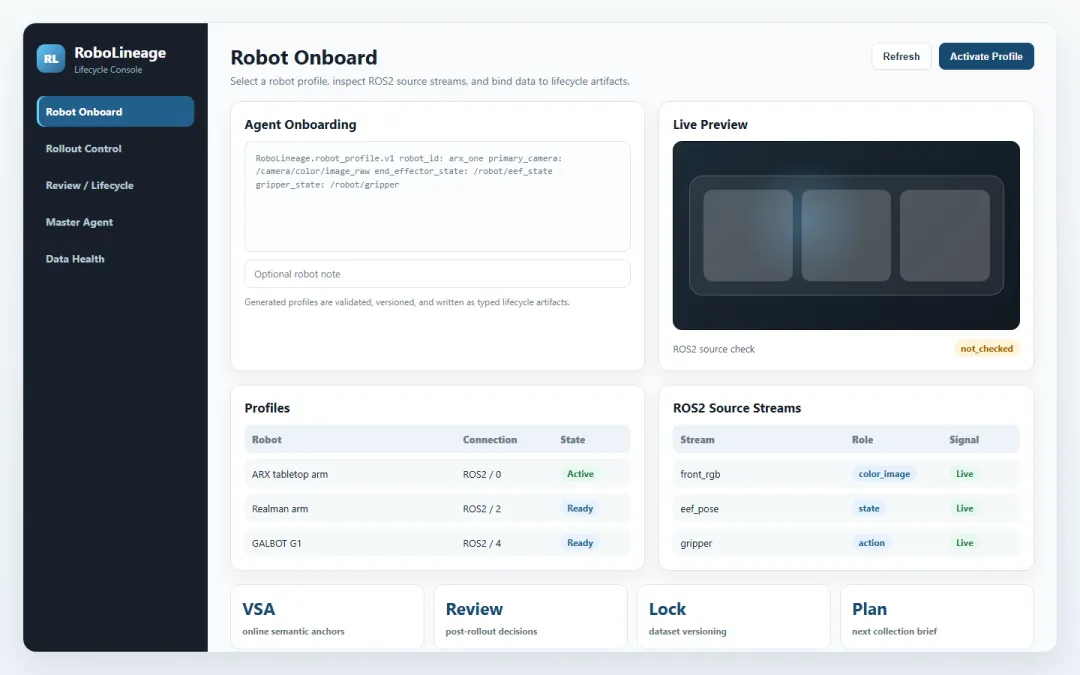
▲图4 | 操作员工作台©【深蓝具身智能】编译
 共同的流程,怎样在真实任务中检验
论文在三组机器人与既有学习器上检验这套流程:ARX 上的 ACT 风格策略、Realman 上的 Diffusion Policy,以及 GALBOT G1 上的 VLA/LeRobot 风格工作流。
任务涉及抓取、放置、容器操作和抽屉开合等场景。
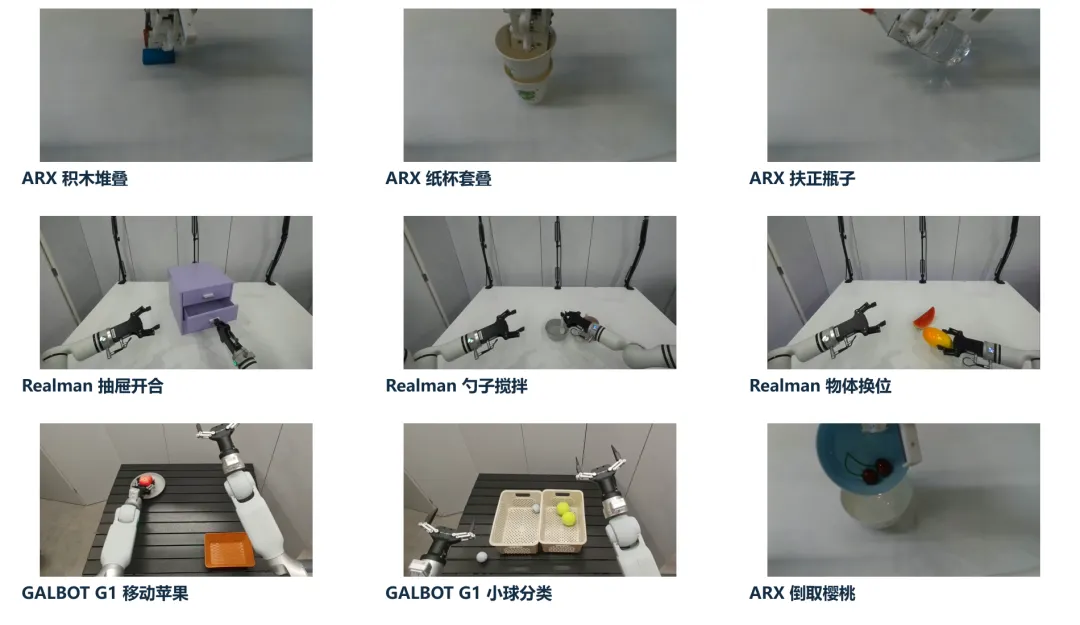
▲图5 | 真实任务九宫格©【深蓝具身智能】编译
首先需要检验的是,系统能否可靠地判断数据用途。
在 25 个任务、500 条执行记录的基准上,按操作员修改前的结果,完整系统对数据使用去向的判断与专家共识的一致率为 96.4%,直接视频审查对照为 79.6%。在专家判定应拒绝的 194 条记录中,误纳入主训练集的比例由 16.0% 降至 2.1%。两种方法使用相同的执行记录和审查模型。
证据怎样组织,也会影响判断。
仅约束输出格式时,误纳入比例为 11.3%;去掉对最终观察和终末状态的重点检查,比例为 6.2%;把视觉快照与原始帧合并为一次审查、取消分包处理,比例为 4.6%。完整系统为 2.1%。这些消融结果支持了流程中证据处理方式的作用。
判断可靠之后,再看日常迭代需要多少人工投入。
完成机器人和训练框架接入后,12 组配对实验每轮处理 30 条执行记录。训练前需要人工投入的时间由平均 130.2 分钟降至 54.3 分钟,减少约 58.3%。物理采集时间基本相同,节省主要来自审查、准入整理和训练准备。这一测量包含实际操作和阻塞等待,不含一次性硬件接入、适配器开发调试及 GPU 训练时间。
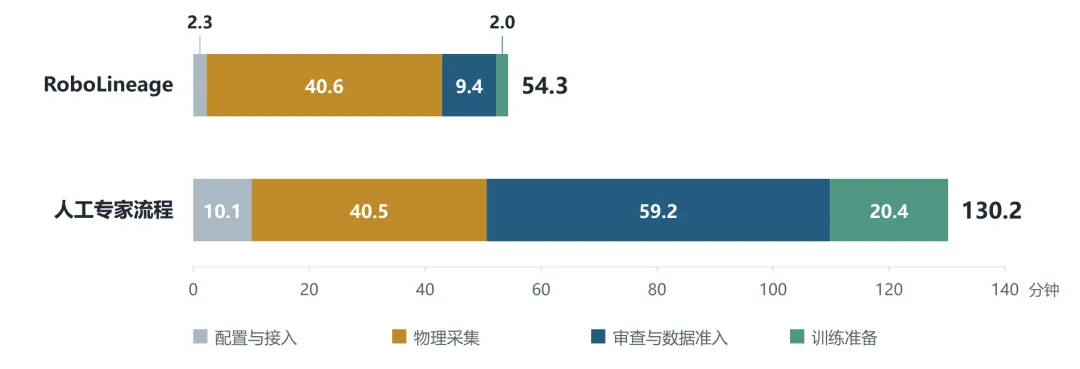
▲图6 | PPT15人工时间对比©【深蓝具身智能】编译
整理出的数据还需要支撑后续训练。
在 8 个任务上,每个任务使用同一批 100 条候选记录,两种流程各选 60 条示范,采用相同训练设置,并各测试 60 次。人工专家流程与 RoboLineage 流程的平均成功率分别为 93.1% 和 92.7%。在这些设置下,减少例行人工投入的同时,训练得到的策略表现与人工专家流程接近。
 让已有经历帮助下一轮学习
一轮流程顺利完成之后,还有一个更长远的问题:此前的经历,能否让下一轮学习少走些弯路?
当前失败说明模型还差在哪里,前几轮的记录则能告诉系统,哪些场景补过数据,模型随后有哪些变化,还有什么问题没有解决。智能体将这些信息一起用于下一轮采集安排。
积木堆叠的例子展示了这种变化。
最初,失败集中在覆盖不足的起始位置,需要补充这些位置的成功抓取示范。抓取改善后,机器人又会在放置尚未稳定时提前松手,补采重点便转向对齐、停稳和释放。再往后,剩下的困难变成夹爪迟迟不松开,需要补充及时释放和干净撤离的示范。
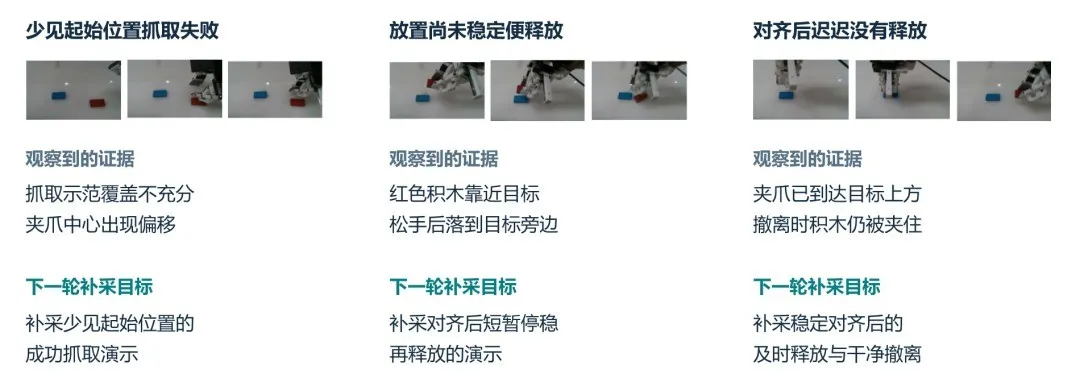
▲图7 | 失败到补采©【深蓝具身智能】编译
研究在积木堆叠和开抽屉两个任务上检验闭环补采。各方法分别进行三次独立运行,每次三轮;每轮增加 30 条获准训练的示范,并用 30 次诊断测试分析失败。三轮后,每次运行再对最终策略进行独立的 60 次测试。
其中,一个对照在补采规划时“仅使用本轮信息”:同样保留当前轮的视觉快照、结束后审查和数据覆盖摘要,但不读取此前补采计划、历史数据状态及此前模型的评估结果。按三次独立运行的最终测试均值,积木堆叠上,该对照与 RoboLineage 的成功率分别为 70.0% 和 83.3%;开抽屉上分别为 66.7% 和 78.9%。
实验还比较了随机补采、按失败阶段补采等方法,并以人工专家指导作为参照。在这两个任务中,跨轮历史帮助系统选择了更有效的补采方向。
▲图8 | 闭环补采结果©【深蓝具身智能】编译
让学习过程本身能够积累目前,论文在三组已配置的机器人与学习器上评估了审查和例行流程,并通过两个任务检验了定向补采。操作员仍参与不确定情况的复核和关键决定的确认;跨任务经验迁移与长期自主运行还需要进一步验证。
随着机器人学习的任务增多、迭代加快,怎样组织这一过程,也会成为能力提升的一部分。
RoboLineage 让智能体按共同标准接续整套工作,lineage 则把每次判断与相关数据、模型版本联系起来。
一次迭代结束,留下的依据、选择与结果仍能参与下一次学习。机器人在继续学,教它的过程也能积累经验。
论文题目:RoboLineage: Agent-Native Data Lifecycle Governance Across Robot Policy Iterations(CoRL 2026 收录)
作者:Qian Luo、Wentao Guo、Zhennan Qin、Nanchun Guo、Yunhan Zhao、Yi Ma、Yanchao Yang
机构:忆生科技(TranscEngram)、香港大学(The University of Hong Kong)、北京理工大学(Beijing Institute of Technology)
论文链接:https://arxiv.org/abs/2606.22142
项目主页:https://robolineage.github.io/
来源:深蓝具身智能