具身Scaling law + Zero Shot零样本泛化:不靠语言,用目标图片指挥机器人完成长时序操作
——Open-HumanWAM
人类视频预训练不缺概念验证,缺的是可复现的规模证据和可比较的路线。来自北京大学 DAGroup 等团队提出的 Open-HumanWAM 没有继续论证“人类视频有没有用”,而是把问题往前推了一步:怎么用、用多少、和机器人数据怎么配。
它的第一步是搭数据底座:把大规模人类第一视角视频整理成机器人可学习的数据。难点不在“喂视频”,而在跨越人手与机械臂的结构差异——从人类视频里提取可迁移的操作规律,再转换成机器人自己的动作。
为此,研究把迁移问题拆成两条相互衔接的路线:
HumanWAM-Vanilla 只用人类视频预训练,检验“只看人类怎么做”能把机器人学到什么程度;
HumanWAM-Goal 则进一步引入机器人数据联合预训练和视觉目标条件,让机器人根据一张目标图片决定如何操作。
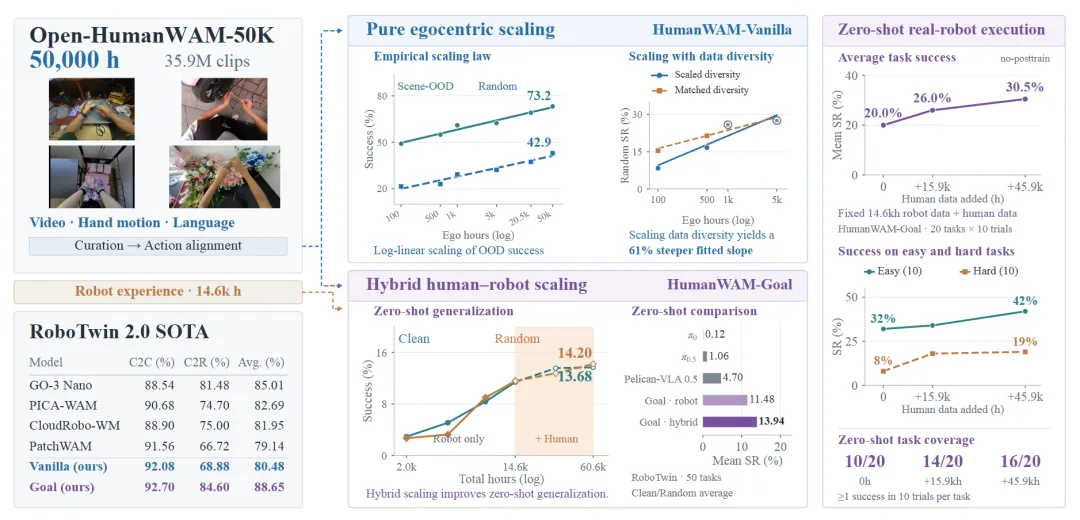
▲图 | Open-HumanWAM 的整体研究路线:先利用大规模人类第一视角视频学习通用操作经验,再通过机器人数据适配具体身体;进一步地,HumanWAM-Goal 将人类与机器人经验联合起来,并加入视觉目标,让策略能够根据希望达到的结果调整动作。©【深蓝具身智能】编译
5万小时的人类视频,先要整理成机器人能学的样子
团队首先构建了 Open-HumanWAM-50K 数据集,整合了五类公开的人类第一视角数据来源。经过筛选后,数据规模达到约 5 万小时,包含约 3590 万段连续视频片段,并配有人类手部运动信息和语言描述。数据覆盖家庭、商业服务和工业等不同操作场景。
这里最重要的工作不是简单“把视频拼在一起”,而是清理和对齐。
首先,视频里必须看得到正在操作的手。如果手完全不在画面中,模型就很难把看到的物体变化和具体手部动作联系起来。
其次,手部和摄像头的运动轨迹要足够稳定。原始数据中的姿态估计可能突然跳变,团队会检查位置、加速度、抖动以及相机运动,剔除不可靠片段。
最后,还要去掉长时间没有实际操作的画面,避免模型把大量训练资源浪费在静止场景上。
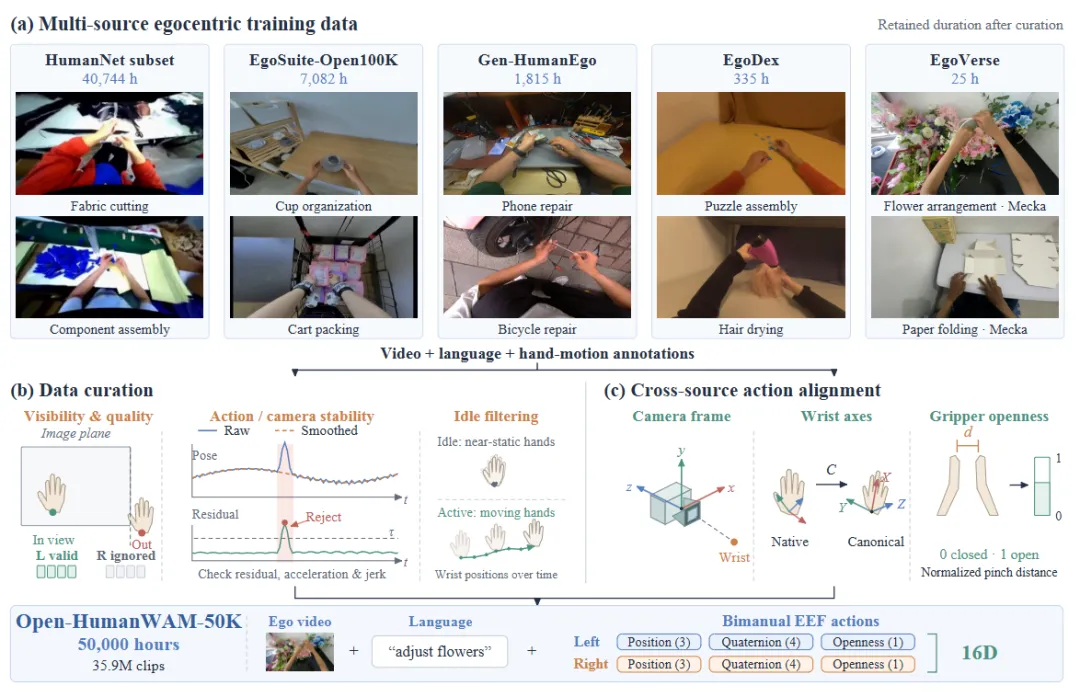
▲图 | Open-HunnanWAM-50K 将来自不同来源的人类第一视角视频整理为统一的训练数据:先筛选出手部可见、确实发生操作且运动轨迹可靠的片段,再统一手部运动表示,并配上语言描述。这样,视频中的动作过程才不只是可观看的画面,而成为模型能够学习和对齐的操作经验。©【深蓝具身智能】编译
更关键的是,不同数据集对“手怎么动”的记录方式并不一样。有人记录手腕位置,有人记录手部关键点,还有的数据使用不同的坐标系。
研究把它们统一到一个双手末端执行器表示中:每只手用位置、朝向和开合程度描述。
这样做不要求人手和机器人拥有相同的关节结构,而是让两者都能用“手移动到哪里、朝向怎样、张开还是闭合”来表达操作。
这一步可以理解为给不同身体建立一套共同的动作语言。
人类手腕和机器人夹爪不必长得一样,但它们都可以表达“向前移动一点”“转向某个角度”“张开或合拢”。有了这个接口,人类演示才有机会和机器人演示一起参与训练。
只看人类做事,机器人能学到多少?
有了数据,团队首先研究一个相对直接的问题:
如果预训练阶段完全使用人类第一视角视频,之后再用机器人演示进行适配,机器人能不能因此学得更好?
这条路线对应 HumanWAM-Vanilla。
模型以视频和动作共同建模为基础,在人类视频中学习手部运动与场景变化之间的关系。随后,研究人员再用机器人演示进行后训练,让模型适应具体机器人的身体和控制方式。
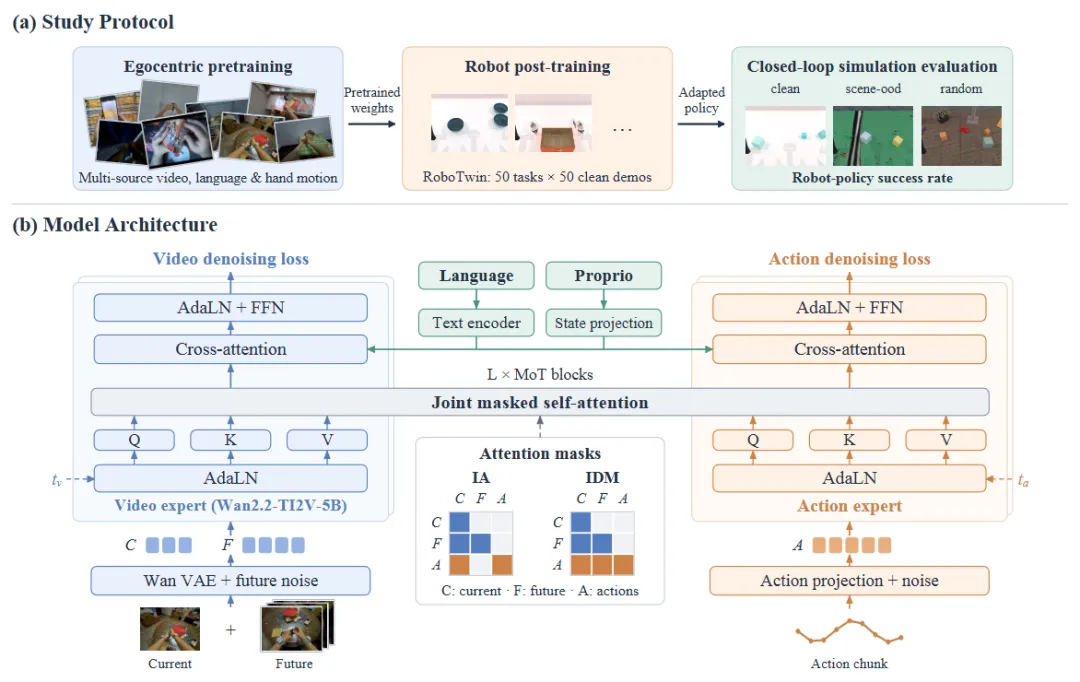
▲图 | HumanWAM-Vanilla 采用“先看人类操作、再适配机器人”的训练流程:模型先从人类视频、语言和手部运动中学习操作先验,随后使用机器人演示进行任务适配,最后在不同场景条件下进行闭环评估。©【深蓝具身智能】编译
为什么不直接把人类视频当作机器人演示?
因为人类手部动作和机器人动作并不完全相同。人类视频更适合提供广泛的操作先验,例如物体通常怎样被抓取、手从哪个方向接近、完成一项操作通常经历哪些阶段;机器人演示则负责告诉模型,当前这台机器人应该怎样实现这些动作。两种数据承担的任务并不一样。
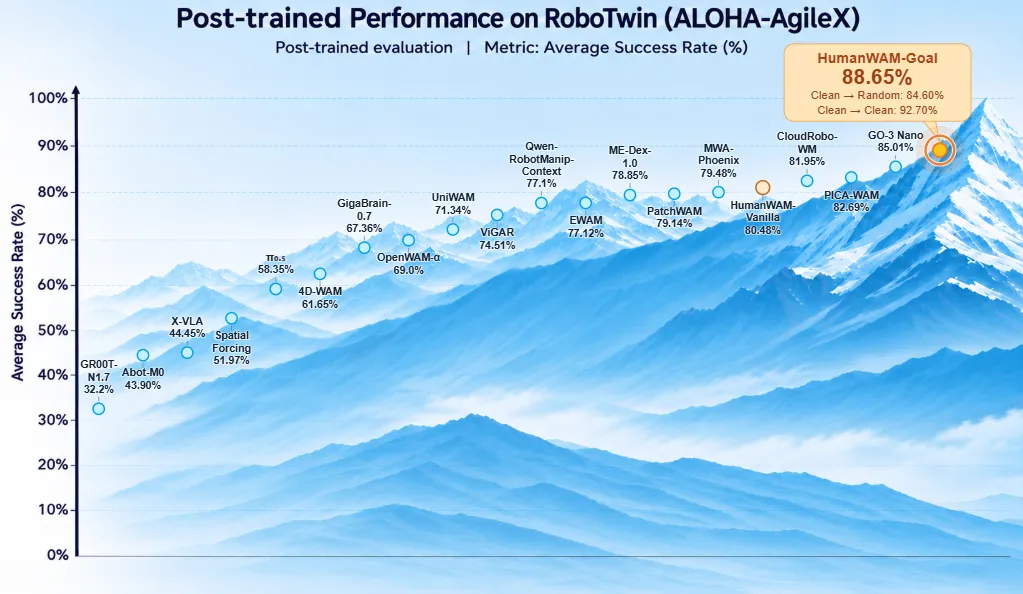
在最终模型结果中,HumanWAM-Vanilla 经过机器人后训练后,在 RoboTwin 2.0 的 Clean2Clean 设置下达到 92.08%,在 Clean2Random 设置下达到 68.88%。
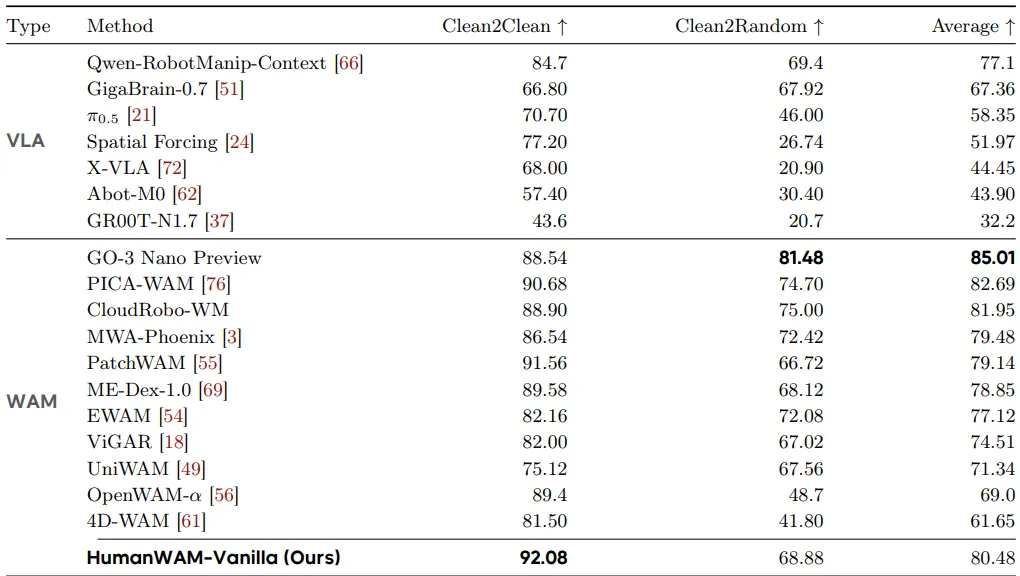
▲图 | 在RoboTwin2.0上的评估结果。©【深蓝具身智能】编译
研究也在 RoboTwin 2.0 中比较了不同规模的人类视频预训练。
结果显示,随着人类数据从较小规模扩大到 5 万小时,模型在训练环境之外的表现有明显改善。尤其当背景、桌面纹理、物体摆放和光照发生变化时,经过大规模人类视频预训练的模型更能适应新环境。相反,在与训练数据非常接近的场景里,提升并没有那么明显。
这说明人类视频带来的价值,不只是让机器人把已经见过的动作做得更熟练,而是帮助它接触更多物体、场景和操作方式,从而在环境变化时不那么容易失效。
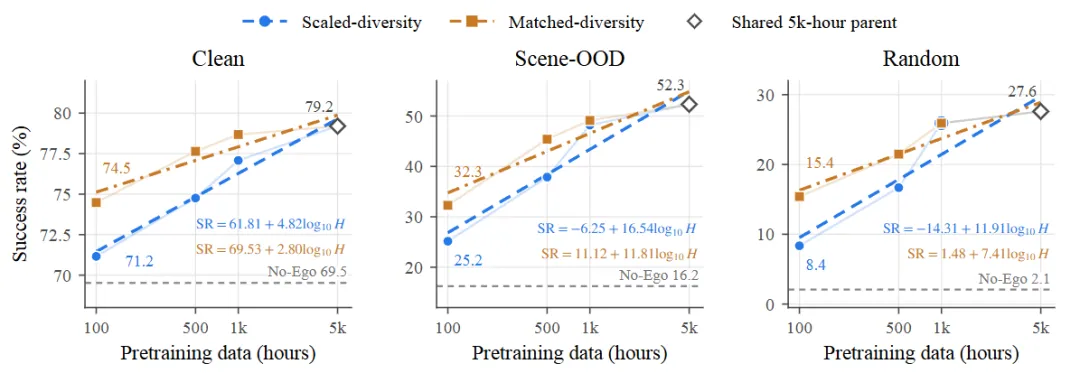
▲图 | 随着人类第一视角预训练数据增加,模型在训练场景之外的表现也逐步改善。尤其当桌面、背景、光照和物体摆放发生变化时,更多样的人类操作经验能帮助机器人更好地适应陌生环境。图中不同数据扩展方式也说明,增加任务与场景覆盖,比单纯重复采集相似片段更有利于迁移。©【深蓝具身智能】编译
研究还专门比较了数据多样性。
研究者构造了不同的数据扩展方式:一种主要增加视频时长,但任务和场景覆盖相对固定;另一种在增加时长的同时,也不断扩大任务和场景范围。结果显示,后者带来的泛化收益更明显。
换句话说,让机器人看更多重复内容,不如让它看到更多不同的人、物体和操作场景。

▲图 | zero-shot 鸡蛋和球,分别入碗
从“看人做事”到“看图完成目标”,机器人还需要什么?
HumanWAM-Vanilla 证明了人类视频可以帮助机器人学习,但它仍然需要机器人后训练。
团队接着提出 HumanWAM-Goal,希望把人类和机器人经验结合起来,让模型在面对新目标时更灵活。
它最直观的变化,是增加了一张目标图片。
过去,机器人通常需要通过语言指令知道要做什么,例如“把笔记本放进右边的槽位”。
但语言描述有时很难准确表达物体之间的位置关系。目标图片则可以直接展示任务完成后希望看到的状态:笔记本应该在哪里,瓶子应该朝哪个方向,物体之间应该是什么相对位置。
模型同时接收当前观察、语言指令、机器人状态和目标图像,然后预测未来的视觉变化与动作。目标图像告诉它“最后应该变成什么样”,当前画面告诉它“现在是什么情况”,而模型需要生成两者之间的操作过程。
这也是 HumanWAM-Goal 与单纯模仿视频的区别:它不只是复现一段人类做过的动作,而是尝试根据目标状态调整行为。同一个策略面对不同的目标图像,可以采取不同的操作方式。
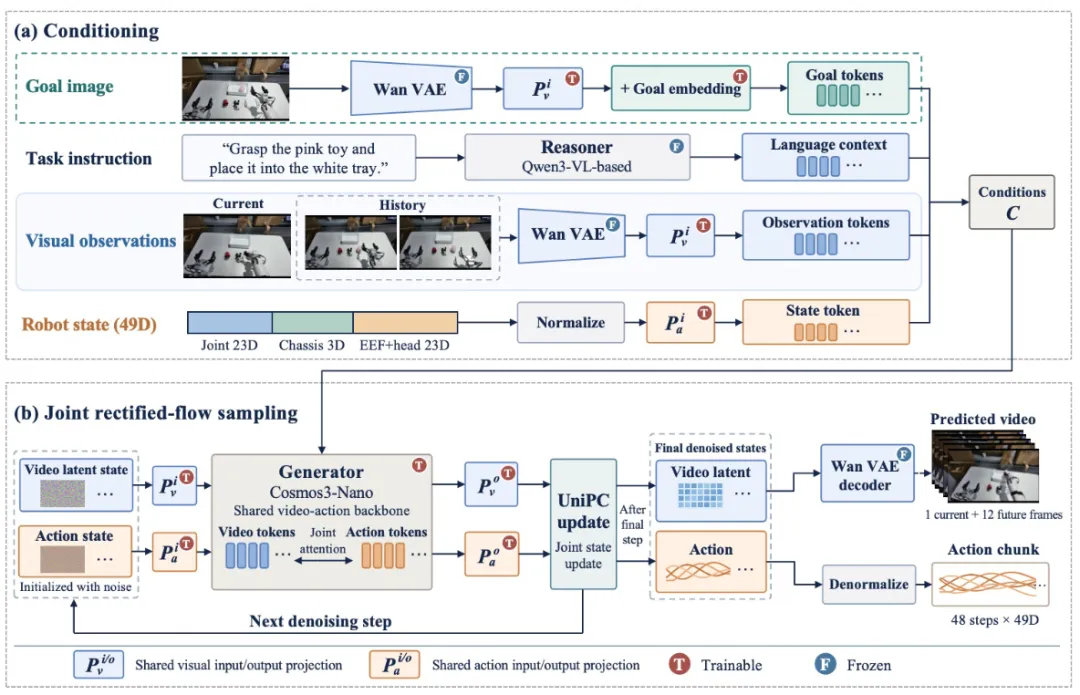
▲图 | HumanWAM-Goal 将语言指令、当前观察、机器人状态和目标图片一起作为条件,联合生成未来的视频变化与机器人动作。目标图片负责描述“最后要变成什么样”,动作预测则负责给出从当前状态走向目标状态的执行过程。©【深蓝具身智能】编译
要做到这一点,人类和机器人数据必须进一步融合。
研究为不同机器人建立了统一的动作接口,把双手末端执行器运动、夹爪开合以及机器人底盘等信息纳入混合表示。人类视频能够提供手部操作经验,机器人数据则补上真实机械结构、控制方式和身体状态。
两者一起训练,模型才有机会把“人类会怎么做”转化成“这台机器人可以怎么做”。

▲图 | 机器人先盖好杯盖,再依据人类目标图,把杯子送到显示器附近或文件架旁。
机器人真的能把人类经验用起来吗?
HumanWAM-Goal 在 RoboTwin 2.0 上的零样本平均成功率为 13.94%。这里的 13.94% 是模型没有经过 RoboTwin 任务适配、直接推理得到的原生结果,而同期大部分开源基线并不支持这种严格的零样本评测。
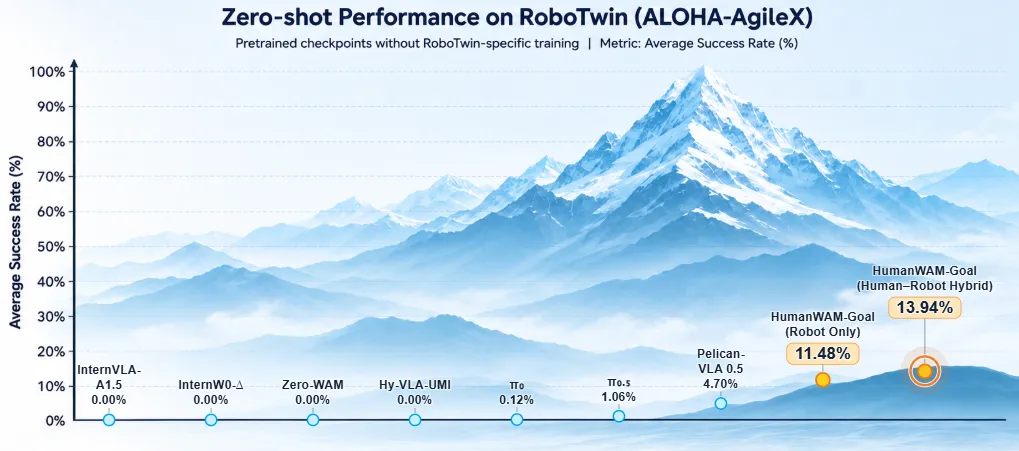
▲图 | 开源模型零样本对比。©【深蓝具身智能】编译
经过任务后训练后,平均成功率为 88.65%,其中 Clean 和 Random 两种条件下分别为 92.70% 和 84.60%。
在真实机器人实验中,研究团队固定机器人数据规模,再逐步增加人类视频数据,观察模型在一组真实操作任务中的零样本表现。
机器人数据固定为 14,618 小时后,随着人类数据从 0 增加到约 45,938 小时,平均任务成功率从 20.0% 提高到 30.5%。
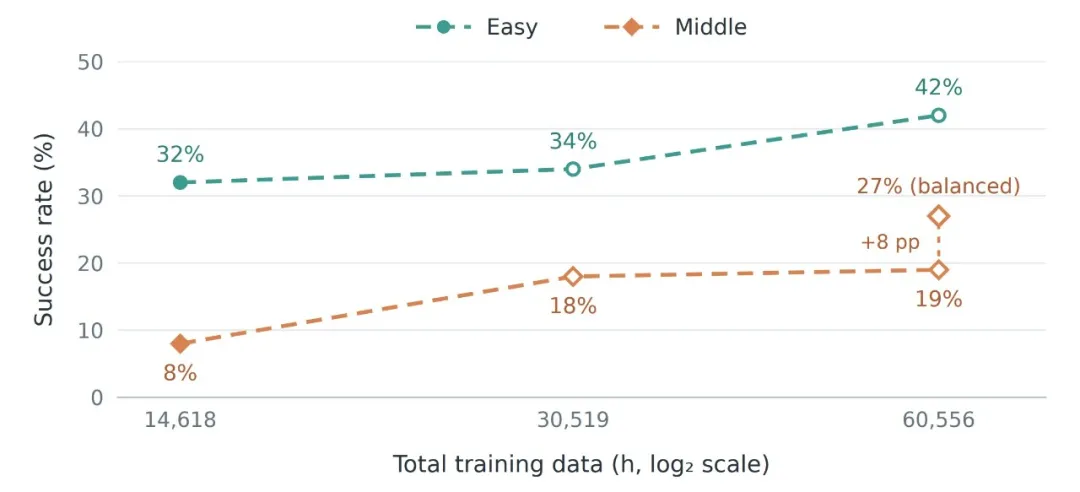
▲图 | 真实机器人按任务难度划分的零样本性能。©【深蓝具身智能】编译
为严谨验证该迁移能力,团队搭建包含 20 项任务的真机零样本评测集,全部任务与场景均未出现在训练集中。
这说明人类视频提供的经验不仅能改善仿真结果,在真实机器人上也能带来帮助。这里比较的是没有针对这些目标任务进行后训练的零样本评测。
▲图6 | 在固定机器人预训练数据的条件下,逐步加入更多人类第一视角视频后,真实机器人零样本操作成功率从 20.0% 提升至 30.5%。这说明人类视频提供的操作经验不仅能改善仿真表现,也能为真实机器人带来可测量的帮助。©【深蓝具身智能】编译
另一个更直观的实验是视觉目标引导。
研究者保持同一个预训练策略不变,只更换目标图片,机器人就会尝试把物体放到不同位置。这种能力可以理解为一种具身场景中的上下文学习:模型不需要为每一个新目标重新训练参数,而是根据当前给出的目标图像调整动作。
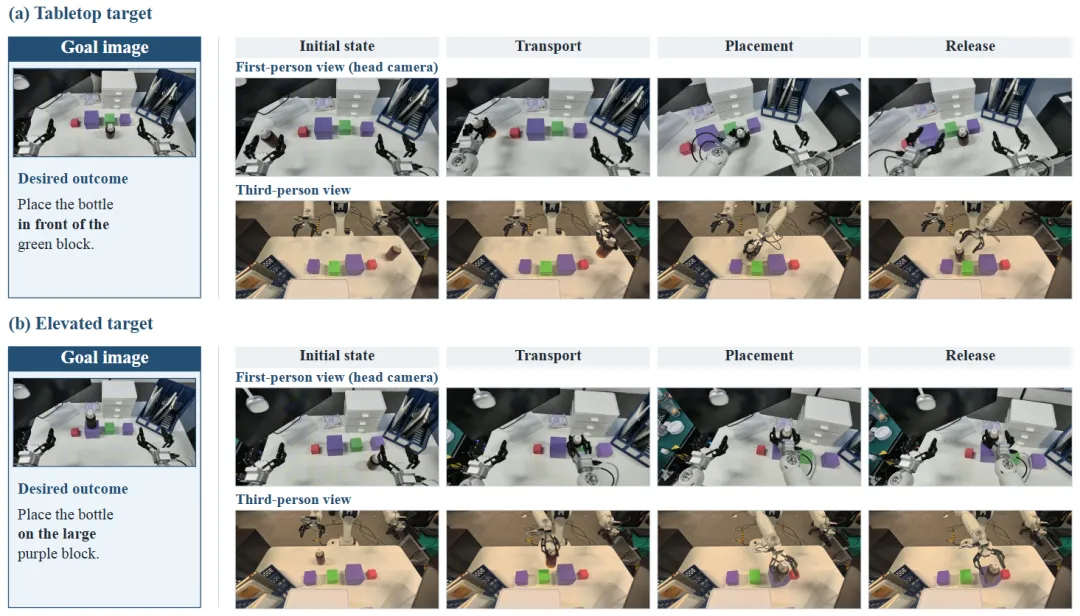
▲图 | 同一个预训练策略面对两张不同的目标图片,会把瓶子放到不同位置:一组要求将瓶子放在绿色积木前方,另一组要求将瓶子放到较高的紫色积木上。模型不需要针对这两个目标重新训练参数,而是根据输入的目标画面调整操作行为。©【深蓝具身智能】编译
当然,这并不意味着机器人已经像人一样理解所有图片,也不代表只看视频就能完全替代机器人数据。真实机器人的身体结构、关节限制、夹爪尺寸和控制误差,都需要通过机器人自身的数据来学习。
研究的结果更接近一个重要的分工:人类数据扩大操作经验的覆盖范围,机器人数据让这些经验落到具体身体上,目标图像则告诉模型当前要完成什么。
写在最后
Open-HumanWAM 想回答的,其实是机器人学习中一个很现实的问题:如果所有操作经验都必须由机器人亲自采集,训练一个真正通用的操作模型就会非常昂贵。
人类每天都在拿取、整理、开合、搬运各种物体,这些经验早已大量存在于第一视角视频中。与其只让机器人反复练习有限的动作,不如先让它从人类经验中建立对物体和操作过程的理解。
但这项工作的关键并不是简单地把人类视频规模做大,而是把视频、语言和手部运动整理成能够共同训练的表示,再通过机器人数据完成身体适配。
HumanWAM-Vanilla 说明,人类经验可以成为机器人学习的预训练来源;HumanWAM-Goal 则进一步展示了人类与机器人数据结合后,模型根据视觉目标灵活调整动作的可能性。
机器人不必每一件事都从自己动手开始学。它可以先观察人类如何与世界互动,再通过自己的身体把这些经验变成真正可执行的动作。
编辑|阿豹
审编|具身君
Ref
论文题目:Open-HumanScale: An Open Recipe for Scaling Human and Robot Experience for Embodied Foundation Models
论文地址:https://arxiv.org/abs/2611.06817
Open-HumanWAM:
Open-HumanScale:
数据集:https://huggingface.co/datasets/DAGroup-PKU/Open-HumanWAM-50K
代码与模型:https://github.com/DAGroup-PKU/HumanNet/tree/Open-HumanWAM
来源:深蓝具身智能