作者: Jindou Jia*, Jingliang Li*, Kuangji Zuo*, Tuo An*, Yuxuan Hu, Mengfei Zhao, Bofan Lyu, Jiaqi Bai, Daoyuan Zhu, Hengyu Dai, Junpeng Zhang, Jianfei Yang†
*共同一作,†通讯作者
单位: 新加坡南洋理工大学 MARS Lab
导读:
伸手拿杯子时,我们并不会每隔 20 毫秒重新决定一次手该在哪里,整个动作随时间连续演化。但今天的机器人学习,无论扩散策略、流匹配、VLA 还是世界动作模型,学的几乎都是“预测动作”本身。
新加坡南洋理工大学 MARS Lab 提出 ODE Policy:不直接预测动作,而是用神经常微分方程(Neural ODE)学习动作随时间演化的规律,每个动作都从上一个动作积分而来。
它只训练 1 个 epoch,成功率就达到流匹配的 5.9 倍,生成动作快 10.8 倍;同一套方法可用于模仿学习、VLA、世界动作模型与强化学习,并在单臂、双臂、灵巧手与人形机器人共 15 个真机任务上成功率全部最高,无需额外的块间平滑,真机动作在多数情况下比人类示教还丝滑。
相关链接:
- 论文:
- Website:
- Code:
1. 背景:为什么机器人一定要学“动作本身”?
“自然不做跳跃”(Natura non facit saltus),莱布尼茨在 1704 年这样写道。人和动物的运动是连续的:猴子伸手时,运动皮层的活动像动力系统一样从准备状态演化,动作随之展开;人的伸手轨迹也接近“最小加加速度”的平滑曲线。
主流机器人策略却不是这样工作的。网络把观测直接映射为离散控制步上的动作值,我们称之为“直接动作策略”。为了更连贯,常见做法是一次输出一段动作块,但块与块之间各自生成,衔接处容易跳变,机器人表现为犹豫、抖动,往往还要靠 RTC 等额外机制来平滑;扩散与流匹配策略还需多步去噪,推理慢、收敛也慢。
于是团队提出一个看似简单的问题:为什么一定要让机器人学习动作本身,而不是学习动作如何随时间演化?
2. 核心方法:学习动作的向量场
ODE Policy 只替换动作头:网络学习的不是动作值,而是动作的向量场,即在当前观测与动作下,动作应以怎样的速度变化。部署时,每个动作都由上一个动作沿向量场积分得到,执行的轨迹天生连续。
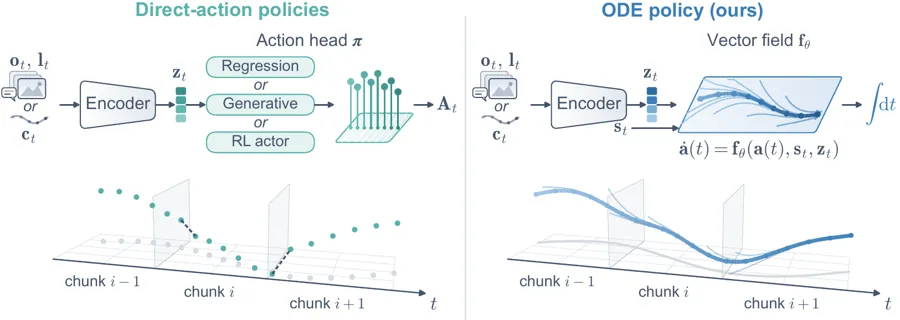
图1 | 直接动作策略与 ODE Policy。
围绕这一想法有三个关键设计。
- 路径损失(Path Loss): 在短动作块上积分,让积分路径匹配示教,无需速度标签。
- 收缩扰动(Contractive Perturbation): 训练时扰动积分起点,使策略偏离示教后能被拉回,减少误差累积。
- 无缝分块(Seamless Chunking): 每个动作块从上一块的末端继续积分,块间没有跳变,每个动作积分出来即可发给控制器。
单个向量场会不会把不同的行为模态“平均”掉?团队加入了一个轻量的多样性头,在每个动作块开始时采样一个方向叠加到速度上,就能让积分路径进入不同模态,无需多步生成式采样。
3. 评估:四种范式、四类真机
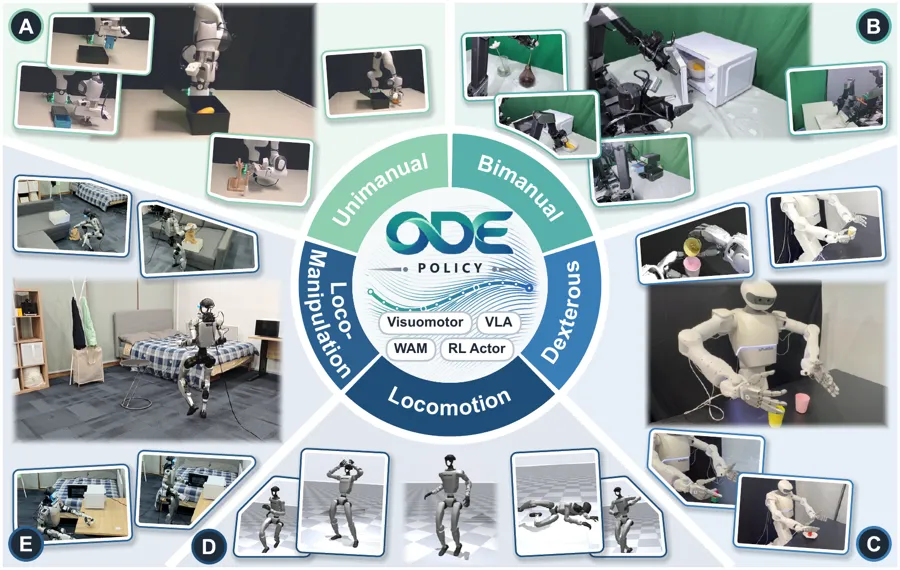
一个基础方法不能只在一两个仿真基准上有效。团队把 ODE Policy 用作视觉运动策略、VLA 与世界动作模型的动作头,以及强化学习的 actor,与 14 种基线进行了对比。
学得快:1 个 epoch 就能用
在 LIBERO 上,ODE Policy 训练 1 个 epoch 成功率即达 79.2%,是流匹配(FM-DiT)的 5.9 倍,第 2 个 epoch 超过 85%,比扩散与流匹配早一个数量级。
每个任务只用 20 条示教,它就超过用 50 条示教的 FM-DiT;只有 1.5M 参数时,就超过 48M 参数的 FM-DiT。
放进大模型同样有效:在 π0.5 中,参数量仅为原动作专家约 3% 的随机初始化 ODE 头,1 个 epoch 后达 96.0%,随机初始化的流匹配专家只有 75.5%;在 ImageWAM 中,ODE 头 1 个 epoch 后达 82.6%,原始动作头只有 24.6%。
在强化学习中,只替换 SuperMimic 的 actor,0.4 小时后评估回报就高出 30%,并领先到训练结束。
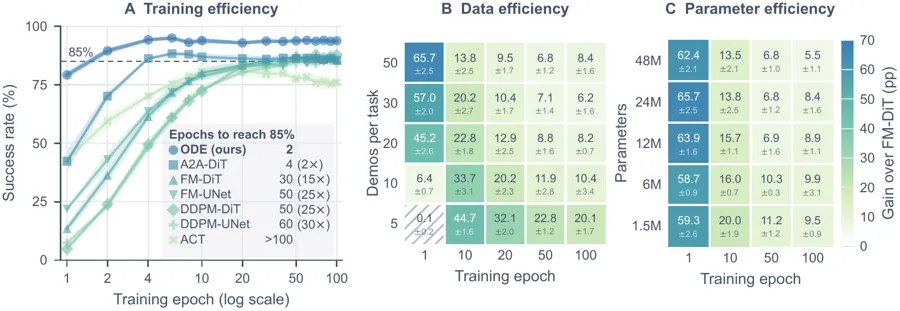
图2 | 学习效率。 A 训练过程中的成功率;B、C 更少示教与更少参数下相对 FM-DiT 的提升;D、E π0.5 与 ImageWAM;F 强化学习中的评估回报提升。
跑得快、动得稳
使用最简单的 Euler 积分,ODE Policy 生成 8 个动作只需 5.7 ms,比 FM-DiT 快 10.8 倍,比 DDPM 快约 100 倍;在 π0.5 与 ImageWAM 中分别提速约 14 倍与 4 倍。
它的末端加加速度(jerk)在所有方法中最低;在真机上,动作块边界处的指令加速度在双臂与灵巧手上不高于人类示教,而基线可达示教的数倍。
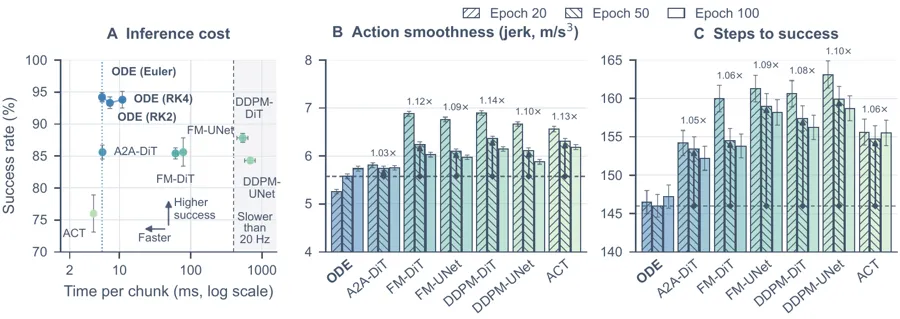
图3 | 推理开销与动作平滑性。
泛化与多模态
在零样本的 LIBERO-plus 扰动测试中,ODE Policy 训练 1 个 epoch 的成功率是流匹配的 5.4 倍。
在有四条路线的 2D 导航任务中,它从第 1 个 epoch 起就走遍四条路线,模态平衡度是 FM-DiT 的 3.9 倍。
15 个真机任务,成功率全部最高
Franka 单臂:
所有策略只训练 50 个 epoch,ODE Policy 叠袜子放进抽屉 15/20(基线最高 8/20),插积木 14/20(基线最高 4/20)。
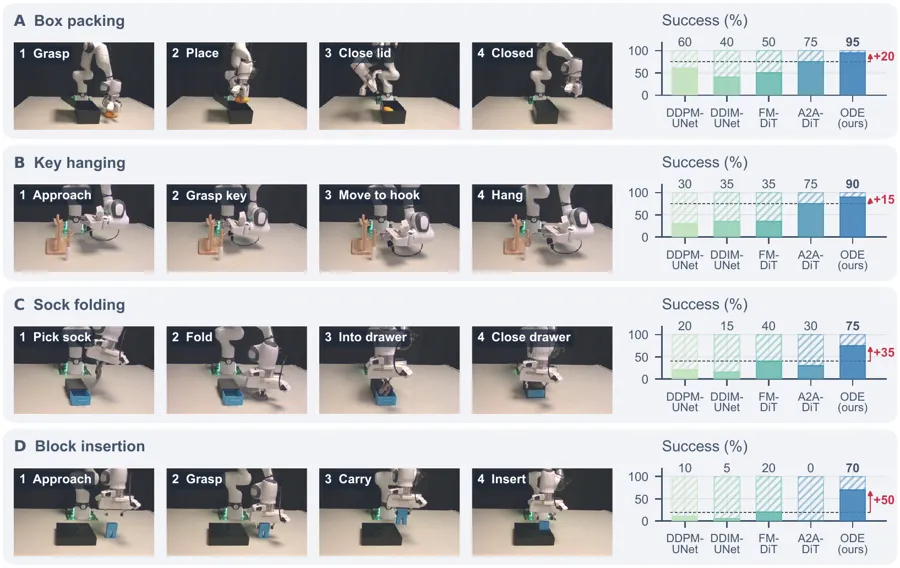
图4 | Franka 单臂真机任务,右侧为 20 次试验的成功率。
Galaxea R1 Lite 双臂:
放碗关微波炉 75%(FM-DiT 20%),叠毛巾 45%(FM-DiT 15%);在多模态抽屉任务中,左右手都会去放苹果,成功率 60%,FM-DiT 从未成功。
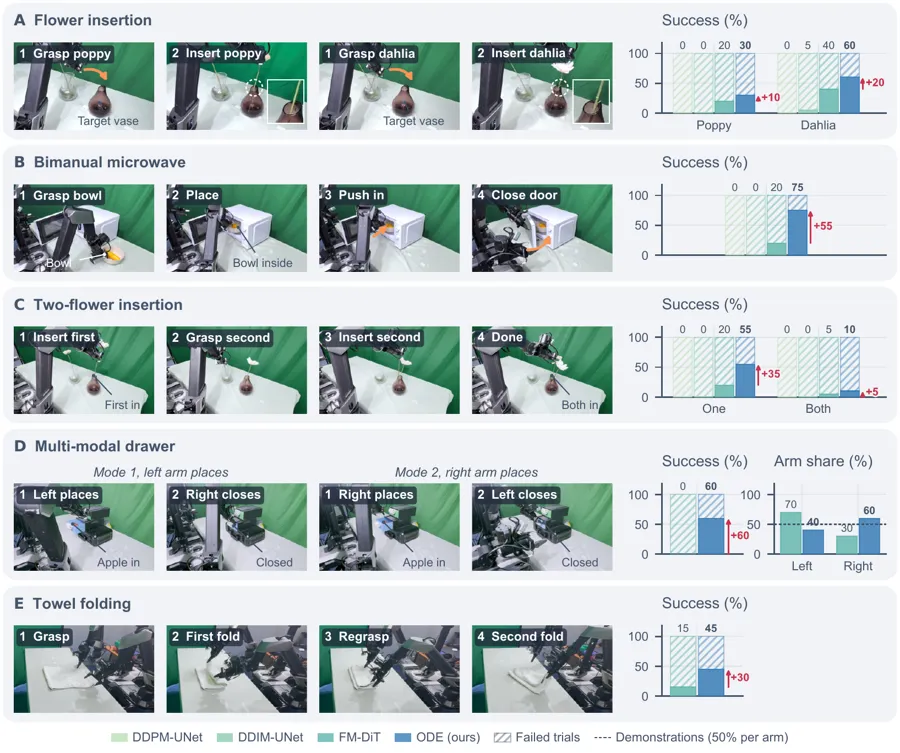
图5 | Galaxea R1 Lite 双臂真机任务。
Sharpa 灵巧手:
抓罐放盘 18/20。
更有意思的是跨实验室迁移:只用 Sharpa 在其实验室采集的公开数据集训练,直接部署到我们的实验室,并换用其他杯子、颜色与背景,扶正杯子 17/20,双手倒药片 17/20(FM-DiT 10/20),叠方块 13/20,而基线在扶杯与叠方块上全部失败。
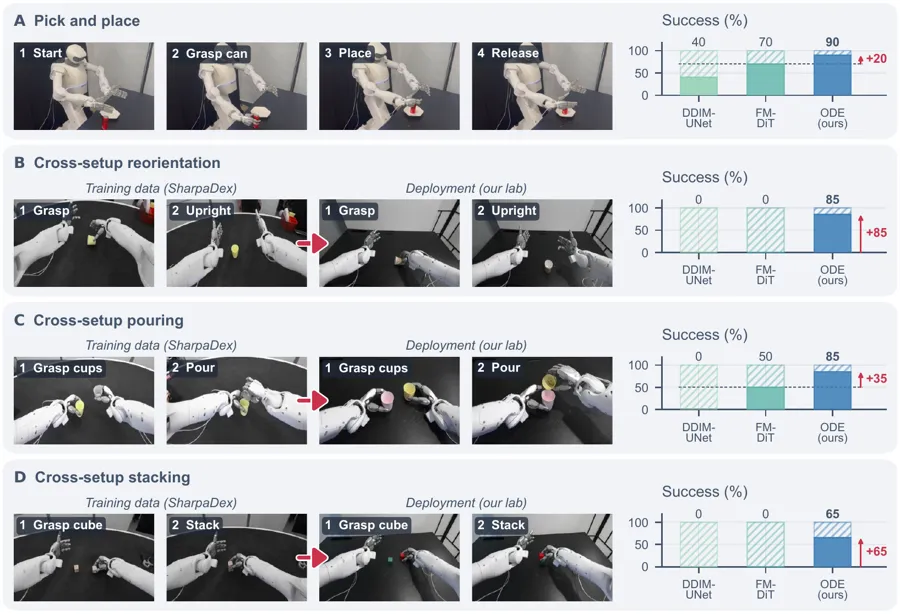
图6 | 灵巧手真机任务,B–D 只用另一个实验室的公开数据训练。
Unitree G1 人形机器人:
ODE Policy 作为 GR00T N1.7 的动作头,完成走路、下蹲、抓取、放置的全身长时序任务:把玩具放进沙发上的盒子 60%(原始动作头 35%),把饭团放进微波炉并关门 70%(原始动作头 30%)。
图7 | 人形机器人移动操作任务。
统计上,ODE Policy 在全部 15 个真机任务上都高于最强基线(双侧符号检验 P=6×10⁻⁵)。
把物理运动的连续性写进策略结构,而不是让网络从数据中学,使策略在学习、数据、参数与执行上都更高效,并从小模型延续到大模型、从模仿学习延续到强化学习。
4. 提升空间与发展潜力
其一,常微分方程描述连续信号。二值的夹爪指令若直接作为向量场的状态积分,成功率会下降,目前用独立的分类头预测。面向不连续动力学的神经 ODE,例如可学习的事件函数与跳变项,可能进一步增强 ODE Policy。
其二,在早期的无模型强化学习实验中,学到的动作常在控制步之间跳变,ODE Policy 收益很小,可能是因为它的连续性也平滑了探索。它最适合指令本身应当平滑的场景,例如模仿示教或部署到真实硬件。
其三,把策略看作物理时间上的向量场,还打开了新的用途:每个动作的速度可直接获得,可从没有动作标签的手持设备或人类视频数据中学习;积分步长是部署时的选择,同一个模型无需重训即可以 20、40 或 80 Hz 运行。
过去几年,具身智能越来越强调 Scaling:更多数据、更大模型、更多算力。这些当然重要,但除了 Scaling,也值得沉下心来重新思考一些最基础的问题。ODE Policy 给出的答案是:动作不是一串独立的数值,而是从意图中展开的连续过程。策略或许只需在任务的少数关键点上做出选择,其余交给学到的动力学去展开。
5. 主要作者信息
贾金豆(Project leader):
新加坡南洋理工大学 MARS Lab 博士后,研究方向包括 VLA、WAM、PINN 等。在顶级 AI、机器人、控制期刊会议上以第一/共一作者发表多篇论文(Nature npj Robotics、IJRR、TRO、RSS、ICLR、RAL、CoRL、ICRA 等)。
杨剑飞(通讯作者):
新加坡南洋理工大学机械与宇航学院和电子与电气工程学院双聘助理教授,博士生导师,MARS Lab 负责人,主要研究方向为多模态人工智能与机器人。在顶级 AI 会议与期刊上发表多篇论文(IJRR、RSS、NeurIPS、ICLR、CVPR、CoRL、ICCV、ECCV、ACL、AAAI、MobiCom、IROS、IJCV、TIP、TNNLS、TMC、IOT-J、TCYBE 等)。
来源:human five