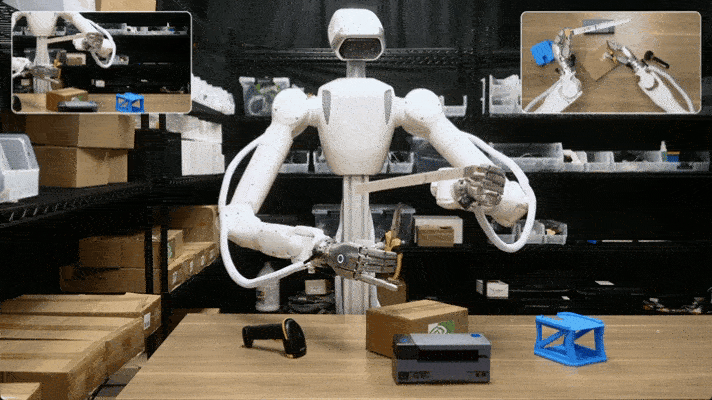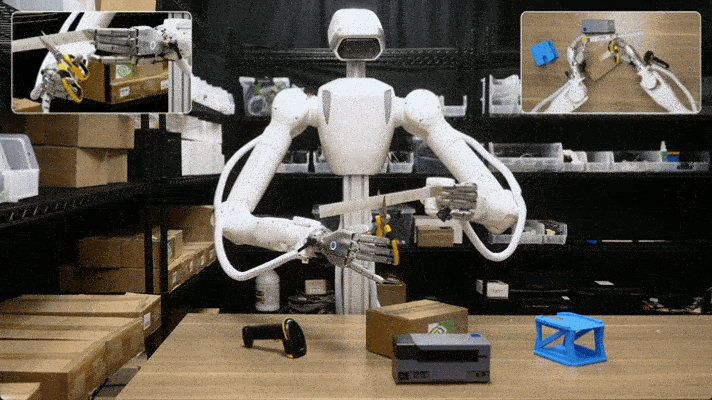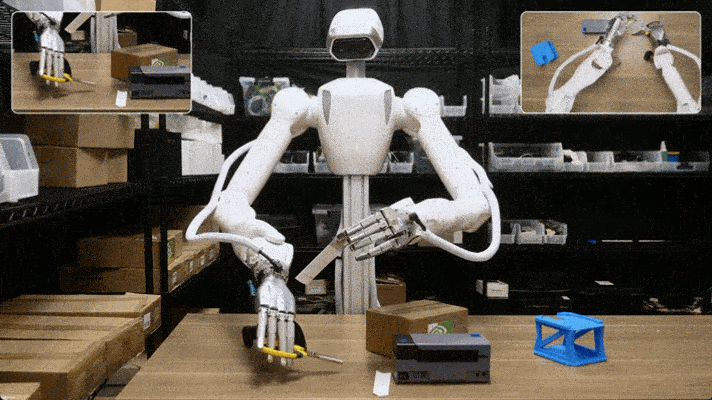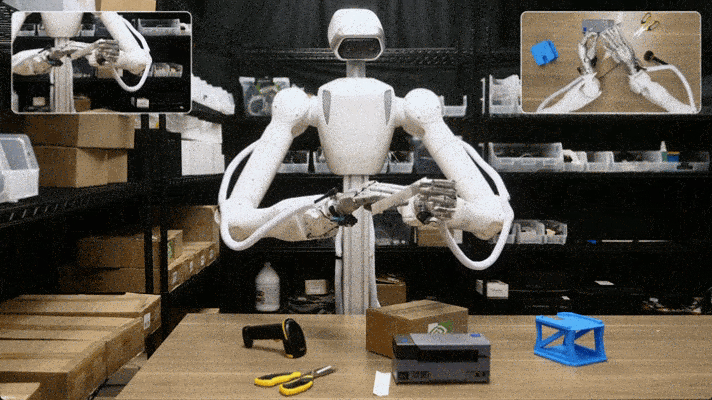
人类视频第一次能提供动作之外的东西
——从动作回归到世界推演
在CoRL 2026上,NVIDIA正式发布GR00T 2。相比 2025 年 3 月在 GTC 亮相的 GR00T N1(全球首个开源且完全可定制的人形机器人基础模型)来说,这次的 GR00T 2 完成了一次目标层面的升级:
从以动作输出为核心的VLA,转向联合预测多视角未来视频与动作的世界-动作模型。
视频帧不再只是输入,而成为监督信号;人类视频也因此第一次能提供动作标签之外的信息。
给模型看一段人做化学实验的视频,它能生成"这台机器人自己去做"的画面,再据此出动作。NVIDIA 把它叫作 X-Adapt。
▲图 | Nvidia官方推文 ©【深蓝具身智能】编译
赌注押在"预测未来"上:视频和动作进同一条序列
拆成两个模型也能做,代价是动作模型看不到还没生成完的未来帧,只能读已经确定的画面,预测对动作的约束就断了。
而放在同一条序列里,动作 token 在去噪时能同步读到正在演化的视频 latent,两者互相约束。
一个 2B transformer,视频和动作同序列
GR00T 从 1.0 到 1.7 一直在同一条路上加码:更强的骨干、更大的动作头、合成数据补场景。人类视频在这条路线里的位置也因此很固定:它喂给 VLM 补世界知识,帮模型看懂场景和任务。
GR00T 2 换的就是这一项:把未来几帧画面写进输出,视频帧自己成了监督信号,人类视频第一次能提供动作之外的东西。
在具体实现里:
底座是 Cosmos-Predict2.5-2B 视频扩散 transformer,视频先验可以直接继承。
视觉用冻结的 Wan 2.1 VAE 压缩(时间 4×、空间 8×);在 224×320 输入下,每路相机每个潜帧切成 280 个 token,配一个可学习的视角 embedding 区分是哪路相机;
语言侧用冻结的 Cosmos-Reason1,通过 cross-attention 读入指令;
状态和带噪动作块由各本体专属的小 MLP 投到 transformer 宽度,再由专属 decoder 还原成动作。
训练用 flow matching,视频和动作各一个损失;部署时视频去噪 1–2 步、动作 2–4 步就够了,推理预算主要花在动作上,不在画面上。
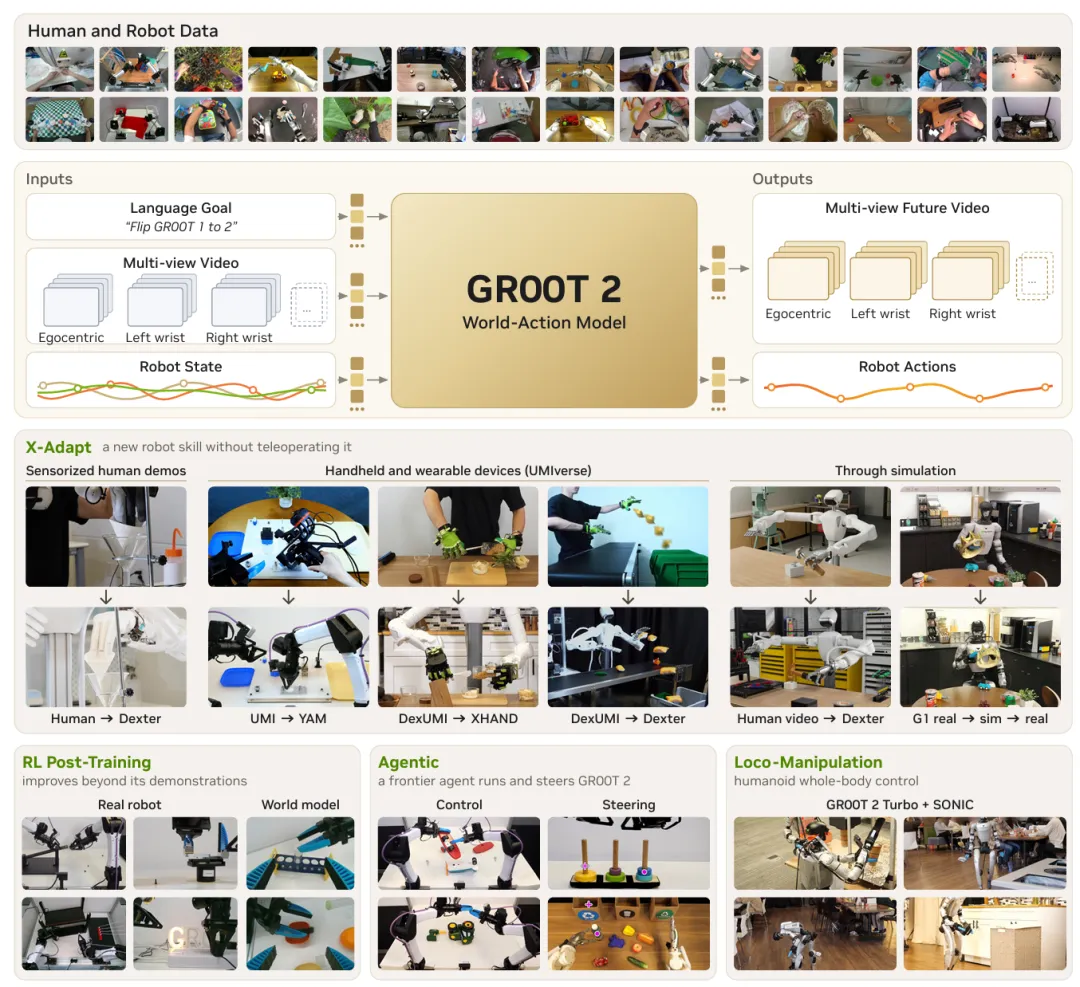
▲图1 | GR00T 2 概览:以人类与机器人数据预训练,输入语言目标、多视角视频与机器人状态,联合预测多视角未来视频与动作;下方为四种 X-Adapt 途径、RL 后训练、Agent 驱动,以及 GR00T 2 Turbo 指挥 SONIC 做全身移动操作 ©【深蓝具身智能】编译
为什么"想象"能当跨本体的翻译器
跨本体之所以难,不是因为某一个参数没对齐,而是因为:相机内外参不同、运动学不同、动作语义不同。GR00T 2 的处理思路是能算的先用几何算掉,算不掉的交给生成:手腕视角重投影去对齐视野和朝向,动作重新表达成目标机器人的动作空间,剩下的外观与"这活该怎么干"由联合预测补上。
同一个玩具自卸车装配任务,只用 UMI 夹爪示教训练时,模型预测的未来帧里画出来的是人手和蓝色 UMI 手指;加入与任务无关的 YAM 数据协同训练后,画面里变成 YAM 自己的机械臂。
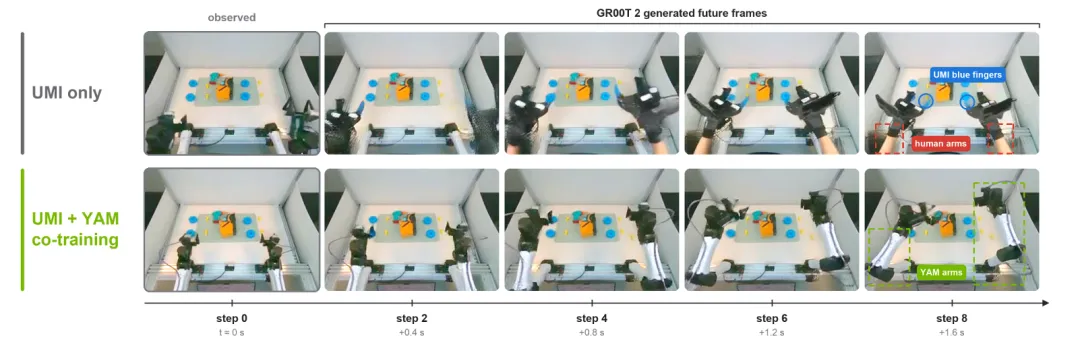
▲图 | GR00T2 在 YAM 机器人上生成的未来帧对比©【深蓝具身智能】编译
所以跨本体要补的不是动作数值之间的对应表,是模型对目标本体外观与运动方式的先验。
这也是世界-动作模型和纯 VLA 最本质的差别:差别不只在输出多了几帧画面,而在于“这台机器人做这件事会长什么样”成了一个可以被训练的对象。
不靠目标机器人遥操作,怎么教新任务
如果目标机器人一条遥操作都不给,示教还能从哪来。GR00T 2 展示的几条路径,正是围绕这个问题展开的。
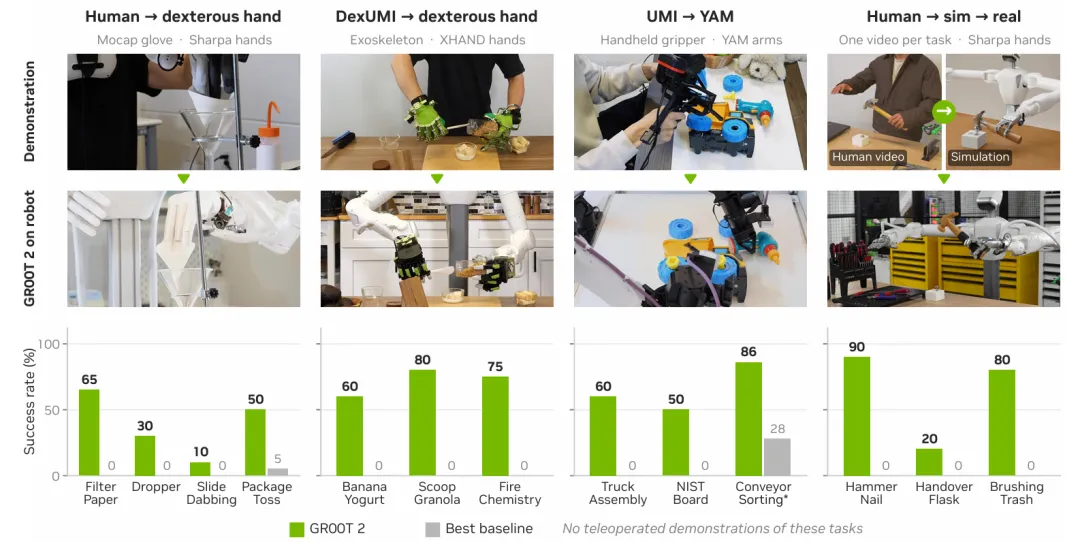
▲图 | 不依赖遥操作学习新任务。每列是一种"不用目标机器人示教"的演示方式,并给出演示、GR00T 2 在机器人上的执行画面与真机成功率 ©【深蓝具身智能】编译
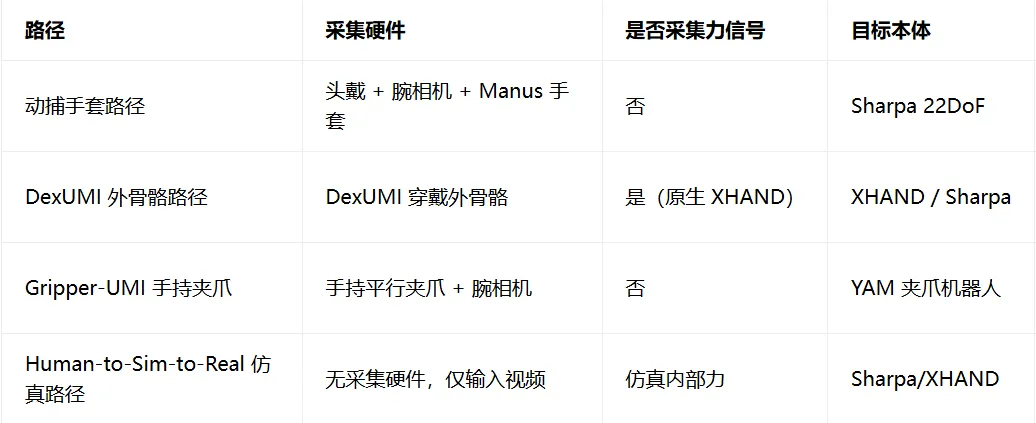
四种采集路径 + 一条仿真路径
动捕手套方案实现人手直接映射到灵巧手
操作者佩戴头戴相机、腕部相机与 Manus 手套采集动作,原始视频不作改动,再通过离线重定向,将动作映射到七自由度机械臂与搭载高密度指尖触觉阵列的 Sharpa 22 自由度灵巧手上。
作为整套实验的目标硬件,Sharpa 灵巧手五个指尖各嵌一枚微型相机、单指超过 1000 个触觉像素;尺寸接近人手,重定向不必大改;压力之外还能测滑移、力变化和接触位置,硬件上具备接触闭环。
在实机运行时,Sharpa 灵巧手运行在固定刚度位置跟随模式,并不启用 XHAND 上的 ACP 自适应柔顺控制,模型下发的是双臂位姿与手部关节角度组成的 62 维动作目标;同时,整套 Tianji + Sharpa 平台同时也是 Dexter‑50 基准全部灵巧任务的评估载体。
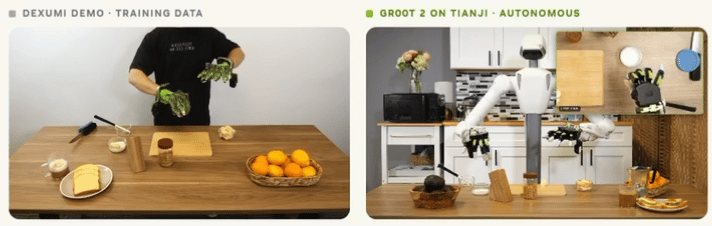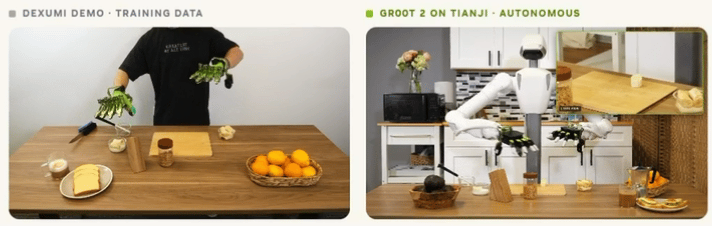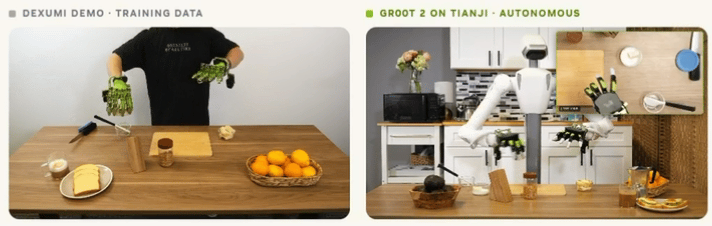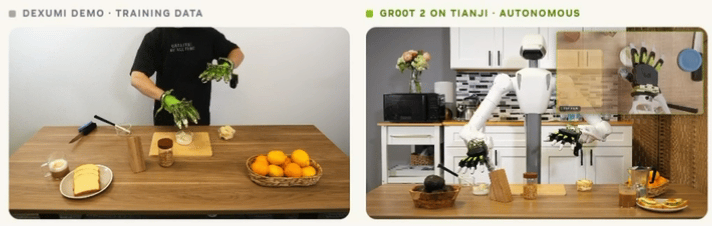
DexUMI 可穿戴外骨骼则瞄准强接触灵巧操作
硬件原生复刻 XHAND1 Pro-U 的 16 自由度构型与接触面,还可以同步记录指尖三维力与关节扭矩;同本体场景下,关节角可直接作为机器人指令,力信号也能送入模型。
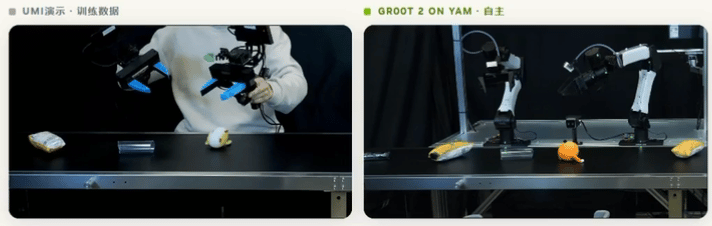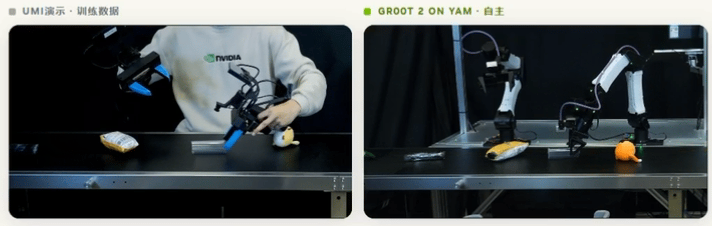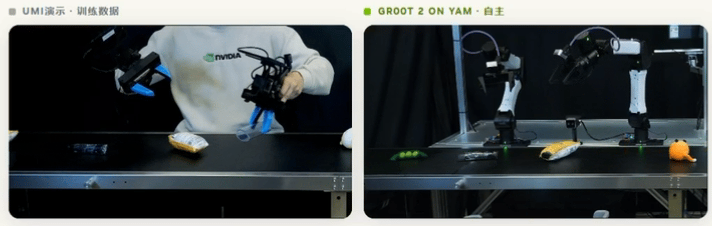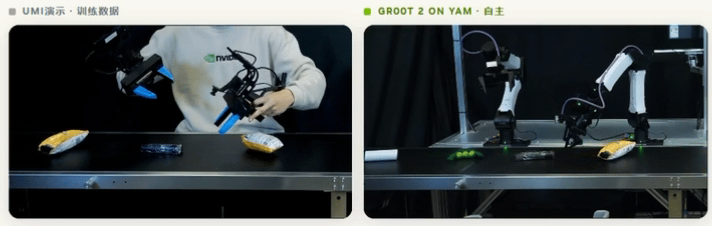
手持 UMI 夹爪是面向夹爪体系的轻量化采集路线
设备自带机器人范式的腕部鱼眼相机、夹爪宽度编码器以及 IMU,人手持设备演示时,直接产出对齐机器人坐标系的操作数据,只需后续做视场校正即可投入训练。
单段人类视频经仿真
只需要一段普通人类操作视频,经由 Video‑to‑Data 重建人手、物体与交互轨迹,再在 Isaac Lab 中生成海量仿真示教样本用于模型微调。
单用哪一种都不够。
因此,示教数据提供任务监督,目标本体的无任务探索数据提供本体监督;1:1 混采,使模型同时获得任务语义与目标本体的外观、运动学先验。
这里“换本体”的工程成本,除了模型侧的外观与运动先验,还取决于硬件侧的集成难度。Sharpa Wave 采用直驱传动架构,22 个自由度全部集成在手掌内,不绑定特定小臂,可以灵活拼装到不同机械臂平台上。
人类视频作为监督信号
人类视频既没有动作标签,也没有目标机器人的外观,按纯 VLA 的框架它是不能用的。
GR00T 2 能用它,是因为预训练目标里包含视频预测:一段第一视角视频,即使不知道对应的动作,也能监督“接下来画面该变成什么样”。
同一架构、同一后训练数据,只改 Human-1M 的预训练比例(0%、1%、10%、100%),72 个 Dexter 任务上真机成功率 18% → 41%,视频推演成功率 30% → 51%,而且最大的那一档还没饱和。
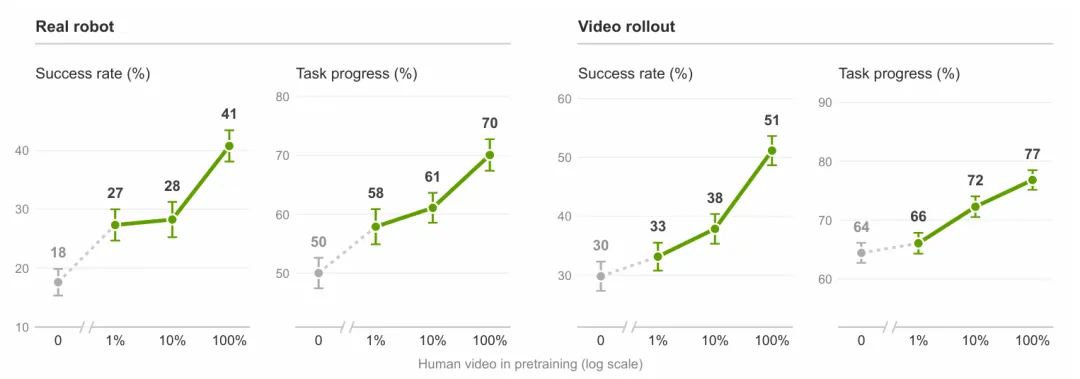
▲图 | 预训练中人类视频的规模效应:真机成功率 18%→41%,视频推演成功率 30%→51%,两者均未在最大规模处饱和 ©【深蓝具身智能】编译
人类视频能作为监督信号,核心机制是 GR00T 2 的联合视频-动作预测目标:一段第一视角视频即使没有动作标签,也能监督“接下来画面该变成什么样”。
但仅有视频预测还不够,预训练同时混合了 Human-1M 人类视频(40.27 万小时) 、UMI-10K 手持夹爪示范(1.02 万小时,覆盖 2,897 个任务) 和 2.35 万小时遥操作数据,后两者提供机器人动作监督。
预训练之后还得打两块补丁
接触密集任务,SFT 的天花板在哪
固定管件、手指放置、线缆插入、充电器插入这四个任务,SFT 基线只有 40–76%。这类误差模仿学习补不上,因为示教里的成功样本分布本来就窄,没见过的失败状态也从来没人纠正过。
因此研究直接在真机上对 GR00T 2 跑 GRPO,把确定性动作去噪换成 CPS 采样来产生探索噪声,再用成功轨迹做自模仿。
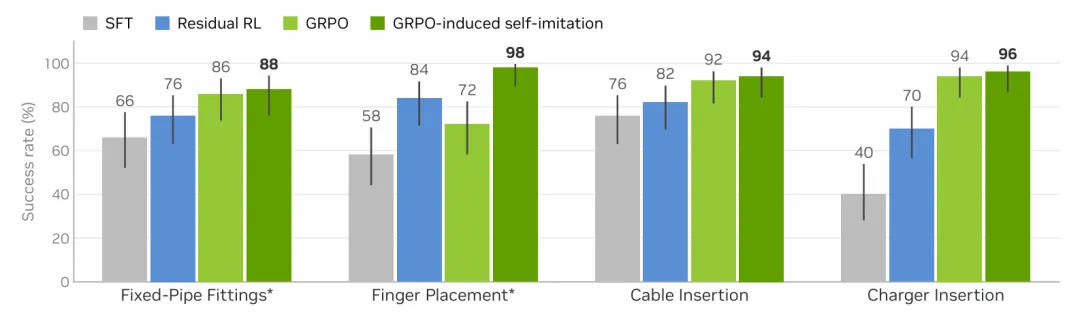
▲图 | 四个接触密集操作任务的真机后训练结果,误差线为 50 次试验的 95% Wilson 区间 ©【深蓝具身智能】编译
而且,这套让真机操作成功率大幅提升的强化学习方案,其关键配置并非由人类工程师手动调试得出,而是由一个自动化研究代理在仿真环境中花费约35天“跑”出来的。
Agent 当系统 2
长程装配的失败点通常不在动作,在中途掉了件、卡住了、位置偏了,没人发现也没人恢复,策略只输出动作。
GR00T 2 的分工是:Agent 负责想做什么(拆任务、写代码、监控、恢复);GR00T 2 负责怎么做。
真机上的压力测试最能看出分工价值:三项长程装配,每次开始前由人把零件随机倒在桌上,这是后训练里从没见过的乱局,单次试验 5–14 分钟。SFT 在 Hot Wheels 上只有 23/100;加 DAgger 提到 84/71/78;再由 Agent 修掉掉件和卡顿后交回控制权,变成 98 / 97 / 97。
重复插接任务上,同一个 agentic 框架里把 SFT 换成 RL 后训练的 GR00T 2,线缆从 12/20 到 19/20,充电器从 2/20 到 20/20。
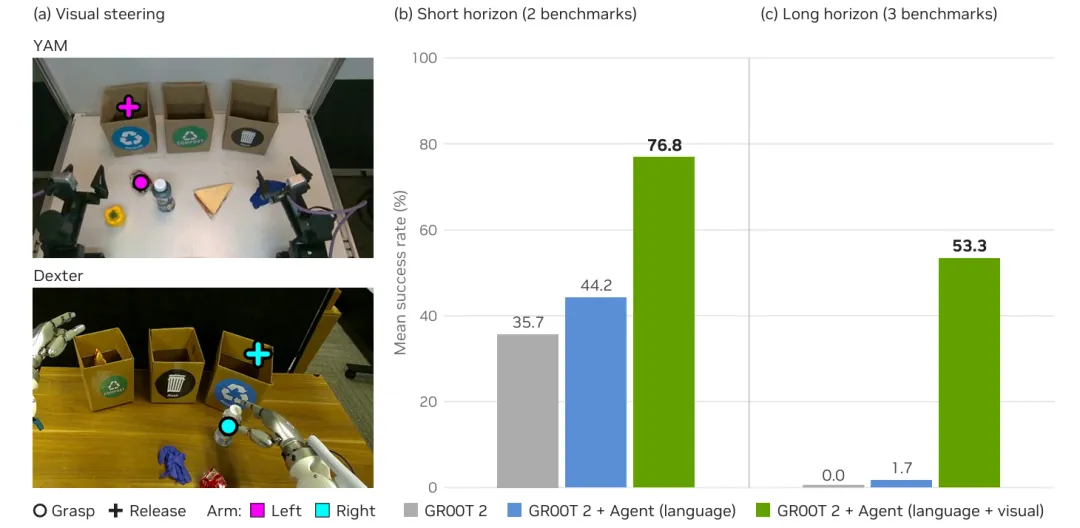
▲图 | 视觉引导在两层评测上都带来更高平均成功率:圆点为抓取目标、叉为释放目标,颜色标识执行手臂 ©【深蓝具身智能】编译
评测:把“不可比”改成“可比”
为什么不报绝对成功率
真机成功率会随工位、操作员、硬件、当天的状态漂移,跨场次根本不可比。所以 NVIDIA 自己搭了 GearArena:盲测 A/B——
同一场景、同一操作员、几分钟内把 2–4 个检查点随机顺序各跑一遍,漂移被共享后在对内抵消。
7 月到 11 月,10 个 YAM 工位、20 余名操作员,累计 195 轮 campaign、16044 次打分回合、11767 次两两比较、71 个检查点,用 Bradley-Terry 拟合成 Elo,置信区间靠重采样"任务"而不是"试验"。
实验结果显示 GR00T 2 比 π0.5 高 236 Elo(95% CI 171–325,即约 80% 的对战胜率),比 GR00T 1.7 高 95 Elo。四个月里榜首自己往上爬了 206 Elo。
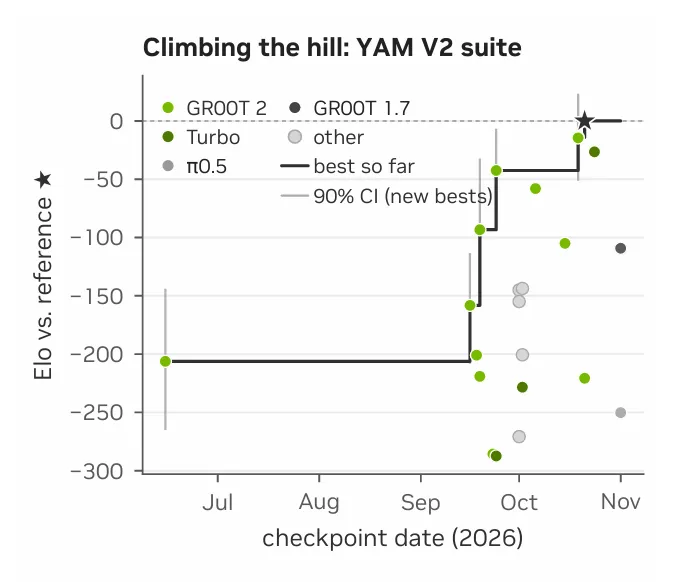
▲图 | YAM V2 套件上各检查点相对 A/B 参考的 Elo 与其保存日期,柱为刷新最佳时的成对 90% bootstrap 区间 ©【深蓝具身智能】编译
仿真能代理多少
仿真则被当作代理评测来用,但不是万能。
25 个 YAM 任务、14 个检查点,仿真与真机的 Pearson 相关分别是任务进度 0.93、成功率 0.92、Elo 0.93;DROID 环境重建的五个通用检查点更高(0.98/0.95/0.97)。
这已经接近“完美仿真器在同样试验数下能达到的上限”。
预训练期间用仿真筛检查点、把最终候选压到 3 个再上真机。
▲图 | 仿真与真机的性能对照:(a) 任务进度、(b) 成功率、(c) Bradley-Terry Elo ©【深蓝具身智能】编译
写在最后
GR00T 2 把机器人基础模型的预训练目标从“动作回归”换成了“世界推演”。这一步换掉之后,人类视频这种既没有动作标签、也没有机器人外观的数据,第一次变成了可用的监督信号;跨本体也从“重定向 + 对齐 + 微调”的工程活,变成了模型内部的想象。
但它同样暴露了这条路线的边界:预测的精度和预测的内容是两笔账。要更快的端侧推理就得放弃视觉细节,而放弃细节的代价在灵巧任务上是一半的成功率。这个取舍不是调参能解决的,它取决于接下来能不能回答“哪些未来值得预测”。
评测方法上,GearArena 那套盲测 A/B + 累计 Elo 的做法,可能比模型本身更值得借鉴。
毕竟具身智能这两年最缺的不是更强的策略,而是能被相信的比较。
编辑|小小怪博士
审编|具身君
参考论文:
论文标题:GR00T 2: Scaling Robot Foundation Models for Generalization, Dexterity, and Adaptation
来源:深蓝具身智能