 「数据过剩之前,垃圾数据会先过剩」
钱从自己口袋出去,绕一圈又回到自己口袋。
具身智能这两年的共识之一是缺数据,但十个做数据采集、卖数据集的,九个都和我们说大多卖不动。
而在众多数采路线中,遥操基本上被视为当下最务实可行的路线。
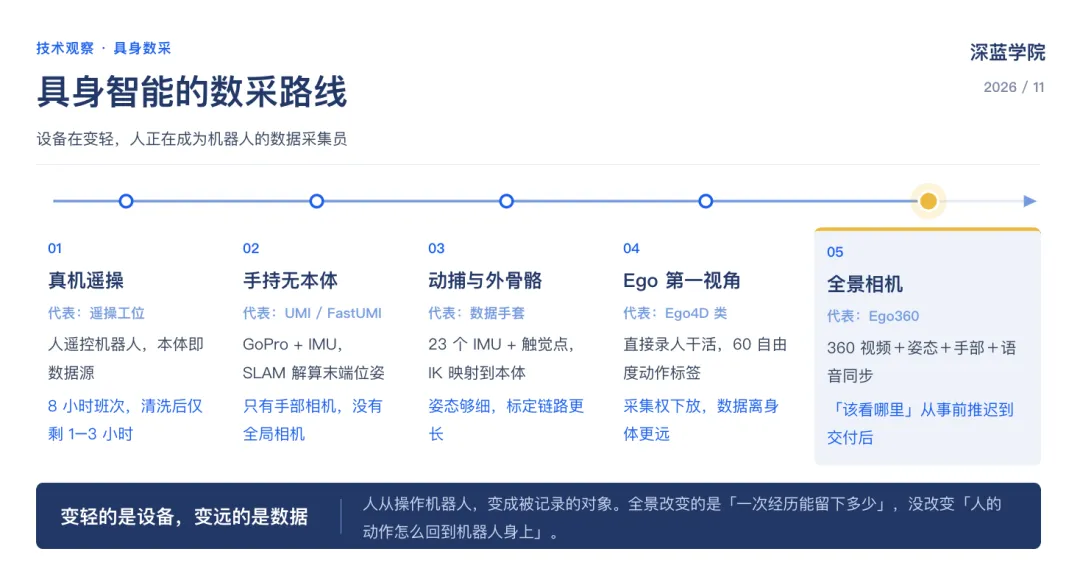
从真机遥操,到 UMI 那种拿手持夹爪直接录动作,到动捕手套和外骨骼;再到这两年起来的 ego 路线:干脆不遥控机器人了,直接记录人自己干活,再把人的动作映射给机器人。
设备越轻,上手门槛越低,能参与采集的人就越多,数据产能上限也就越高。
可这条路线自带一道绕不开的 trade-off:数据离机器人本体的形态、动力学特性越来越远。
这段时间我们和不少团队交流,留意到一个新的动向:
原本扎根在影视、VR 全景拍摄里的全景相机,正在被挪进具身数据采集的赛道里。
当下行业讨论重心大多落在窄视场 Ego、手持夹爪采集上,全景路线还处在早期试探阶段,远没有形成共识。
我们并不打算论证这条路线更好,也不认为它一定能解决映射这个核心难题。
它是一条平行的备选路径,有它的适用边界,也有一堆待落地的工程关卡。我们把这个现象拿出来拆解,是想补全当下具身数采的完整图景。
本文还是老规矩,我们主要从具身数采路线的演进、全景数据的处理方式,以及全景深度、三维重建和仿真等技术链条出发,梳理全景相机在具身数采中的目前进展。大家各抒己见。
欢迎关注【深蓝AI】 将持续分享人工智能领域前沿动态👇深蓝AI1—数采路线演进1:人替机器人采数据如果要训练一个会收拾桌面的机器人,最理想的数据当然来自机器人自己。机械臂看到桌上的杯子,伸手、抓取、移动,再把杯子放到指定位置。整个过程中,相机看到了什么、机械臂怎么运动、夹爪什么时候闭合,甚至关节位置和末端执行器轨迹,都可以直接记录下来。
对于机器人学习来说,这类数据很“干净”。麻烦在于,它并不好规模化。
DROID 是一个很典型的例子。
研究团队为了把机器人数采从实验室的一张桌子扩展到更多真实环境,在 13 个机构部署了统一的 Franka 机械臂、相机和遥操作系统。50 名采集者在 12 个月里最终获得约 7.6 万条轨迹、350 小时交互数据,覆盖 564 个场景和 86 类任务。
350 小时已经是机器人领域相当可观的数据量,但换一个角度看,这也意味着一整套机器人硬件、跨机构部署和一年采集,最后换来的数据连续播放还不到 15 天。对于希望覆盖更多真实场景、长尾任务和人类活动的具身模型来说,只靠机器人自己一点点积累数据,成本很快就会成为瓶颈。
于是过去几年,一个越来越清楚的变化开始出现:研究者开始想办法,让人替机器人采数据。
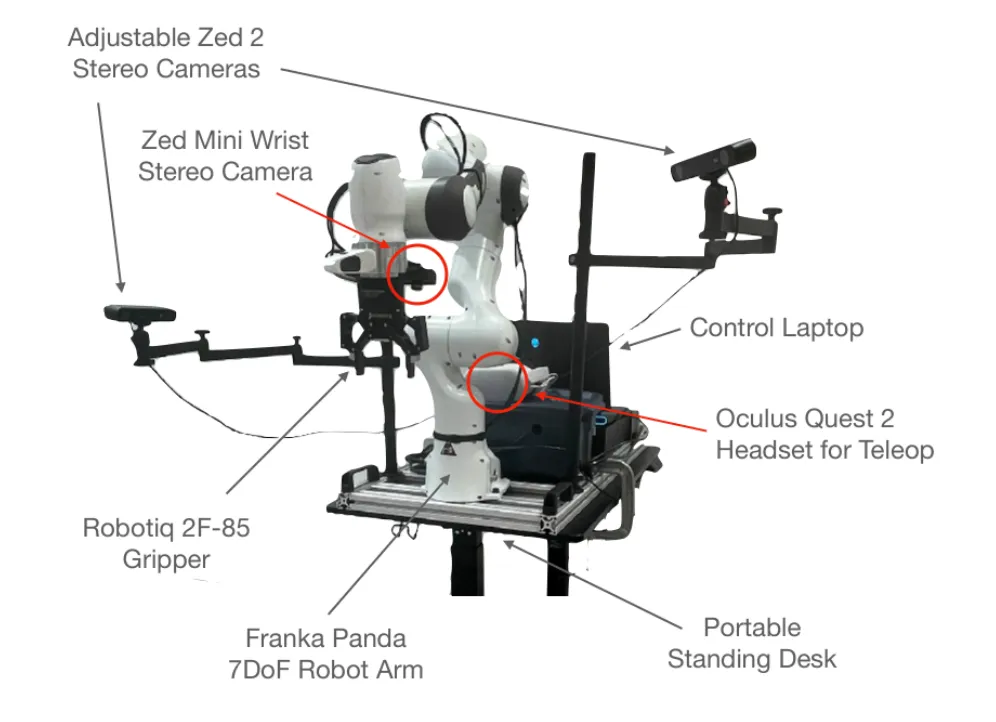
图1 | DROID 使用统一的 Franka 机械臂、双外置相机、腕部相机和 VR 遥操作设备,把 robot-native 数采扩展到多个机构和真实场景。它展示了机器人原生数据的优势,也直观体现了这类数据为什么不容易低成本扩张。©【深蓝AI】编译
深蓝AI2—再演进2:从手持夹爪到第一视角眼镜这条路线并不是一步从“遥操作机器人”跳到“戴个相机就行”,而是一点点把机器人从数据采集现场里拆出去。
UMI,也就是 Universal Manipulation Interface,是中间很典型的一步。
它把 GoPro、IMU 和一个类似机器人末端执行器的平行夹爪做成便携设备,采集者不必先把机械臂搬进厨房、办公室或餐厅,而是直接拿着这套设备完成任务,再将记录到的运动转换成机器人策略需要的数据。
项目页给出的杯子整理实验中,UMI 达到每小时 111 条 demonstration,而 SpaceMouse 遥操作为每小时 35 条;这套设备到达一个新环境后,也可以很快开始采集。它改变的不是某一个算法模块,而是数据产生的方式:机器人不再必须出现在每一次演示的现场。
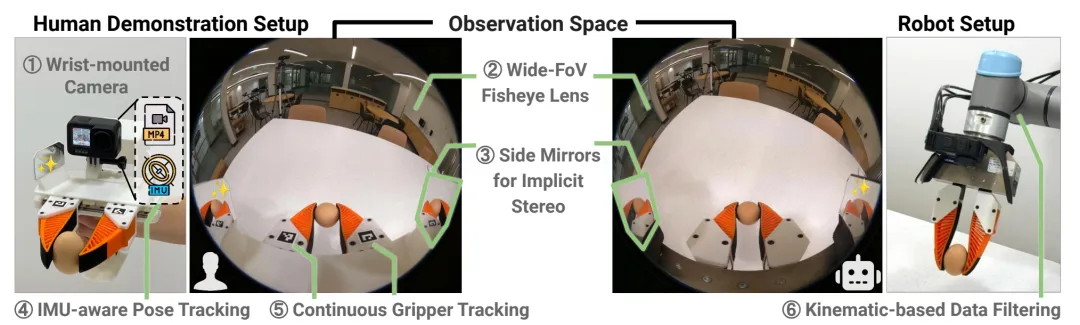
图2 | UMI 把数采接口做成可以随身带走的手持夹爪。相比必须把机器人部署到目标环境,采集者可以直接进入家庭、餐厅等场景完成演示,再把人的运动转成机器人策略所需的数据。©【深蓝AI】编译
DexCap 又把采集设备进一步往“人”身上收。
它利用动作捕捉相机和手套记录人的手掌、手指运动,项目报告的采集吞吐量约为传统遥操作的 3 倍,并接近自然人类动作速度。到了 EgoMimic,设备甚至进一步变成 Project Aria 这样的第一视角眼镜:系统从人的第一视角视频与 3D 手部轨迹中构造 human demonstrations,再和 robot data 共同训练策略。EgoMimic 的实验还显示,在其特定任务设置中,增加一小时 hand data 比增加等量 robot data 更有价值。
把这些工作放在一起,会看到一条很清楚的演进:robot teleoperation → portable interface → instrumented human → natural human experience。 越往右,采集过程越接近一个普通人在真实环境里自然工作,机器人也越来越不需要出现在每一次数据产生的现场。
当然,这种变化也带来了新的交换。机器人自己采数据时,动作监督天然与机器人 embodiment 对齐,关节、夹爪和末端位姿都可以直接读取;换成人来采以后,环境覆盖和采集效率提高了,但“人是怎么做的”需要再通过视觉、动作捕捉、姿态恢复或 retargeting,重新翻译成“机器人应该怎么做”。
因此,具身数采正在重新平衡三件事:动作监督质量、真实环境覆盖和采集扩展性。 当动作可以越来越多地从人的行为里恢复之后,另一个过去不那么突出的瓶颈也开始浮出来:
如果人只需要戴着相机自然地完成任务,那么相机究竟把这次经历留下了多少?
深蓝AI3—当下,第一视角的取舍?假设一个人在便利店整理货架。他先看向右侧货架,拿下一瓶饮料,转身放进身后的推车;随后向左走几步,又从另一个货架找到新的商品。
用头戴第一视角相机拍下来,这已经很接近机器人未来可能看到的画面。但第一视角相机有一个很基础的问题:
相机看到哪里,本身就是一种数据选择。
人低头看商品时,远处的货架可能已经出画;人转身推车时,刚才操作的位置又到了身后。为了拍清楚双手,相机可能损失更大范围的场景;为了看清整个房间,局部操作又可能变得太小。更麻烦的是,这种损失发生在采集当下。几年以后可以重新跑检测模型、重新做标注,却没办法让当时没有进入视野的区域重新出现在录像里。
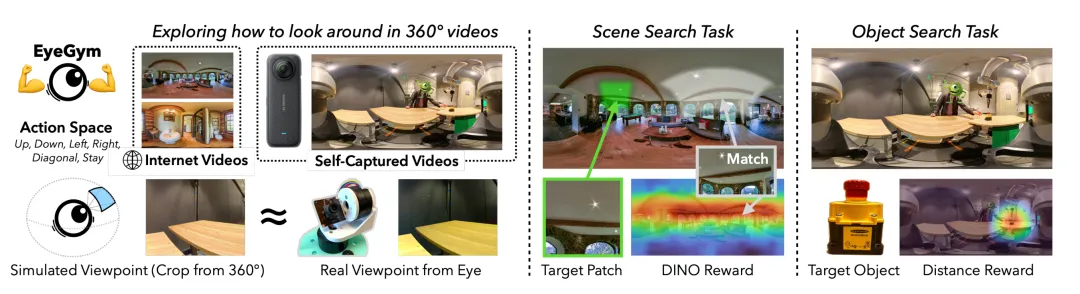
图3 | 全景记录的一个关键价值,是把“看哪里”的决定留到数据采集之后。UC Berkeley 的 EyeRobot 使用 360° 视频保存完整视觉环境,再从同一段记录中按需生成不同方向的相机视角。换句话说,一次全景采集可以对应许多种后续 observation,而不是在拍摄瞬间就永久固定视野。©【深蓝AI】编译
这正是全景相机进入具身数采之后最有意思的地方。
放到消费摄影里,全景记录很像"先拍摄、后取景";放到具身数据里,意义更进一步:同一段原始记录,如果未来用于操作学习,可以重点裁出手和目标物体;如果用于导航或空间理解,则可以保留更完整的环境结构;等新的训练目标出现时,也还有机会重新回到原始全景中寻找证据。
换句话说,普通视频往往在采集时就确定了 observation,全景记录则试图先保存一个可以在采集后再次查询的视觉现场。这也是它和普通第一视角数据真正拉开差异的地方。
深蓝AI4—全景视频变成训练信号,目前走到了哪一步不过,把整个房间拍下来只是第一步。对具身智能而言,更关键的问题是:怎样把一段"人干活的视频",变成模型真正能消费的训练信号?
目前,这条处理链主要在 Ego360、PhysBrain 1.0/1.5 等少数项目中被系统性描述。
处理链首先要解决的是时间问题:全景视频与语音同步采集,后处理用 voice activity detection、自动语音识别和词级时间对齐,把自然语言作为任务切分的线索。人可能先说后做,也可能边做边补述上一件事,所以最终的任务区间还要结合视觉证据一起校准。
接下来是场景和交互:系统从任务片段中组织物体、区域、可见文字、空间关系和状态变化,并形成 Ego-Element Graph、结构化 caption 和 QA 数据。数据不再只回答“画面里有什么”,还开始描述目标在人的什么方向、物体之间如何相对摆放、什么时候发生接触,以及状态怎样随动作变化。
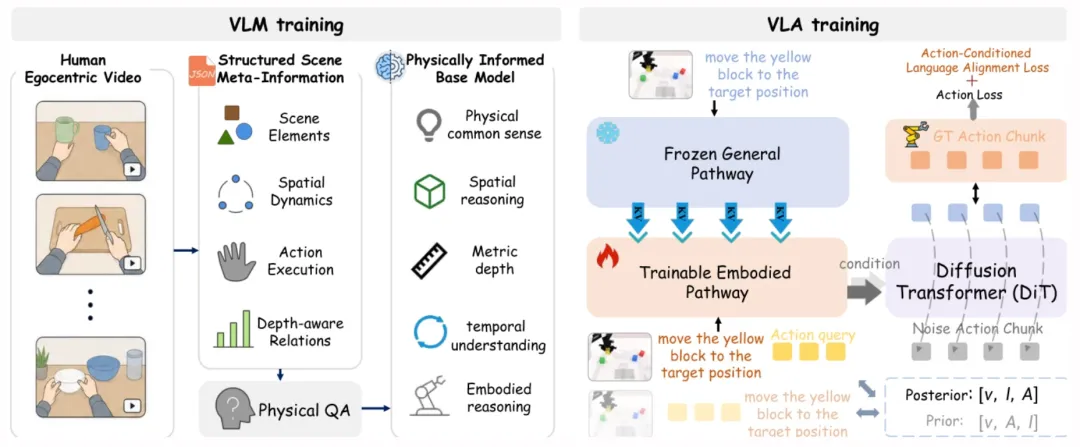
图4 | 人类第一视角视频进入具身模型之前,还需要被进一步加工成机器能够学习的结构化监督。PhysBrain 1.0 将视频中的场景元素、空间变化、动作执行与深度关系组织成物理理解数据,展示了从“记录人的行为”到“提取物理经验”的一条典型处理链。©【深蓝AI】编译
再往下是人的运动和场景几何:需要从去畸变后的任务相关视角恢复 3D 人体运动,表示中保留多个身体关节和手部关节,并利用带时间戳的相机 pose 将运动转换到统一世界坐标。scene reconstruction 则重新使用完整的 panoramic observation,估计 episode 级相机轨迹和持续存在的场景结构。
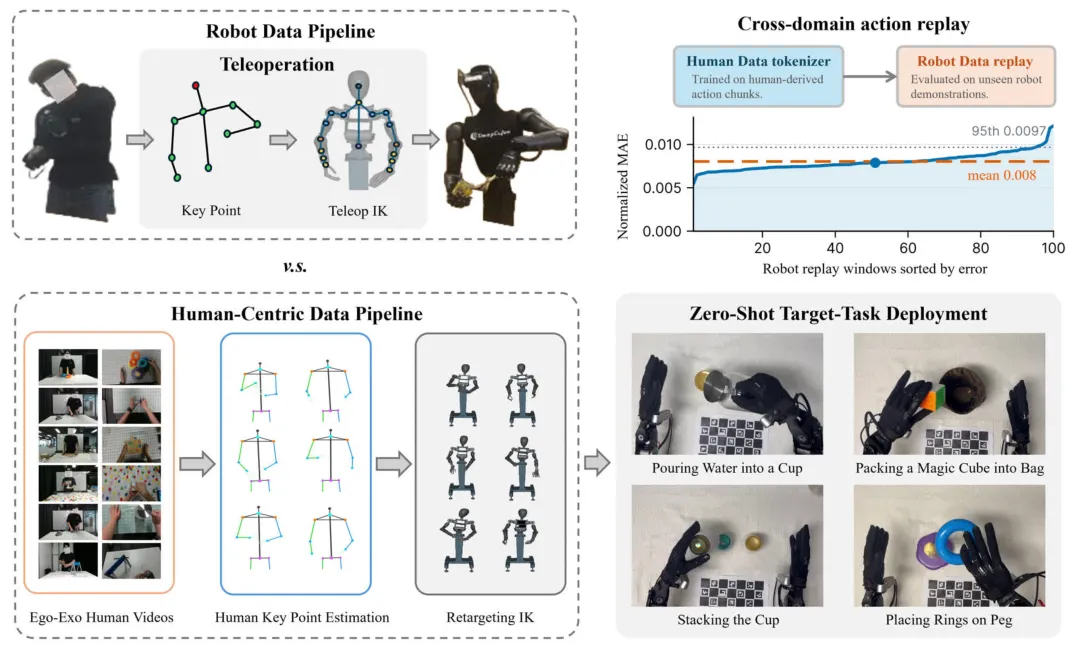
图5 | 从人类视频到机器人动作还隔着一次“翻译”。Human-as-Humanoid 使用同步第一、第三视角视频恢复人体运动,再通过运动学映射将其转换为机器人控制器能够直接使用的 60-DoF 动作标签,让人类演示进一步变成可用于 VLA 训练的 observation-action supervision。©【深蓝AI】编译
这让“打开冰箱”“拿出物体”“走回桌边”不再只是几个被视场切开的短 clip,而有机会重新接回同一段连续活动。
也正是在这里,全景数据的意义从“看得更宽”转向了“保存得更完整”:对于大规模 human video,真正有价值的数据单位可能不只是一个 action trajectory,而是一整段 physical experience,里面同时包含环境、意图、人体运动、物体状态变化和长程空间关系。
模型侧也开始出现与这种数据形态相呼应的尝试。2026 年 9 月发布的 PhysBrain 1.5 在技术报告和项目页中表示,其 physical-aware pre-training 的 embodied supervision 来自 human interaction videos,其中包括 egocentric、同步 ego-exocentric 和 panoramic recordings;之后的 supervised fine-tuning 再混合 human demonstrations、real-robot trajectories 和 simulated experience。
这形成了一种很有意思的数据分工:先用规模更大的人类交互视频学习空间、交互和状态变化,再用更直接的 robot-native data 去补动作和 embodiment。
到了这一步,全景相机的价值就不只是拍摄工具本身,而是它能不能为这种更大规模的人类物理经验提供足够完整的原始记录。
深蓝AI5—支撑全景数采的技术链条,正在搭建中如果沿着这个问题继续往下看,会发现全景相机真正进入具身系统之前,还需要经过几层转换:相机首先要能够被系统稳定调用,RGB 要进一步变成深度和几何,真实场景还可能需要被重建成可计算的三维资产。
这几层目前都有了一些具体进展,下面以消费级全景相机厂商影石(Insta360)的公开工作为例来看。
最底层是工程接口。Insta360 的 Desktop Camera SDK 已经支持 Windows 和 Ubuntu 22.04,Linux 覆盖 x86-64 与 AArch64,并提供相机连接、参数控制、拍照录像、实时预览和文件管理等能力。2026 年 8 月的 SDK 更新还增加了从文件尾部解析 IMU、曝光时间等元数据的工具。对于机器人或边缘设备来说,这意味着消费级全景相机开始具备被集成成系统传感器的基本工程条件。
再往上一层是几何。Insta360 Research 在 CVPR 2026 的 DAP(Depth Any Panoramas)研究如何直接从不同场景的全景图像中恢复 metric depth。RGB 记录的是外观,而深度进一步提供距离和空间尺度,这正是全景影像从“视觉素材”走向“空间数据”的关键一步。
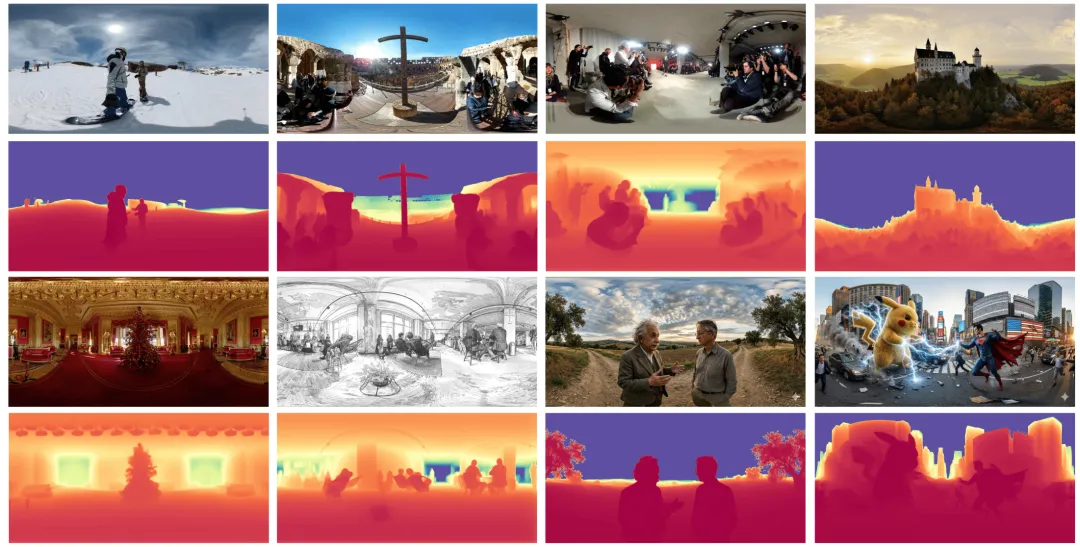
图6 | Insta360 Research 的 DAP 从全景 RGB 估计 metric depth。对于具身任务而言,这类工作展示了全景影像如何从视觉记录继续向带尺度的空间几何表示延伸。©【深蓝AI】编译
再往上是大尺度重建。PanoLOG 把问题推进到大尺度 3D Gaussian Splatting 重建。全景图一次覆盖完整 360° 视野,可以减少大型场景需要采集的视角数量,同时也带来和普通透视相机不同的优化问题。AirSim360 则从反方向补齐另一类数据:它基于 Unreal Engine 5 构建全景无人机仿真环境,并同步输出 RGB、真实欧氏深度、semantic 和 instance segmentation,公开的 Omni360-Scene 已达到 12 万帧以上。现实世界这一端,也开始出现把 360° 视频直接变成空间资产的产品尝试。2026 年 4 月,Insta360 与 Splatica 宣布合作,用户可以用短时 360° 视频生成 3D Gaussian Splatting 场景,并导出到 Unity、Unreal Engine、Isaac Sim 和 Omniverse。
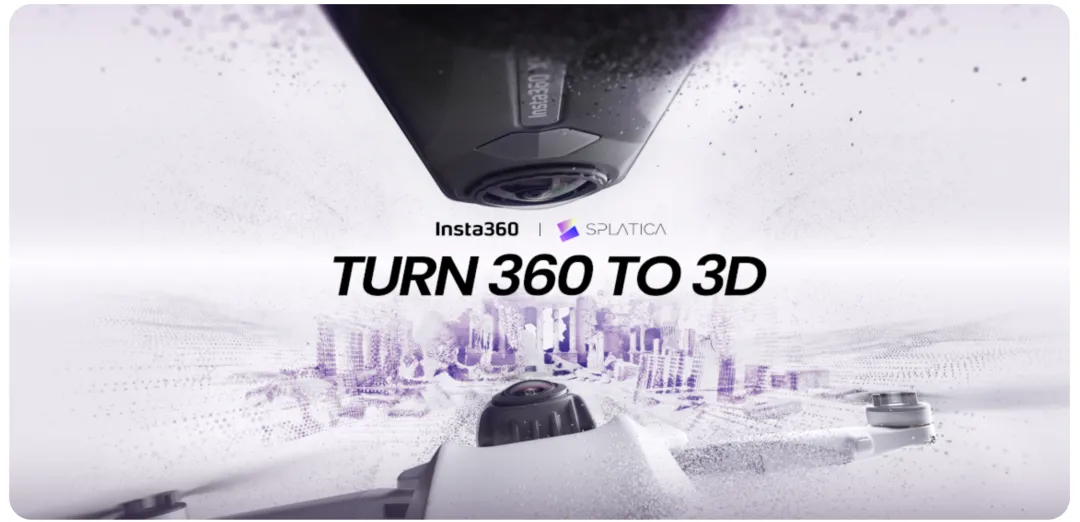
图7 | Insta360 与 Splatica 公布的 workflow 尝试把短时 360° 实景记录转换成 3D Gaussian Splatting 场景,再导入多种实时与仿真平台。它展示了全景视频从影像素材继续向三维空间资产转换的一种产业路径。©【深蓝AI】编译
真正值得关注的不是某一家公司"跨界做机器人",而是全景数据沿着"采集画面 → 恢复几何 → 重建空间 → 组织训练数据"这条链,正在被一点点补齐。
但补齐是一回事,被机器人团队大规模采用是另一回事。
深蓝AI6—看见整个房间,为什么还不够?全景相机的优势很直观,但它也有一个容易被忽略的问题:看见整个环境,并不等于看清所有动作。
Ego360 团队公布的抽样评估显示:在 8 个独立 episode、357 个事件上,task context visible 为 100%,至少一只手可见为 88.0%,目标物体可见为 90.6%,interaction visible 为 83.4%,complete-event recall 为 82.7%;但 full torso visible 只有 4.4%。
这个反差恰好说明了全景相机擅长什么、不擅长什么。
颈戴相机能把周围环境几乎完整保留下来,但人的身体依然会遮挡自己:双手交叉、身体转动或拿大物体时,关键动作仍然可能消失。因此,360° 视野解决的主要是空间上下文覆盖,精细动作、接触和受力仍然需要其他传感器补充。
这也让一个更现实的数采形态逐渐清楚起来:全景相机可以承担 context layer,负责记录动作发生在哪里、周围还有什么、目标从哪里出现,以及一次局部操作如何嵌入更长的任务;腕部相机、手部追踪、IMU,以及机器人端的关节状态、末端位姿、force/torque 或 tactile,则继续补充精细动作与接触信息。
与此同时,全景数据本身也更难处理。把球面世界展开成常见的 equirectangular projection,会引入几何畸变、非均匀空间采样和边界连续性问题。Ego360 也列出了 stitching artifact、motion blur、自遮挡,以及弱纹理和快速运动下 pose 与 reconstruction 退化等实际问题。
也就是说,它擅长的是把一段活动发生的"世界"留下来。至于手究竟怎么动、接触力有多大、机器人最后该执行什么动作,还需要和其他数据源一起完成。
深蓝AI7—产出端「画地为牢」的热闹?具身数采的瓶颈是什么?是机器人原生数据扩张不动,而人类活动数据又面临"记录不完整"的新问题。
全景相机针对的是后者:它的优势在于把"看哪里"的决定推迟到拍摄之后,让同一段记录可以服务多种后续用途。
全景相机擅长的是空间上下文这一层,精细动作、接触和受力仍然需要腕部相机、手部追踪、IMU 和机器人端的力觉传感器来补。所以,全景相机在具身数采里更准确的位置是:一个混合采集方案中的 context layer 候选。
这个剧本其实演过一遍。
互联网大模型是把全网文本吃得差不多了,才发现高质量数据早就见底,后面两年都在为数据质量还债。具身智能现在相当于刚拿到一台便宜得多的收割机,正站在同一片麦田前面。
区别在于,互联网数据录错了,代价是推荐错一条视频;物理数据录错了,代价是摔碎一个杯子、磕到一个人。便宜的数据,用在昂贵的身体上。
更要命的问题在下游。这个行业至今回答不了一个最朴素的问题:一批数据喂进去,机器人到底变聪明了多少?成功率动了几个点、归因到哪批数据,没人量得出来。上游在拼命生产,下游没有验收的能力。
全景相机当前还只是「产出端」的热闹,整个数采行业或许都是如此。
来源:深蓝具身智能