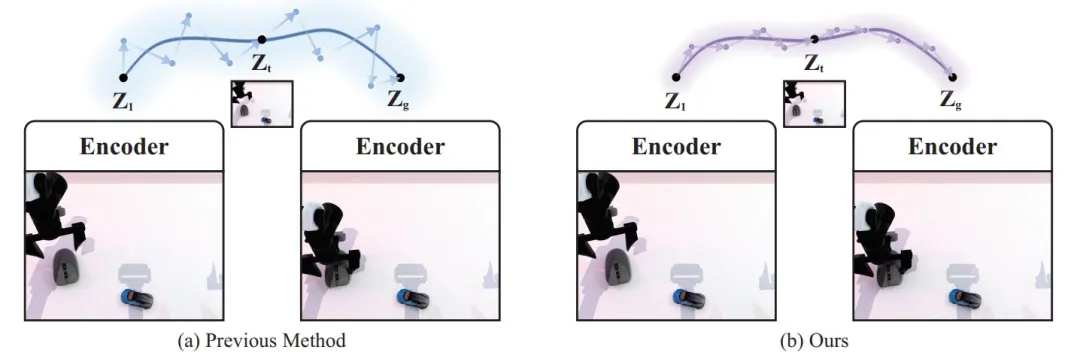
“ 世界模型能预测未来,为什么机器人还是“动不好”?
LG-DKGP:让世界模型学会动作连续性,五项仿真任务宏平均成功率达 87.07%,较 LeWM 提升 28.41 个百分点。
导语
给机器人一张当前画面,再给它一张目标画面:能不能让它自己找到一串动作,把眼前的世界变成目标的样子?
视觉世界模型正在尝试回答这个问题。它可以“预演”不同动作的后果,再选择更接近目标的方案。不过,能预测动作的结果,不等于能提出一段前后连贯的动作。
推动物体时,下一步需要接续当前的运动方向;机械臂从接近物体切换到抓取时,又需要及时改变控制方式。动作既要保持必要的延续,也要在合适的时刻发生变化。缺少这样的时间结构,即使有世界模型辅助评估,规划仍可能绕远路、错过目标。
为此,北京邮电大学DeepTouch-Lab 团队提出 LG-DKGP(Locality-Gated Deep-Kernel Gaussian Process):从专家示范中学习动作如何延续,为世界模型规划提供更合理的候选动作。在五项仿真任务中,LG-DKGP 取得 87.07% 的宏平均成功率,比 LeWM 的 58.66% 高 28.41 个百分点。
01.
问题:世界模型会“想”,为什么机器人还是可能“做不顺”?
世界模型规划通常先生成候选动作,再预测执行后的状态,最后选择最接近目标的方案。这里存在一个分工上的缺口:世界模型回答“这样做会怎样”,而规划器还需要回答“下一步该怎样接着做”。
以 PushT 为例,机器人需要用圆形推动器把 T 形物体推到指定位置与朝向。在论文展示的同起点、同目标对比中,LeWM 在物体附近多次转向,50 步内未能完成任务;LG-DKGP 则沿着更连贯的路径接近并推动物体,在第 24 步达到目标。
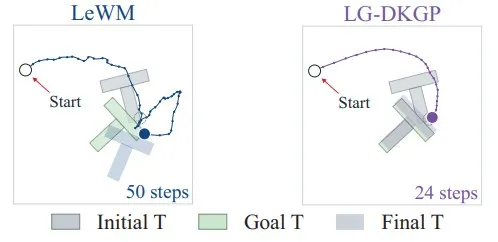
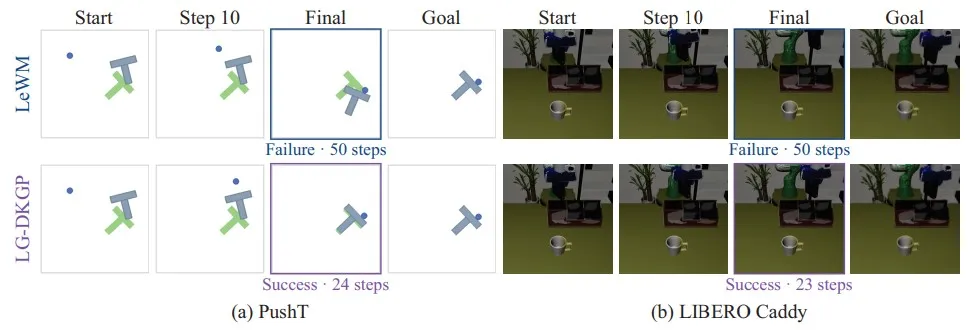
关键并非让相邻动作的差值永远最小,而是在延续已有动作意图的同时,保留转向、接触和抓取等必要的阶段切换。
02.
灵感:打乱专家动作的顺序,会发生什么?
我们做了一个简单的实验:保留专家示范中的所有动作值,只随机打乱同一轨迹内的动作顺序,然后比较相邻动作的变化。
在 PushT、Cube、Caddy、Scene2 和 RoboTwin 五个环境中,按原始顺序排列的专家动作,其相邻变化均明显小于打乱顺序之后;五项任务的差异对应的 95% 自助采样置信区间均不包含零。
这意味着,专家示范不仅提供了“做什么”的动作样本,还提供了“按什么顺序做”的时间结构。
就像写文章:认识每个词,不等于能把它们组织成通顺的句子。对机器人而言,选对动作是第一步,让动作接得上前后文同样重要。
03.
核心方法:给世界模型配一个懂“上下文”的动作先验
方法框架图
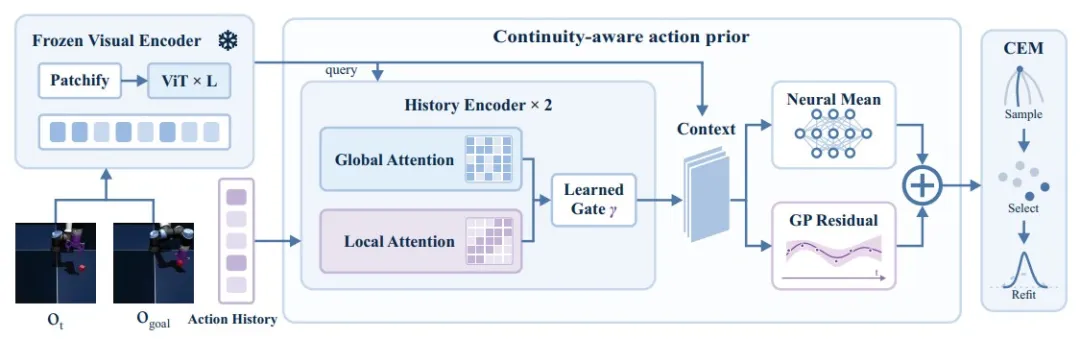
LG-DKGP 在冻结的视觉世界模型之外,学习一个动作先验:先根据当前与目标图像、已经执行的动作历史,预测下一段合理的动作;再由世界模型判断哪些候选更接近目标。整个方法由三个环节组成。
3.1 同时看“刚刚做了什么”和“之前在做什么”
最近的动作反映当前运动趋势,更早的动作则可能揭示任务阶段:机械臂正在接近物体,还是已经开始搬运?
LG-DKGP 设计了局部性门控历史编码器。局部注意力偏向最近的动作,全局注意力保留更长时间的线索;可学习的门控机制结合当前与目标图像特征,动态融合两部分信息。
这样,每一次新规划都能建立在已经执行过的动作上下文之上,而不是重新猜测下一步。
3.2 神经网络给出主方向,高斯过程补上时间细节
历史信息编码完成后,神经网络首先预测未来动作序列的主要走向;**深核高斯过程(Deep-Kernel GP)**进一步学习神经网络未能解释的残差,以及未来不同时间位置之间的相关性。
未来动作的预测均值 = 神经网络动作延续 + GP 残差修正
神经网络负责复杂的非线性动作模式,GP 负责具有时间相关性的结构化修正。二者结合,使生成的动作序列更接近专家示范中的行为节奏。
3.3 先提出合理候选,再让世界模型寻找目标
LG-DKGP 不直接执行预测均值,而是围绕它进行交叉熵搜索(CEM)。搜索的初始探索尺度来自训练集中专家相邻动作变化的统计量,因此候选动作既有合理的起点,也保留进一步探索的空间。
冻结的世界模型预测候选动作执行后的潜在状态,CEM 根据预测状态与目标状态的距离迭代筛选方案。
动作先验负责提出值得尝试的动作,世界模型负责评估这些动作能否推动任务达成。
主实验中,每次规划 25 步动作,最多执行 50 步;CEM 每轮评估 300 个候选,共迭代 30 轮。执行一个动作片段后,机器人重新观察环境、更新实际动作历史,再开始下一轮规划。
04.
训练:让模型学会“续写”专家动作
动作先验通过两阶段训练获得。
第一阶段,用专家未来动作监督历史编码器与神经网络均值头,学习当前图像、目标图像和已执行动作历史与未来动作之间的关系。
第二阶段,加入 GP 残差,联合优化历史编码器、神经网络和 GP 参数,进一步拟合专家动作的时间相关结构。
训练时的专家未来动作用作监督;在线规划时,先验只使用当前与目标图像及已执行的动作历史。视觉世界模型在训练和规划中均保持冻结。
05.
实验:五项仿真任务,宏平均成功率 87.07%
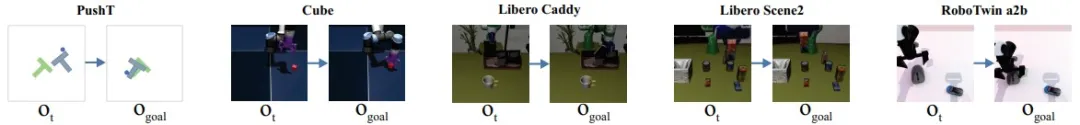
我们在 PushT、OGBench Cube、LIBERO Caddy、LIBERO Scene2 和 RoboTwin 上评估 LG-DKGP,并与 LeWM、iCEM、PRISM、INTACT 比较。
| 方法 | 五任务宏平均成功率 |
|---|---|
| LeWM | 58.66% |
| iCEM | 59.33% |
| PRISM | 61.66% |
| INTACT | 71.03% |
| LG-DKGP | 87.07% |
LG-DKGP 在五项任务上的成功率分别为 PushT 97.60%、Cube 98.80%、Caddy 83.32%、Scene2 76.96%、RoboTwin 78.66%,其中四项任务取得最高平均成功率。Scene2 上,INTACT 为 77.53%,LG-DKGP 为 76.96%。
差异最突出的是 RoboTwin:LeWM 的成功率为 10.91%,LG-DKGP 达到 78.66%。这表明,在相同的视觉目标规划框架下,候选动作的组织方式和搜索初始化可以显著改变控制结果。
这里的宏平均成功率指五个任务成功率的等权平均。PushT 和 Cube 依据原生任务成功标准评估,Caddy、Scene2 与 RoboTwin 则包含论文定义的局部目标达成判定。
06.
为什么有效?消融实验告诉我们答案
消融实验图
第一,GP 残差提供了有效的时间结构修正。 去掉 GP 残差、保留其他规划设置后,宏平均成功率下降 3.80 个百分点。
第二,局部和全局历史需要动态结合。 只用局部注意力,成功率下降 2.08 个百分点;只用全局注意力,下降 7.58 个百分点。最近的运动趋势与较长时间的任务阶段信息,都能影响下一段动作。
第三,搜索尺度要与专家动作相匹配。 使用固定尺度,宏平均成功率为 74.92%;换成专家动作变化统计得到的尺度后,提升到 87.07%。在 RoboTwin 上,这一改变使成功率从 18.88% 提升至 78.66%。
第四,合理的动作先验与面向目标的搜索彼此互补。 直接执行先验均值时,PushT 的成功率为 58.40%;加入 CEM 搜索后达到 97.60%。Caddy 则从 60.82% 提升到 83.32%。动作先验提供好的起点,世界模型搜索负责进一步选择。
还有一个值得研究的现象:去掉先验中的视觉条件,整体成功率下降 8.86 个百分点,但 Caddy、Scene2 和 RoboTwin 上的表现反而有所改善。这说明视觉目标与动作历史的最佳融合方式具有任务依赖性。
07.
成功率之外:生成的动作是否更像专家?
动作连续性的目标,是保留专家示范中的动作转换结构。为此,论文根据不同时间跨度的动作增量构造特征,并使用 MMD² 等指标比较规划动作与专家动作。
在逐个场景—目标查询的配对实验中,LG-DKGP 相比 LeWM 更接近专家动作结构的比例分别达到:PushT 83.6%、Cube 90.0%、Caddy 99.5%、Scene2 98.2%、RoboTwin 100%。
研究还发现,简单地重复专家的第一个动作 25 次,在部分任务上也能得到较低的 MMD²。这说明单一分布距离不足以描述动作质量:判断生成动作是否真正符合专家的行为结构,还需要结合动作变化曲线与闭环任务成功率。
08.
技术启示:世界模型的瓶颈,不只在“世界”
这项工作揭示了世界模型规划中两个不同的能力:预测动作会造成什么后果,以及提出什么样的动作序列值得预测。
即使冻结世界模型,只改进候选动作的连续性结构和搜索初始化,也能够明显提升控制成功率。
同时,专家示范提供了两类可以利用的信息:一类是动作随任务阶段演进的时间依赖,另一类是动作变化的典型尺度。前者帮助预测下一段动作,后者帮助确定搜索范围。
因此,提升世界模型规划,不仅可以优化预测器,也可以从动作提议机制本身入手。
09.
下一步:更长任务、更低开销、更真实的执行
现有实验主要集中在仿真环境和 25 步动作预测窗口。随着目标距离超出预测窗口,规划成功率会下降;CEM 每次规划需要 300 × 30 次候选评估,也给实时控制带来计算开销。
下一步的重点,是让历史长度、规划窗口和重规划频率随任务阶段自适应调整,减少世界模型评估成本,并在真实机械臂与更长时序任务中检验专家式动作连续性的效果。
10.
总结:让下一步,接得上上一步
LG-DKGP 将专家示范中的动作连续性转化为可学习的动作先验,再交给冻结的世界模型和目标导向搜索判断哪段动作值得执行。
世界模型不仅要看得见未来,还要接得住过去。
论文信息
标题: Rethinking Actions: Continuity-Aware Priors for World-Model Planning
作者: Shaobo Yang, Zichen Ai, Ziyang Ma, Qian Yang, Bin Fang
论文: https://arxiv.org/abs/2611.16645
开源代码: https://github.com/oliverstack-byte/LG-DKGP
来源:CAAl认知系统与信息处理专委会
来源:机器人大讲堂