前沿语言模型已经开始编写机器人控制器。在 RoboDojo Sim 上,Claude Fable 5.2 的得分为 64.9%,而 GPT-6 Astra 为 29.8%。在 Code as Policies(CaP)中,LLM 将控制器编写为代码,在真实系统上运行,然后根据执行结果进行修改(Liang et al., 2022)。ASPIRE(Lu et al., 2026)进一步将这一过程扩展为具备自主技能发现能力的智能体。当模型越来越频繁地修改程序时,真实世界评估便成为整个流程的瓶颈。
少量真实测试几乎无法证明什么。即使连续五次试验全部成功,在 95% 置信水平下,也只能说明真实成功率高于 55%。当 LLM 编写代码的速度远快于机器人执行测试的速度时,五次试验可能分散在多个连续版本之间,每个版本只被测试一次。此时,即使某个版本成功一次,也只能说明其真实成功率高于 5%。LLM 之所以能够在代码和数学领域发挥作用,一个重要原因是其输出可以通过自动化方式验证(Cobbe et al., 2021;Lightman et al., 2023)。机器人控制代码目前还没有这样的验证器。
本文探索的问题是:当一个通用 Coding Agent 面对未知物理系统,并且没有现成测试环境时,它能否利用少量真实试验,在自己的 Harness(即编写和运行程序的系统)中自行构建测试环境?这里所说的验证,是指在部署之前,通过世界模型运行程序,对其成功概率进行经验估计。
我们在八项任务上比较了两种智能体。CaP 智能体在每次真实试验后修改控制程序;World Model 智能体则首先编写一个世界模型,即一个包含数百行代码的 Python 文件,用于模拟任务,并在部署前对程序进行测试。以下八项任务按照测试带来的帮助从小到大的顺序排列:
无人机沿两条固定路线穿越峡谷,同时应对受损旋翼和隐藏风场。
电缆布线任务,存在隐藏的刚度、摩擦力,以及实时载荷读数。
在随机敌方火力下,于 Doom 中生存。
推动一个 T 形方块,然后推动一个此前未见过的 L 形方块。两个方块的质心都被秘密移动,初始位置也随机变化。
无人机穿越峡谷的任务,但每个 Episode 中还会随机出现七至八架其他飞行器。
将绳子抛过一个立柱,使其进入目标区域。绳子具有可变形特性,每次只能尝试一次,并且对微小变化极为敏感。
在无人机任务的一个变体中,每个 Episode 都会有七至八架其他飞行器沿随机路径穿越峡谷。World Model 智能体在第一次真实试验中,将无人机悬停了完整的 19.4 秒,除了记录其他飞行器的运动轨迹之外什么也没做。根据这些记录,它在世界模型中编写了四种飞行器行为类型,并在模型中测试控制器。仅通过这一次观察试验,其真实成功率就从 50% 提升到了 97%。
世界模型在这里发挥着类似普通软件单元测试的作用:每个候选程序在部署之前,都要先在世界模型中运行。将世界模型编写为代码,是在智能体 Harness 内部提供此类测试的一种方式(Weng, 2026)。此前已有多个研究团队尝试将世界模型表示为代码(Dainese et al., 2024;Tang, Key and Ellis, 2024;Meta FAIR, 2025;Wang et al., 2026;Chen, Lin and Zhang, 2026)。本文进一步让智能体根据试验过程中记录的信息估计模型参数,并在部署前利用模型验证控制器。
这些实验表明,世界模型未必需要是一个通过数千次 Rollout 训练得到的神经网络。一个包含数百行代码、根据智能体自身实验即时拟合的 Python 文件,就可能成为代码生成与物理部署之间的单元测试层。在我们的实验中,这种规模的模型已经接近拥有真实模拟器的规划器:在绳子抛掷任务中,成功率达到 78%,而 Oracle Planner 为 84%;在此前未见过的 L 形方块任务中,基于 8 次真实试验、通过测试筛选出的 CaP 程序,在 Held-out 测试中达到 84%,而 Oracle Planner 为 80%。当我们公布一条新的无人机路线,但不提供任何额外真实试验时,智能体复用了已有世界模型,在 19.5 秒的搜索中找到了成功率为 100% 的控制器。在第一条无人机路线任务中,使用相同五次真实试验的 PPO 和学习型神经动力学模型,测试结果均为 0/50。
主动观察(Active Observation)
1. 观察(Observe)
智能体通过少量真实试验观察和探测系统。在无人机任务中,它曾悬停完整个试验周期,以记录其他飞行器的运动情况。在推动方块任务中,它执行了两次预设推动操作,以确定方块的质心位置。
2. 编写世界模型(Write the World Model)
智能体将观察结果编写为一个 14–26 KB 的 Python 文件。仪器手册中没有提及的物理特性,例如旋翼性能下降或质心偏移,都被转化为明确的模型参数,并根据真实试验进行估计。
3. 运行测试(Run the Tests)
每个候选程序在进行下一次真实试验之前,都要先在世界模型中运行。测试覆盖大量随机 Episode,以及多个参数经过扰动的模型副本。在推动方块任务中,15 个程序的 3,000 次模拟 Episode 仅耗时 19 秒。
4. 部署,或在执行过程中持续测试(Deploy, or Test While Acting)
通过测试的程序才会被部署到真实系统。在绳子抛掷任务中,测试直接在 Episode 执行过程中进行。控制器每隔 0.16 秒就在世界模型中测试候选抛掷动作,并执行其中表现最好的一个。
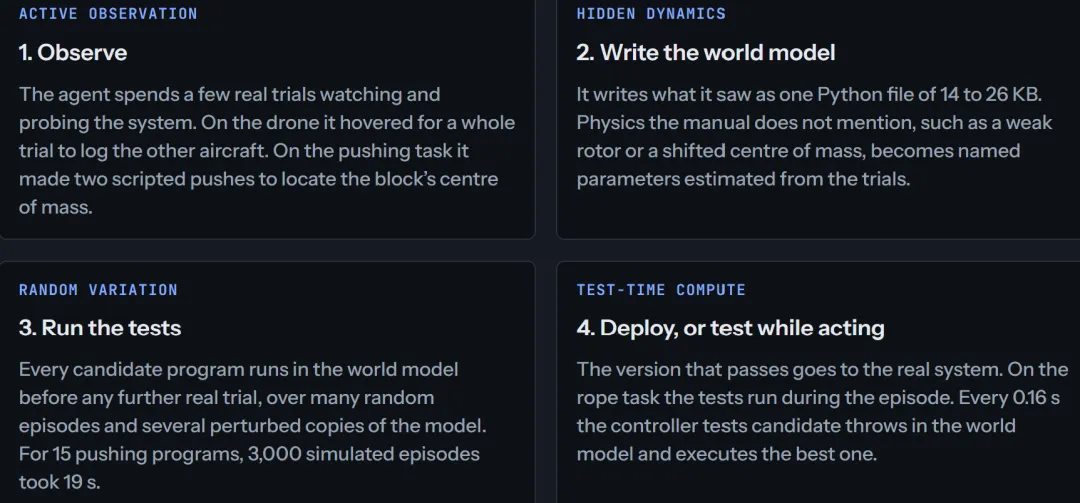
图 1. 智能体从观察系统到部署通过测试的程序,完整构建和使用测试环境的流程。
主动观察。 World Model 智能体会在采取行动之前主动决定应该观察什么。在方块推动任务中,两次预设推动操作就几乎精确地定位了隐藏的质心。
隐藏动力学。 物理系统中存在仪器手册没有说明的变化:旋翼性能下降、横风扰动,以及质心偏移。对于绳子任务,当一个顶点移动仅仅 1 微米时,带有加重末端的绳子,其落点就可能发生数厘米的变化。世界模型将旋翼性能下降、风场和质心偏移显式表示为估计参数。对于绳子,模型能够在短时间预测范围内较好地复现其运动,从而测试抛掷动作,而不需要识别末端配重。
随机变化。 当不同 Episode 存在随机变化时,少量真实试验提供的信息非常有限。测试需要在大量模拟 Episode 中运行,并使用参数略有差异的多个模型副本,确保程序即使在模型并不完全准确的情况下也能成功。在存在其他飞行器的无人机任务中,World Model 智能体在未见过的 Episode 上达到 98% 的成功率,而使用相同五次试验的 CaP 智能体只有 49%。在绳子抛掷任务中,控制器在执行每次抛掷之前,都会先在多个世界模型副本中测试该动作。
Test-time Compute。 验证过程将计算开销从真实试验转移到了计算资源上:数千次模拟 Episode 可以在几秒内完成程序排序。借助世界模型提供的测试环境,CaP 智能体在没有增加任何真实试验的情况下,将无人机交通任务的成功率从 76% 提升到了 95%。在绳子抛掷任务中,执行每一步之前先在模型中测试候选动作,使成功率达到 78%;而仅通过真实试验修改程序的方式,成功率只有 0–2%。
当以下三个条件同时存在时,这类测试可能发挥最大价值:Episode 存在随机变化;物理系统包含智能体未被告知的隐藏变化;控制器无法利用实时信号进行自我纠正。
我们在四种模拟器中的八项任务上进行了实验。CaP 智能体参考 ASPIRE 实现,并受到最多五次真实试验的限制。每个世界模型都是一个独立的 Python 文件,大小为 14–26 KB,其中包含动力学方程、碰撞规则,以及根据智能体观察日志拟合的摩擦参数。这些测试并不总是准确:它们能够较好地对程序进行排序,但会高估绝对成功率。
代码仓库包含八个环境、智能体生成的所有程序和世界模型,以及记录的实验结果。通过运行 reproduce.py,可以重新执行任意冻结的控制器,并将复现结果与原始记录进行对比。代码采用 MIT License。仓库还提供了一个小型 Harness,供研究者在自己的环境中尝试这一流程,不过目前尚未有模型通过该 Harness 运行。实验结果也作为数据集发布在 Hugging Face 上,推动方块任务的运行过程可以在交互式 Space 中逐个 Episode 回放。
1. 真实世界评估是瓶颈:智能体无法判断策略好坏
真实世界评估是整个流程的瓶颈:智能体无法判断自己编写的策略代码究竟好还是坏。LLM 可以在几秒钟内编写一个新控制器,但在真实系统上评估它却需要数分钟,同时还要消耗硬件资源并承担风险。机器人操作策略的真实世界评估难以规模化,也难以复现(Li et al., 2024;Kress-Gazit et al., 2024)。在 Code as Policies 中,LLM 将控制器编写为可执行代码,在真实系统上运行,再根据结果进行修改。我们构建的 CaP 智能体参考 ASPIRE 的实现方式,并将真实试验次数限制在五次,通过在真实环境中运行程序来验证其效果。
Push-T 展示了这一瓶颈在实际任务中的表现。智能体需要推动一个 T 形方块,使其与目标轮廓对齐。我们将方块的质心从标称位置 移动到了 ,但智能体并不知道这一变化。如果规划器仍然相信标称物理参数,其成功次数为 0/20。
我们给智能体五次真实 Episode 来推断这一变化。在第三次试验结束后,它已经生成了一个能够在 50 个未见过的 Episode 中解决 96% 任务的程序;但在第四次试验后,它生成的程序成功率却下降到了 16%。
由于五次测试 Episode 全部成功,智能体最终部署了成功率仅为 16% 的版本。之后,我们在它实际测试过的五个随机种子上重新运行该程序,发现它实际上只解决了其中一个。其余四个任务此前都是由更早版本的程序成功完成的。
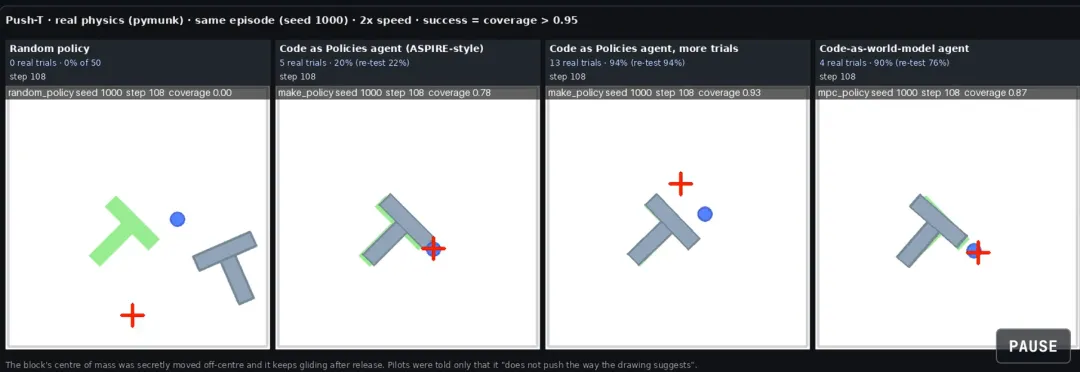
图 2. 在同一个 Push-T Episode 中比较四种控制器。随机策略失败;使用五次真实试验的 Code-as-Policy 在覆盖率达到 0.94 时超时,未达到超过 0.95 的成功阈值;使用 13 次真实试验的 Code-as-Policy 成功完成任务;使用四次真实试验的 Code-as-World-Model 智能体同样成功完成任务。
在推动方块任务中,我们发现 CaP 智能体生成的最佳程序,其得分实际上高于 World Model 智能体基于规划器生成的控制器:Push-T 上分别为 96% 和 82–90%,Push-L(L 形方块变体)上分别为 78% 和 66%。然而,在仅有五次真实试验的情况下,CaP 智能体无法识别哪个版本才是最好的。
两个智能体均使用 Claude Opus 5.5,只能查看仪器手册和自身的试验记录。我们使用正式模拟器代替真实物理系统,包括 VizDoom、基于 PyBullet/PyFlyt 的四旋翼无人机、基于 pymunk 的平面推动任务,以及 MuJoCo 中的电缆操作任务。不同团队分别构建了这些环境,并在其中植入智能体事先不知道的隐藏变化。每个智能体在每项任务中最多只能进行五次真实试验,并通过预算计数器进行限制。没有测试机制时,智能体只能部署自己最终生成的程序,无论其表现好坏。
不让智能体接触模拟器
为避免模拟器基准测试中常见的循环论证问题,我们实施了严格的隔离机制。Opaque Environments对智能体隐藏所有源代码,由独立的智能体负责构建。其中,Doom、无人机和推动任务由 Claude Sonnet 5.5 构建,电缆任务由 Claude Opus 5.5 构建。这些环境构建智能体可以访问真实模拟器,但执行任务的智能体无法访问。后者只能通过一个由仪器手册(Instrument Manual)**记录的精简 API 与环境交互。我们要求执行任务的智能体只能阅读仪器手册和自身的实验日志。
通过预算计数器(Budget Counter),每个智能体用于观察系统的真实试验次数被严格限制在 5 次。如果世界模型尝试导入模拟器或环境程序包,Import Guard 测试就会直接失败。实验结束后,我们还会审查智能体生成的代码。环境构建团队还在环境中植入了多种隐藏异常,包括旋翼受损、质心偏移、横风扰动、方块释放后的滑动,以及电缆刚度和阻力变化,但这些信息均未在仪器手册中披露。
评估(Evaluation)使用了智能体在观察试验中从未见过的随机种子(Doom 和无人机 Mission C 使用 1000–1099,其余任务使用 1000–1049)。此外,我们还使用第三组随机种子(5000 及以上)独立运行重新测试(Re-test),作为第二轮验证。
2. 系统辨识:智能体先观察,再采取行动,并根据观察构建测试
在尝试完成任务之前,智能体会利用最初几次真实试验收集信息:例如悬停观察其他飞行器,或通过推动方块确定其隐藏质心。这属于主动系统辨识,即先探索,再利用。
我们构建了一架需要穿越狭窄峡谷并经过三个检查点的四旋翼无人机。我们向两个智能体隐藏了两项变化:一个受损旋翼和横风扰动。不同 Episode 之间的变化很小,因此旋翼损伤和风场在各个 Episode 中基本保持一致。
无人机任务细节
时间窗口:17 秒。受损旋翼只能产生正常推力的 60%。峡谷中存在两处横风扰动,风场加速度分别约为 14.8 m/s² 和 11 m/s²。
在第一条路线(Mission A)中,我们发现不同控制器的表现呈现明显的两极分化:要么成功率为 0%,要么达到 98–100%。
原始自动驾驶仪由于速度上限为 2 m/s,无法在规定时间窗口内完成任务,成功率为 0/50;使用五次真实试验训练的 PPO,以及学习型神经动力学模型,成功率同样为 0/50。相比之下,CaP 智能体在一次坠机试验后便生成了成功率为 100% 的控制器,而 World Model 智能体在一次真实试验后达到 98%,两次试验后达到 100%。
World Model 智能体的飞行速度更快,耗时 8.03 秒,而 CaP 智能体耗时 9.50 秒;同时,它飞行时距离峡谷墙壁也更近,最小间距为 0.21–0.26 m,而 CaP 智能体为 0.53–1.1 m。
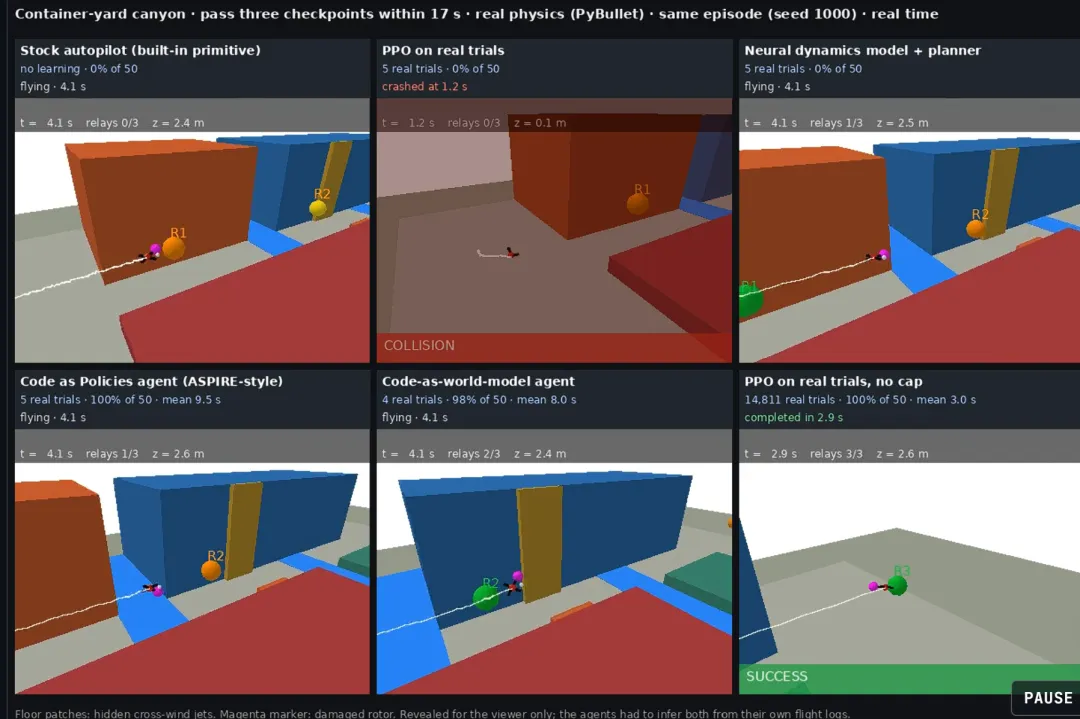
图 3. 在同一个 Mission A Episode 中比较六种控制器。图中为便于观察者理解而绘制了风区和受损旋翼,但这些信息对智能体不可见。原始控制器、PPO(五次真实试验)和神经动力学模型(五次真实试验)均发生坠毁。Code-as-Policy 用时 9.4 秒完成任务,Code-as-World-Model 智能体用时 8.0 秒。使用 14,811 次真实试验训练的 PPO 则用时 2.9 秒。
完成 Mission A 后,我们公布了一条新路线,但不再提供任何真实试验。两个智能体都在 Mission B 上取得了 100% 的成功率。World Model 智能体复用了已有世界模型,仅通过 19.5 秒的搜索就找到了一个控制器。
在 Mission C(同一峡谷中每个 Episode 随机出现 7–8 架其他飞行器)以及初始方块位置随机变化的推动任务中,我们发现不同程序版本之间的成功率波动非常明显。我们事后在从未见过的随机种子上重新评估了智能体留下的每一个程序版本,测试规模超过 6,000 个 Episode,并按照消耗的真实试验次数建立索引。由此得到了一条 LLM 修改自身代码时的学习曲线。
CaP 智能体: 它编写的每一个程序版本,以及最终提交评估的版本。
Code-as-World-Model 智能体: 它生成的每一个控制器。
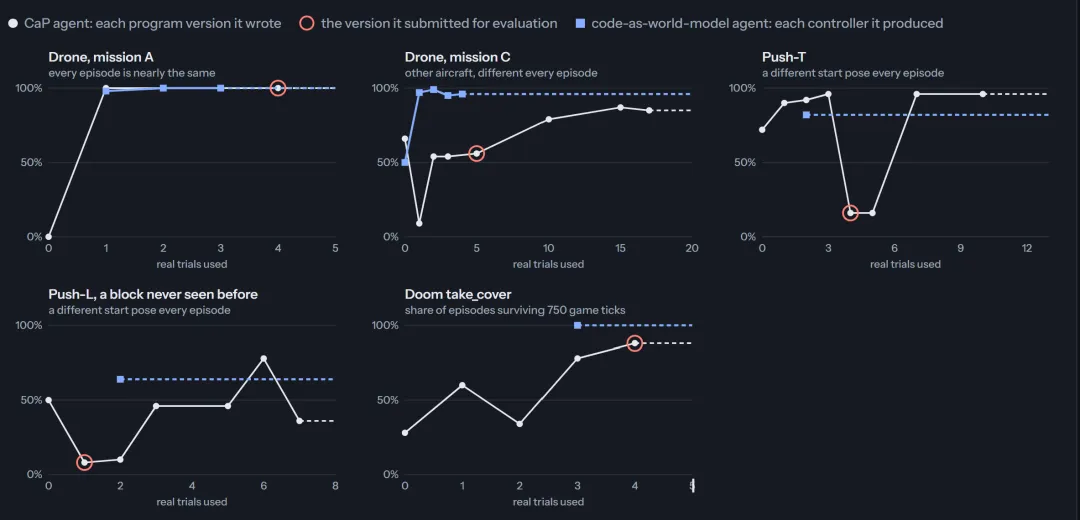
图 4. 五个面板分别展示无人机 Mission A、无人机 Mission C、Push-T、Push-L 和 Doom 的实验结果。黑色圆点及其连线表示 Code-as-Policy 智能体生成的不同程序版本,横坐标表示该版本生成前已经消耗的真实试验次数。带圆环的点表示最终提交评估的版本,其成功率是在智能体从未见过的 Episode 上测得的。蓝色方块表示 Code-as-World-Model 智能体生成的控制器。纵轴表示在未见过的随机种子上的真实成功率。对于 Doom,指标是在 750 个游戏 Tick 内存活的 Episode 比例(Doom 的运行速度为每秒 35 Tick)。
在 Push-T 任务中,CaP 智能体在三次真实试验后达到 96% 的峰值,但第四次试验后却下降到 16%,最终部署的也是这个较弱版本。在 Mission C 中,不同程序版本的成功率介于 9% 和 87% 之间。在 Push-L 中,成功率在六次试验后达到 78%,但下一次代码修改后又下降到了 36%。我们观察到,成功率并不会单调上升。最好的程序版本可能已经出现,却没有被智能体识别出来。
完整学习曲线
CaP 智能体。 Push-T:72% → 90% → 92% → 96% → 16% → 16% → 96% → 96%。Mission C:66% → 9% → 54% → 54% → 56% → 79% → 87% → 85%。Push-L:50% → 8% → 10% → 46% → 46% → 78% → 36%。Doom 的平均存活时间(游戏 Tick):596 → 1,049 → 648 → 1,889 → 2,455。
World Model 智能体。 Drone A:98% → 100% → 100%。Drone C:50%(未经修改的 Mission A 控制器)→ 97% → 99% → 95% → 96%。Push-T:经过 2 次真实试验后达到 82%。
Doom 智能体在真实试验中观察到的存活时间恰好呈上升趋势(分别为 296、638、811、883、2,095 个游戏 Tick),掩盖了第二次真实试验后实际出现的一次性能下降。
飞行时间。 Mission A:World Model 智能体成功率为 98%(49/50)。Mission B:Code-as-Policy 的飞行时间为 13.98 秒,World Model 智能体为 11.28 秒。起点和检查点的位置抖动均小于 1 米。两处风场的强度约有四分之一的波动。
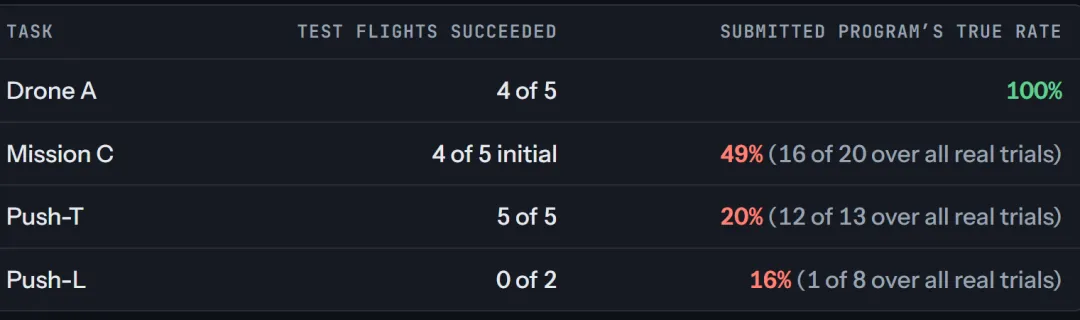
智能体通过观察构建测试的最典型案例出现在 Drone C 中。World Model 智能体将第一次真实试验完全用于观察:它在起始位置悬停了完整的 19.4 秒,记录所有其他飞行器的运动轨迹,然后才修改控制器。根据这些记录,它将四种行为类型写入世界模型。我们原本以为它会直接起飞,结果它选择了观察,并根据观察结果编写了自己的测试。
智能体观察到的随机种子是否比评估随机种子更容易?
一个自然的疑问是:智能体在真实试验中使用的随机种子,是否系统性地更容易?我们对此进行了验证。
结果显示,同一程序版本在随机种子 0–99 上的表现,与在 1000+ 和 5000+ 随机种子上的表现基本一致。
CaP 智能体最终提交的 Push-T 控制器,在这三个随机种子区间上的成功率分别为 16% / 20% / 22%。
在 Mission C 中,CaP 智能体的成功率分别为 52% / 49% / 48%;World Model 智能体的成功率分别为 92% / 98% / 95%。
智能体在观察试验中看到的结果与评估器测得的结果之间存在差异,其根源在于:少量采样结果与真实底层分布之间存在差距。
3. 世界模型中的策略评估:预测成功率与真实成功率的相关系数达到 r = 0.97
世界模型可以充当策略评估模拟器:每个候选程序都在大量模拟 Episode 中运行,并根据结果进行评分。模型预测的得分与真实表现高度相关。在 34 个程序的评估中,平均误差为 5.2 个百分点,相关系数为 。
Code-as-World-Model 智能体将世界编写为一个小型 Python 文件,根据真实 Episode 日志拟合模型参数,并在世界模型中测试控制器。每次真实试验背后,它都会在模型中运行数百万个模拟步骤。
在 Mission C 中,智能体的第一次真实试验完全用于观察。我们观察到它在起始位置悬停了完整的 19.4 秒,并记录了所有其他飞行器的运动轨迹。根据这些记录,智能体在世界模型中编写了四种飞行器行为类型:沿峡谷方向和横穿峡谷方向往返运动的飞行器(shuttlers)、在随机航点之间移动的飞行器(wanderers),以及受到干扰后会主动接近的飞行器(chasers)。它还设置了略宽于实际观察范围的生成位置区间和运动参数。
在世界模型中,智能体发现,除了追踪型警戒飞行器之外,其他类型的飞行器都保持在 1.6–3.6 m 的高度范围内。于是,它设计了一条位于 4.8 m 高度的飞行路线,并在每个检查点进行陡峭下降。
在模型内测试时,Mission A 控制器的成功率为 22–37%;仅调整飞行高度后,成功率达到 78–84%;进一步加入避障和参数调优后,成功率达到 94%。部署到真实环境后,其 Held-out 成功率达到 98%,重新测试时达到 95%。
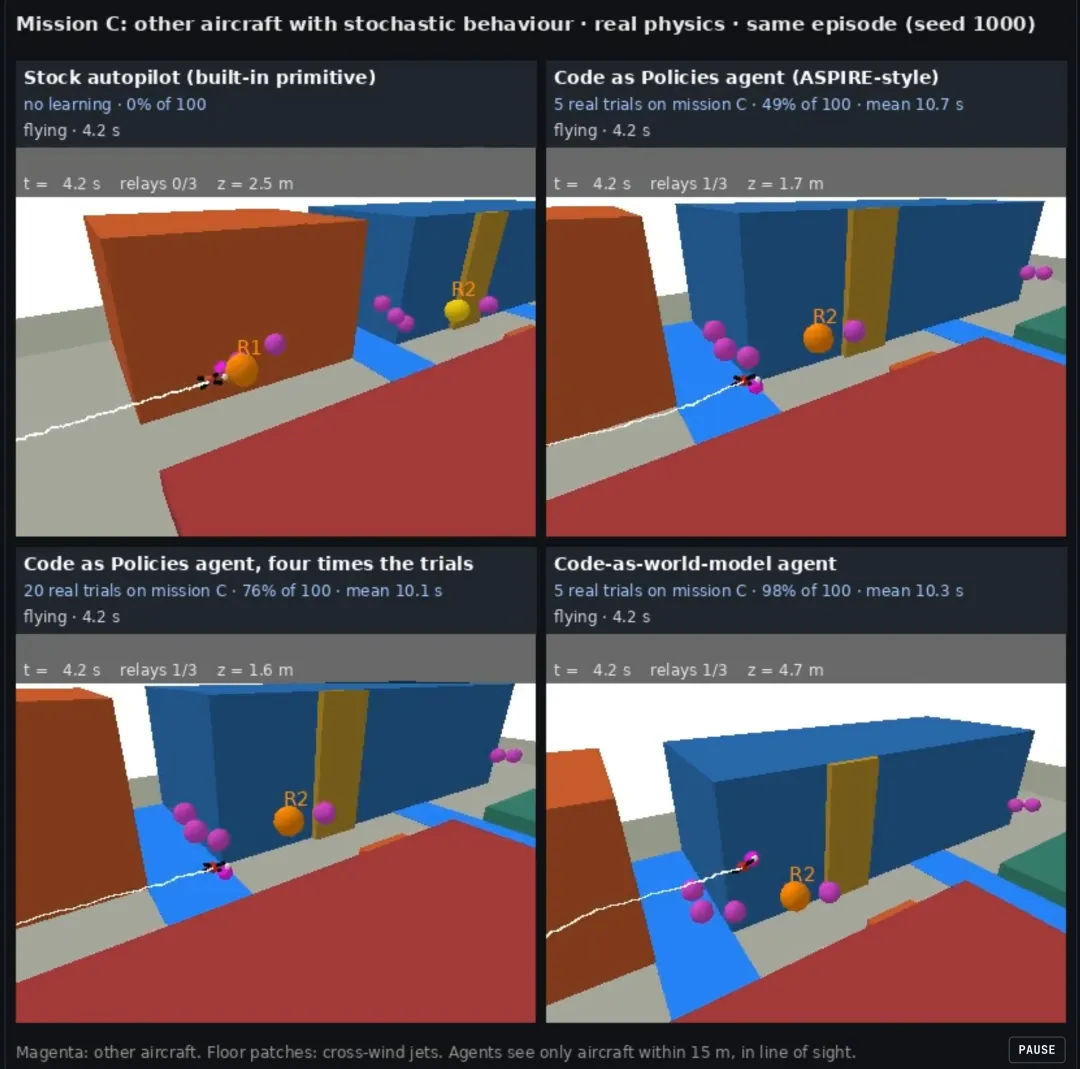
图 5. 在同一个 Mission C Episode 中比较四种控制器。其他飞行器以洋红色球体表示。原始自动驾驶仪发生坠毁;使用五次真实试验的 Code-as-Policy 也发生坠毁;使用 20 次真实试验的 Code-as-Policy 成功完成任务;使用五次真实试验的 Code-as-World-Model 智能体则通过爬升到其他飞行器上方,再下降到各个检查点,成功完成任务。
在 Push-T 中,World Model 智能体将四次真实试验中的两次用于预设探索性推动操作,然后根据观察到的运动拟合质心位置。其估计精度超出了我们的预期:估计值为 ,真实值为 ,误差仅为 0.1 个单位。相比之下,CaP 智能体估计的质心约为 ,与真实位置相差约 25 个单位。随后,World Model 智能体在世界模型中运行了约 1.73 亿个模拟步骤,用于调整其采样式规划器。
在 Push-L(一个此前未见过的 L 形方块)任务中,智能体仅使用两次真实试验。它继承了 Push-T 的世界模型,根据仪器手册替换为 L 形方块的几何结构,并重新拟合质心,得到 ,而真实值为 ,误差仍然小于一个单位。此外,它还发现了 T 形方块中不存在的接触摩擦,并将其估计为 0.4,而真实的摩擦系数为 0.36。
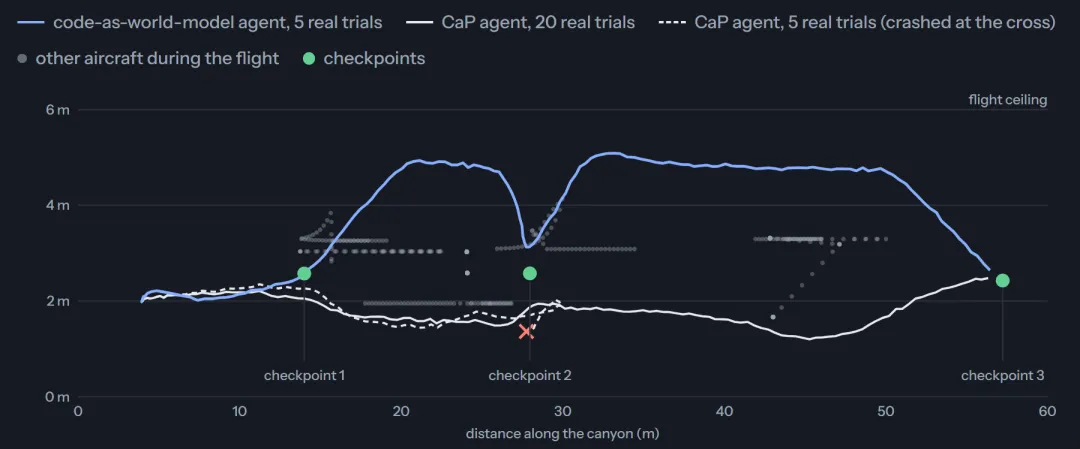
图 6. 同一个真实 Mission C Episode 中的飞行高度与飞行距离关系。灰色点表示其他飞行器(在该 Episode 中高度为 1.7–4.1 m)。Code-as-World-Model 智能体的控制器(蓝色)先爬升到约 5 m,再下降到各个检查点。使用 20 次真实试验的 Code-as-Policy 程序(黑色实线)保持在 1.2–2.5 m 的高度范围内。使用五次真实试验的程序(黑色虚线,标记为叉号)则发生坠毁。
Sim-to-Real 相关性:无人机任务表现接近,但推动方块和 Doom 存在明显偏差
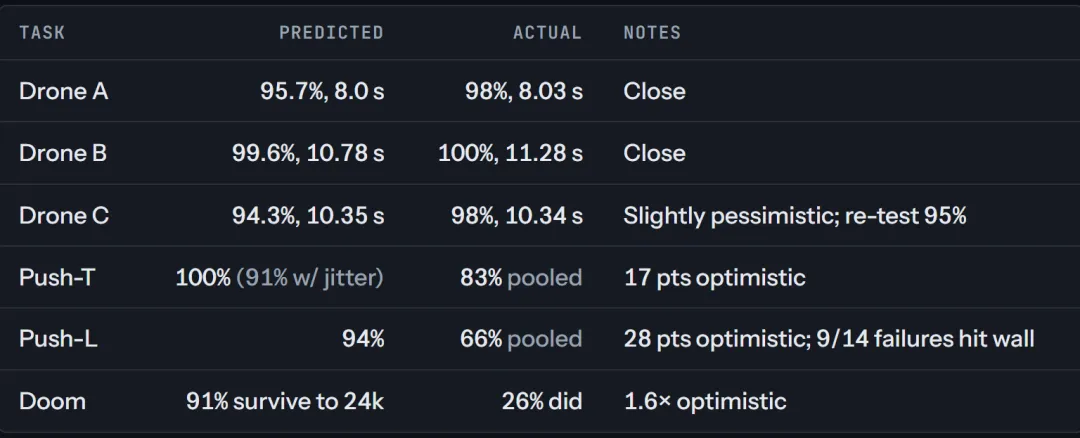
在无人机任务中,测试结果与真实表现仅相差几个百分点。在推动任务中,模型将成功率高估了 17–28 个百分点,在 Doom 中则高估了约 1.6 倍。即便如此,这些测试仍然能够区分那些仅通过五次真实试验无法判断优劣的控制器。
我们进一步研究了这些测试能否评估开发过程中从未见过的程序。我们收集了所有任务中 CaP 智能体生成的每个版本,共计 34 个程序,并在世界模型中运行它们。该世界模型仅根据 World Model 智能体自身的观察试验日志拟合,之前从未见过任何 CaP 程序或其实际表现。唯一例外是,推动任务的 World Model 智能体曾在某个程序的文档字符串中看到过 Push-T v5 的 Held-out 测试结果,即 10/50。
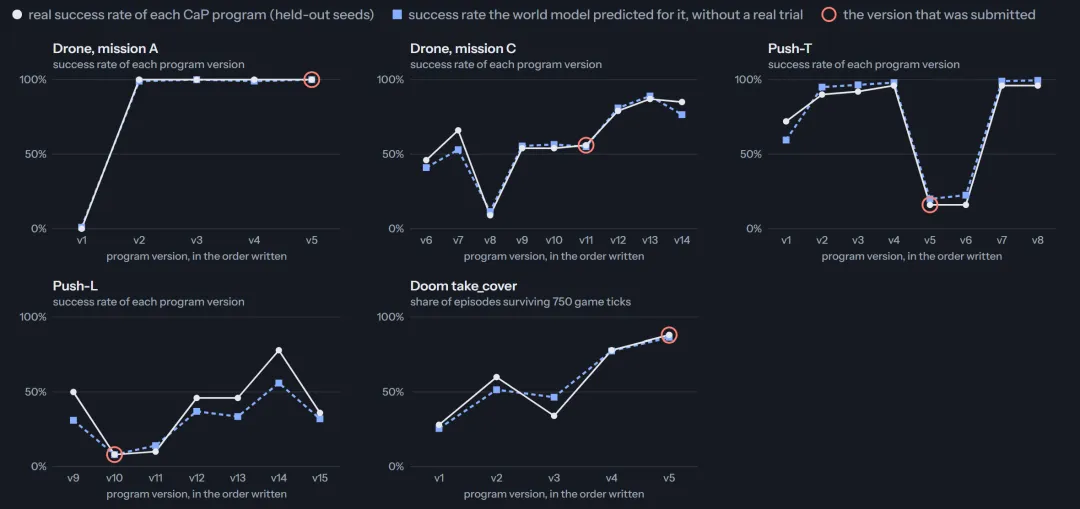
图 7. 五个小图分别展示各项任务。每个图的横轴表示按生成顺序排列的程序版本。实线及圆点表示真实成功率(在未见过的随机种子上测得);虚线及方块表示世界模型的预测成功率;圆环标记表示最终提交的版本。平均绝对误差为 5.2 个百分点,Pearson 相关系数为 0.974。
在五项任务中,模型预测与真实结果保持了较高的一致性,平均绝对误差为 5.2 个百分点,Pearson 相关系数为 0.974。分任务来看:
Drone A:平均绝对误差 0.6 个百分点(5 个程序)。
Drone C:平均绝对误差 4.2 个百分点(9 个程序)。
Push-T:平均绝对误差 5.1 个百分点(8 个程序)。
Doom:平均绝对误差 5.1 个百分点(5 个程序,以存活至 750 个游戏 Tick 的比例计算)。
Push-L:表现最差,平均绝对误差为 10.1 个百分点,其中一个预测结果偏差达到 22 个百分点。
在 Push-L 中,世界模型对七个版本中的五个低估了成功率,与其中一个版本的预测完全一致(v10:预测 8%,实际 8%),对另一个版本则高估了 4 个百分点(v11:预测 14%,实际 10%)。
仅看推动任务(15 个程序),世界模型在 19 秒内运行了 3,000 个模拟 Episode,能够准确跟踪不同版本的表现变化。例如,Push-T v4 在真实环境中的成功率为 98%,世界模型预测为 97%;v5 在真实环境中的成功率为 20%,世界模型预测为 25.5%。
这里的筛选是在事后完成的。实验过程中真正使用这些测试的,是 CaP-in-World-Model 实验(第 4 节)。在这两项推动任务中,测试都向智能体揭示了一个事实:它最近一次修改反而让程序变得更差。
Code-as-Policy 智能体能够编写出性能很强的程序,但缺乏测试机制来选择最佳版本。World Model 测试则对全部 34 个程序进行了排序,平均绝对误差为 5.2 个百分点,相关系数为 0.974。
Sim-to-Real Gap:测试高估了推动任务和 Doom 的成功率
我们的测试属于近似验证器。它们高估了推动任务、Doom 和绳子任务的绝对成功率:Push-T 高估 17 个百分点,Push-L 高估 28 个百分点,Doom 高估约 1.6 倍;在绳子任务的第一个控制器上,模型预测成功率为 100%,实际只有 32%。
在 Push-L 中,模型的排序能力在所有任务中最差,平均绝对误差为 10.1 个百分点,最大误差达到 22 个百分点。对于绳子任务,由于几乎所有程序的成功率都只有 0–2%,目前还无法在具有实际区分度的范围内评估世界模型作为程序评估器的能力。
这些测试真正发挥作用的地方在于程序排序:即使绝对成功率预测存在偏差,相对排序仍然能够保持一致。第 6 节将进一步讨论绳子任务中预测成功率与真实成功率之间的差距。
4. Real-to-Sim-to-Real:无需增加真实试验即可迁移改进结果
智能体根据真实试验构建一个小型模拟环境,在其中改进策略,然后将改进后的策略迁移回真实环境,整个过程不需要增加任何真实试验。这构成了一个 Real-to-Sim-to-Real 闭环(Torne et al., 2024),区别在于这里的模拟器是智能体自行编写的 Python 文件。
我们将 World Model 智能体已经构建好的世界模型提供给 CaP 智能体,让它在数万个模拟 Episode 中验证每个程序版本,整个过程中不再增加真实 Episode。
在无人机 Mission C 中,我们以 CaP 智能体经过 20 次真实试验得到的程序为起点,其 Held-out 成功率为 76%。随后,在没有增加任何真实 Episode 的情况下,我们运行了约 22,650 个模拟 Episode,耗时 157 秒。
在 100 个真实 Held-out Episode(随机种子 1000–1099)上评估,成功率达到 95%,平均完成时间为 9.86 秒。在另一组未见过的随机种子 5000–5099 上重新测试,成功率同样为 95%,平均耗时为 9.68 秒。作为对比,同一个智能体仅使用五次真实试验时,成功率为 49%。World Model 智能体自身的控制器则分别达到 98% 的 Held-out 成功率和 95% 的重新测试成功率。
在 Push-L 中,我们以 CaP 智能体经过八次真实试验得到的程序为起点,其 Held-out 成功率为 46%。获得世界模型后(该模型继承自 Push-T,最初使用四次真实试验构建,并利用 World Model 智能体在 Push-L 上的两次真实试验重新拟合),我们运行了约 20,800 个模拟 Episode,耗时 249 秒,同样没有增加任何真实 Episode。
最终,该程序在 50 个 Held-out Episode(随机种子 1000–1049)上达到 84% 的成功率,在重新测试随机种子 5000–5049 时达到 80%。World Model 智能体自身的控制器在两组测试中的成功率分别为 72% 和 62%。作为对照,使用真实模拟器的规划器(Oracle Planner)在 Push-L 上达到 80%。
这意味着 CaP 与世界模型结合后的表现超过了两个智能体各自单独运行的结果。
在这两项任务中,测试都发现了程序回归问题:CaP 智能体最近一次根据真实飞行结果进行的修改,实际上让程序表现变差了。Code as Policies 负责编写控制器结构,世界模型则提供了选择正确版本所需要的测试套件。
5. 闭环反馈与长尾失败:反应式策略已经足够,但测试仍能发现罕见故障
当系统能够实时提供定义任务失败的关键指标时,采用反应式反馈策略就足够了,世界模型并不会进一步提升成功率。但少量成功的真实试验可能掩盖长尾失败,而在大量模拟布局中运行测试,可以暴露五次真实成功试验未能发现的故障。
我们增加了一项可变形电缆操作任务:一根约 1 m 长的电缆放在桌面上,智能体需要将其绕过三个立柱。系统每一步都会提供力读数,超过力阈值就意味着 Episode 失败。我们向智能体隐藏了三项物理参数变化,这些变化会导致快速拉动电缆时产生过载。每个 Episode 的布局都不相同。
电缆任务细节
该任务在 MuJoCo 中模拟,将电缆建模为由弹性线段连接而成的链条。一端固定,另一端由操作工具夹持。工具以 20 Hz 的频率接收二维位置指令,最大运动速度限制为 0.30 m/s。
任务要求电缆最终按照规定的缠绕方向绕过每个立柱(通过缠绕角度规则判定),同时操作工具必须停留在距离目标位置 2 cm 以内。力的上限为 10 N,任务时间限制为 30 秒。
隐藏的物理参数变化: 电缆弯曲刚度提高至标称值的 3 倍;电缆与立柱之间的摩擦系数从 0.3 提高至 1.0;此外,还引入了电缆与桌面之间的黏性阻力,阻力系数为每米电缆 90 N·s/m,而标称配置中该阻力为零
我们没有告诉智能体具体的实验装置是什么。操作手册将其称为一种“安装装置”(installation),只记录了接口信息:20 个跟踪点、一个操作工具、三个立柱、载荷读数,以及任务成功条件。手册没有提供图片,只在一条现场备注中写道,操作过快时装置会产生“抵抗”。
在第一次真实试验之前,两个智能体都提交了一份书面假设,并且都根据数据正确推断出了任务类型:这是一根长度约为 0.99 m、由工具夹持的不可伸长电缆。它们还识别出这是一个电缆布线任务,载荷会随着运动速度和缠绕程度增加。
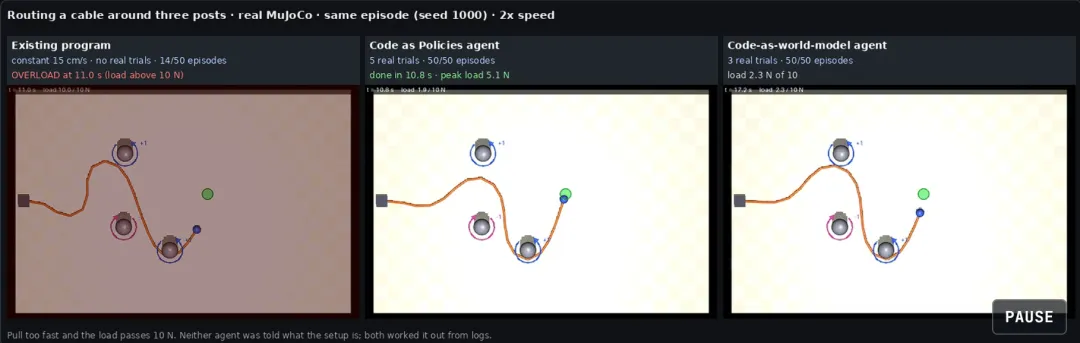
图 8. 同一个真实 Episode(随机种子 1000)中的三种控制器,播放速度为 2 倍。现有的恒定速度程序在 11.0 秒时发生过载。Code-as-Policy 程序在 10.8 秒内完成任务,峰值载荷为 5.1 N。World Model 智能体的控制器在 20.2 秒内完成任务,峰值载荷为 4.4 N。
使用五次真实试验的 CaP 智能体,在 Held-out 和重新测试的随机种子上均达到 50/50 的成功率。它从第一个程序版本开始,就利用实时载荷读数调整速度:载荷低于 4 N 时全速运动,达到 7 N 时停止,超过 8.5 N 时向后退让。最终平均峰值载荷为 5.0 N,低于 10 N 的限制。
使用三次真实试验的 World Model 智能体,同样在 Held-out 测试中达到 50/50,在另一组未见过的随机种子上达到 49/50,其世界模型大小为 13,870 字节。
作为对照,我们还构建了一个没有任何电缆运动记录的 CaP 智能体,将原先记录的 10 个 Episode 日志全部删除。它仍然取得了 47/50,即 94% 的成功率,并且同样利用第一个程序版本中的实时读数进行控制。其三次失败均由几何计算错误导致超时。
这项任务最终被证明相对简单,因为实时载荷读数使所有三个智能体都能够构建反应式速度规则:电缆受到拉力时减速,拉力过大时停止。隐藏的物理特性不再是决定任务成败的关键因素。即使没有电缆运动记录的对照 CaP 智能体,也仅凭实时读数达到了 94% 的成功率。
世界模型测试在这里发挥的作用主要是发现程序错误。电缆世界模型对 23 个程序进行评分,平均误差为 5.2 个百分点,相关系数为 0.980;其中三个程序的预测结果与真实结果完全一致,均为 150/150。五次成功的真实试验并未暴露出 6–12% 的失败率,但模拟测试发现了这些问题。
电缆布线:完整实验结果与分析
三种电缆任务解决方案:反馈控制、开环程序与世界模型验证。
Code as Policies(5 次真实试验,50/50)。 CaP 智能体在进行任何自身的真实试验之前,就编写了第一个程序。当时它已经获得了一个现有程序运行 10 个 Episode 的日志。该程序沿着立柱规划一条紧凑路径,并根据实时载荷读数调整工具速度:载荷低于 4 N 时全速运动,达到 7 N 时停止,超过 8.5 N 时后退。五次真实试验全部成功。第二个版本进一步收紧了运动路径。第三个版本增加了两条安全规则,但这两条规则从未被触发。Held-out 评估结果为 50/50。在未见过的随机种子 5000–5049 上重新测试,结果同样为 50/50。三个程序版本在随机种子 6000–6049 上也全部达到 50/50。平均峰值载荷为 5.0 N,低于 10 N 的限制。Episode 平均执行 171 步(8.5 秒)。
Code-as-World-Model(3 次真实试验,Held-out 50/50,未见种子 49/50)。 World Model 智能体使用了五次真实试验中的三次。其世界模型大小为 13,870 字节,采用由 20 个节点构成的弹簧-阻尼链模型,包含弯曲刚度、黏性阻力和库仑阻力、立柱碰撞,以及工具伺服模型。Held-out 评估结果为 50/50。在两组未见过的随机种子(5000–5049 和 6000–6049)上重新测试,均达到 49/50。World Model 智能体的控制器速度较慢,平均执行 350 步(17.5 秒)。
对照实验:不提供免费日志的 Code as Policies(5 次真实试验,成功率 94%)。 我们使用一个全新的 CaP 智能体,只向它提供操作手册和 200 张静态场景快照。此前记录的 10 个 Episode 日志,以及早期智能体的程序和日志,均从项目中移除。该智能体在第一次真实试验前提出的假设,同样正确识别出这是一根长度约为 1 m 的电缆。五次真实试验全部成功,包括第一次试验(163 步,峰值载荷 5.12 N)。无论真实试验还是评估 Episode,都没有发生过载。该智能体从第一个程序版本开始,也利用实时载荷读数调整运动速度。对其最终提交的程序(v2)进行 Held-out 评估,结果为 47/50,即 94%。三次失败均由路径采样中的一个 Bug 导致:在某些布局下,程序会冻结指令目标点,最终超时。在未见过的随机种子上,成功率分别为 49/50(5000–5049)和 50/50(6000–6049)。
反应式反馈策略:实时力读数使世界模型不再是成功的必要条件
实时载荷读数。 定义任务失败的关键指标——载荷,被实时提供给控制器,而且任务没有强制要求控制器快速完成。基于载荷读数的反应式规则,使隐藏的物理特性不再影响任务成败。电缆产生拉力时,控制器减速;拉力较大时,控制器停止;拉力进一步增大时,控制器向后退让。没有获得任何电缆运动记录的对照 CaP 智能体,仅凭实时载荷读数就达到了 94% 的成功率。
电缆实际上只会对一个左右的立柱产生明显作用。任务的成功条件仅要求电缆从每个立柱的指定一侧通过,并且每种布局都会留下 14–29 cm 的松弛量。因此,成功 Episode 结束时,电缆平均只与三个立柱中的 1.16 个保持接触。对于 Code-as-Policy 程序,这一数值为 1.16;World Model 智能体为 1.02;环境团队提供的知情控制器为 1.03;恒定速度程序为 1.14。
在同一时刻,最多只有约 1.3 个立柱承受载荷。因此,隐藏的立柱摩擦力,以及多个立柱之间摩擦力的累积效应,很少真正发挥作用。真正产生影响的隐藏因素,是随运动速度增加而增大的阻力。
速度和路径决定了大部分表现。 Code-as-Policy 程序的速度上限为 10 cm/s,平均速度为 8.4 cm/s;相比之下,恒定速度程序的速度为 15 cm/s。它的路径也更加紧凑,平均长度为 0.72 m,而恒定速度程序为 1.06 m,因此需要拖动的电缆更少。当载荷处于 4–7 N 时,程序会降低速度,这一状态占整个 Episode 时间的 37%。其载荷从未超过 7 N,平均峰值为 5.0 N,最高为 5.7 N。恒定速度程序的平均峰值载荷则为 10.5 N。
环境团队提供的开环程序采用恒定 10 cm/s 的速度,并与立柱保持 6.5 cm 的间距,在未见过的 Episode 上已经能够达到 84% 的成功率。剩余的成功率提升来自载荷反馈机制。
初始条件:两个智能体都获得了免费日志,环境参考控制器成功率为 78%
环境团队提供的“知情”控制器(78%)是一个偏保守的参考方案。更快的策略本可以取得更高的成功率。它的主要问题是速度太慢:工具平均速度为 4.5 cm/s,平均执行 417 步。50 个 Episode 中,有 10 个未能在 30 秒时间限制内完成,其中 3 个 Episode 结束时,电缆仍未从立柱的正确一侧通过。还有一次过载是由工具被卡住后突然脱离所产生的 38 N 峰值载荷引起的。
两个智能体在开始时都获得了一个现有程序运行 10 个 Episode 的完整逐步日志,其中包含载荷变化曲线,且有 8 个 Episode 以失败告终。这相当于直接提供了两倍于试验预算的现成示例。在其他所有任务中,智能体最初都没有任何系统运动记录。
前面的对照实验表明,即使移除这些免费日志,智能体仍然能够在五次真实试验后达到 94% 的成功率,而且没有发生过载。这说明,让任务变得简单的并不是免费日志,而是实时载荷读数。
电缆世界模型的短时域预测精度
在未参与模型拟合的日志上,模型对标记点位置的预测误差,在向前预测 5、20 和 60 步后分别为 2.8 mm、8.7 mm 和 20.5 mm。作为基线,假设“电缆保持静止”的模型,其误差分别为 7.5 mm、27 mm 和 64 mm。
载荷预测误差分别为 0.26 N、0.31 N 和 0.37 N。
智能体也指出了自身模型的薄弱环节。在回放最初 10 个观察 Episode 的控制指令时,模型只能复现其中 3 个 Episode 的结果。大多数 Episode 的最终载荷都接近 10 N 的限制值,误差不到 0.5 N;但当工具被立柱卡住、随后突然挣脱时,模型会低估产生的载荷峰值。在其中一个 Episode 中,模型预测为 7.3 N,而真实载荷达到了 21 N。
覆盖能力:测试发现了真实试验未能发现的失败案例
由于两个智能体生成的程序成功率都接近或达到 100%,我们额外引入了一系列表现较弱的程序,用于测试评估器的能力。
这些程序由环境团队编写,采用开环控制方式:路径保持紧凑,使用单一恒定速度,不包含载荷反馈。我们设置了 8 种工具速度,并分别测试工具与立柱之间的两种间距。
每个程序都在 50 个未见过的真实 Episode 上运行(随机种子 6000–6049),同时使用相同 Episode 重置时的观测数据,在世界模型中独立评分。世界模型可以直接读取重置状态,无需消耗真实执行步数,而且 World Model 智能体从未见过这些 Episode 的实际结果。
评估结果如下:
平均绝对误差为 6.0 个百分点。
20 个程序中,10 个的预测误差在 5 个百分点以内。
16 个的预测误差在 10 个百分点以内。
最大误差为 22 个百分点,出现在工具与立柱间距为 6.5 cm、速度为 12 cm/s 的设置中:真实成功率为 60%,模型预测为 38%。
Pearson 相关系数为 。
在 1,000 个独立 Episode 中,模型预测与真实结果有 916 个一致,准确率为 91.6%。
世界模型能够复现两种失败模式。在工具与立柱间距为 9 cm 时,真实成功率与模型预测结果如下:
| 工具速度(cm/s) | 真实成功率 | 模型预测 |
|---|---|---|
| 4 | 16% | 18% |
| 6 | 80% | 90% |
| 8 | 82% | 88% |
| 10 | 80% | 68% |
| 12 | 58% | 44% |
| 15 | 22% | 18% |
| 20 | 4% | 10% |
| 25 | 0% | 6% |
速度过慢会导致任务超时,速度过快则会造成载荷过载。
我们选择了 16 个开环程序进行评估。这些程序均由环境团队编写,没有任何智能体参与生成。世界模型此前仅使用同一程序在一种配置下的日志进行拟合,即工具与立柱间距为 9 cm、速度为 15 cm/s,但使用的是其他 Episode 的记录。
这项结果独立于第 3 节中对 34 个程序进行的筛选实验。
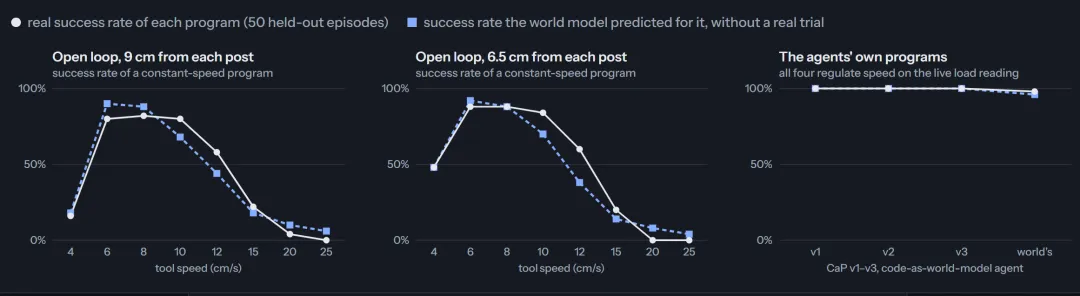
图 9. 三个面板。左侧和中间面板展示开环程序在工具与立柱间距分别为 9 cm 和 6.5 cm 时,成功率随工具速度变化的情况。实线和圆点表示真实成功率,虚线和方块表示世界模型预测的成功率。右侧面板展示四个智能体自行编写的程序。
对照 CaP 智能体生成的三个程序。 对照 CaP 智能体的五次真实试验全部成功,但这并不意味着它生成的三个程序性能相同。要选出最佳版本,仅有五次成功试验还不够。
在 Held-out 评估随机种子上,v1 只实际执行过一次且成功,最终得分为 44/50。v2 实际执行过四次,四次全部成功,并被提交评估,最终得分为 47/50。v3 是智能体在看到评估失败案例后编写的修复版本,从未在真实环境中运行,也没有提交评估,但其得分达到了 50/50。
我们将这三个程序交给另一个智能体编写的电缆世界模型进行评估。该世界模型此前从未见过这些程序。每个模拟 Episode 都从对应真实评估 Episode 的重置状态开始,不消耗任何真实执行步数。
世界模型预测的结果分别为 44/50、47/50 和 50/50。
它甚至准确指出了真实环境中发生失败的具体 Episode:
v2:随机种子 1029、1033、1046。
v1:除上述三个种子外,还有 1038、1039 和 1043。
这意味着模型对 150 个 Episode 的预测全部正确,准确率为 150/150。
在未见过的随机种子 6000–6049 上,世界模型同样准确复现了三个程序的结果:真实成功率和预测成功率分别为 49/50、50/50 和 50/50,失败的 Episode 也完全一致。
这些失败来自程序本身的几何 Bug,即工具无法按照规划路径运动,并非复杂的物理现象。智能体还指出,仅通过对 200 张静态场景快照进行验证,也能够发现 v2 中的 Bug。
这与 Push-T 任务中的情况相同,只不过规模更小。五次成功的真实试验无法揭示 6–12% 的失败率,而在大量模拟 Episode 中运行程序却能够发现这些问题。
截至目前,电缆世界模型已经在随机种子 6000–6049 上评估了 23 个程序,平均绝对误差为 5.2 个百分点,最大误差为 22 个百分点,相关系数为 。
测试无法带来额外收益的情况:闭环反馈使控制器具备自我纠正能力
有了实时载荷读数,载荷本身就不再是导致任务失败的因素。基于载荷的反应式速度规则,使隐藏的物理特性不再影响任务成败。即使是没有任何电缆运动记录的对照 CaP 智能体,也仅凭实时读数达到了 94% 的成功率。
世界模型无法进一步改善控制器的表现。剩下的问题只是普通的程序 Bug:几何路径计算错误在五次成功的真实试验中从未触发,却会在某些特定布局下导致失败。
尽管如此,世界模型仍然能够准确预测三个程序在全部 150 个 Episode 中的表现,并明确识别出发生失败的随机种子。
本文中世界模型的价值,与第 2 节提出的适用条件密切相关:不同 Episode 存在差异,而要区分不同程序版本的优劣,需要的试验次数超过了现有预算。
当实时读数能够让程序在每个 Episode 中自行纠正时,这一条件对于物理动力学而言基本不再成立,但对于几何问题依然存在。
电缆任务还展示了另一项能力:两个智能体都仅凭日志,就识别出了一个此前未描述的可变形物体。基于观察日志和三次真实试验,智能体编写出了一个 14 KB 的世界模型。该模型对 23 个程序进行评估,平均误差仅为 5.2 个百分点。
6. 模型预测控制:当控制器根据观测重新规划时,零点几秒的预测就已足够
在一个具有混沌特征、接触丰富的可变形物体操作任务中,即使模型只能保证短时间范围内的预测精度,结合基于采样的 MPC 和模型参数上的 Domain Randomization,也足以解决仅通过真实试验修改固定程序无法完成的任务。
电缆任务具有准静态、运动缓慢、可纠正等特点,并且所有传感器读数都能实时获得。我们设计绳子任务时则刻意采用了相反的条件。
任务要求智能体将一根放在桌面上的绳子抛过一个立柱,使绳子的自由端进入目标圆盘,而操作工具无法直接触及该目标区域。系统没有力传感器读数,也不存在通过缓慢运动到达目标的路径。我们向两个智能体隐藏了绳子的物理参数,也没有告诉它们具体的实验装置是什么。
操作手册中的现场备注原文如下:
“负责运行这套装置的人表示,你只有一次尝试机会,而且缓慢操作毫无用处。没有人记录过其中的原因。他们还表示,操作方式上的微小变化,就可能改变最终落点。”
绳子任务细节
绳子长度为 0.70 m,直径为 1 cm。一端由操作工具夹持,工具只能在 0.25 × 0.40 m 的区域内移动。一个半径为 3 cm 的立柱位于该区域中心外 0.40–0.56 m 处,目标区域是一个半径为 0.10 m 的圆盘,其中心位于立柱后方 0.12 m 处。
任务要求:在 236 步(50 Hz 下为 4.72 秒)的时间限制内,使整根绳子和操作工具最终静止(所有跟踪点的速度均不超过 0.02 m/s),同时确保绳子的自由端落在目标圆盘内。
观测信息: 包括 20 个跟踪点的位置、工具的位置和速度、立柱位置以及目标位置。
工具运动限制: 最大速度为 4 m/s,最大加速度为 60 m/s²。
隐藏物理参数: 弯曲刚度为 N·m²;桌面摩擦系数为 0.10;立柱摩擦系数为 0.25;绳子质量为 56 g,自由端额外附加一个 30 g 配重;此外,还存在黏性阻力。
与电缆任务不同,两个智能体在第一次真实试验之前,都没有获得任何关于系统运动过程的记录。它们只能使用操作手册、200 张静态快照和五次真实试验。
不过,现有数据仍然透露了两项信息:跟踪点的高度为 0.005 m,这揭示了绳子的半径;静态快照是在释放后 0.8 秒拍摄的,因此图像中的绳子实际上仍处于运动状态,并未静止。
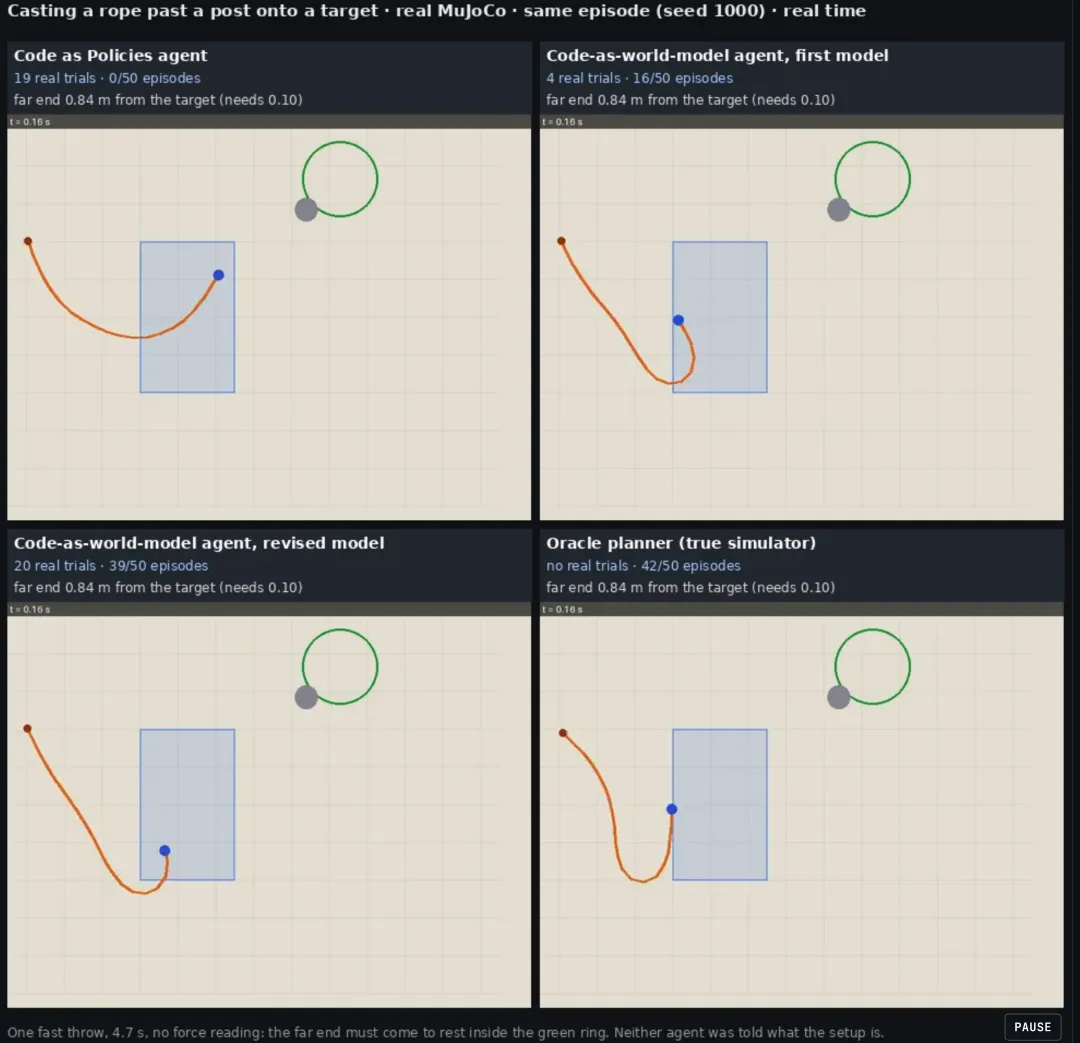
图 10. 在同一个真实 Episode(评估随机种子 1000)中比较四个程序。每个面板展示了对应程序最常见结果所对应的最低评估随机种子。左上:Code as Policies 智能体使用 19 次真实试验,成功率为 0/50,绳子最终静止在距离目标 1.12 m 的位置。右上:Code-as-World-Model 智能体使用第一个世界模型和四次真实试验,成功率为 16/50;时间限制结束时,绳子仍在运动,距离目标 0.11 m。左下:Code-as-World-Model 智能体使用修订后的世界模型和 20 次真实试验,成功率为 39/50,绳子在 2.22 秒后静止在目标区域内。右下:Oracle Planner 使用真实模拟器,无需真实试验,成功率为 42/50,绳子在 1.94 秒后静止在目标区域内。
两种方法在这个任务上的差异具有本质性。在 19 个程序版本中,仅通过真实试验修改程序的方法,从未产生过一个能够在超过 1/50 的 Episode 中将绳子准确抛入目标并使其最终静止的控制器。Code as Policies 在五次真实试验时成功率为 2%,在 19 次真实试验时下降到了 0%。
智能体确实学到了一些正确的物理规律,包括运动反向变化、速度阈值和后续跟进动作,但在某一种布局上取得的改进无法迁移到其他布局。
相比之下,在执行每次抛掷之前,先使用世界模型测试候选动作,最终得到了一个能够正常工作的控制器。Code-as-World-Model 智能体在四次真实试验后,使用第一个世界模型(14,313 字节)达到了 32% 的成功率;经过 20 次真实试验后,使用修订后的世界模型(16,069 字节)达到了 39/50,即 78% 的成功率。
修订后的模型增加了与速度相关的摩擦,以及不可伸长连接带来的能量损失。这一结果距离 Oracle Planner 的 84% 仅差三个 Episode,并且在重新测试的随机种子上再次达到 78%。
我们发现,即使经过修订,世界模型也无法在较长时间范围内保持几个百分点以内的预测误差。对于绳子远端的位置,模型在向前预测 5、20 和 60 步时的误差分别为 1.2 cm、5.8 cm 和 17.4 cm。
真正发挥作用的是一个只能预测零点几秒的模型:控制器每隔 0.16 秒就根据实时读数重新规划一次,并在六个经过扰动的模型副本中进行测试。
对于一个困难的物理系统,我们并不需要建立一个完美的世界模型。只需要一个短时域预测模型,并随着系统运动不断重新运行预测和规划,就足以解决任务。
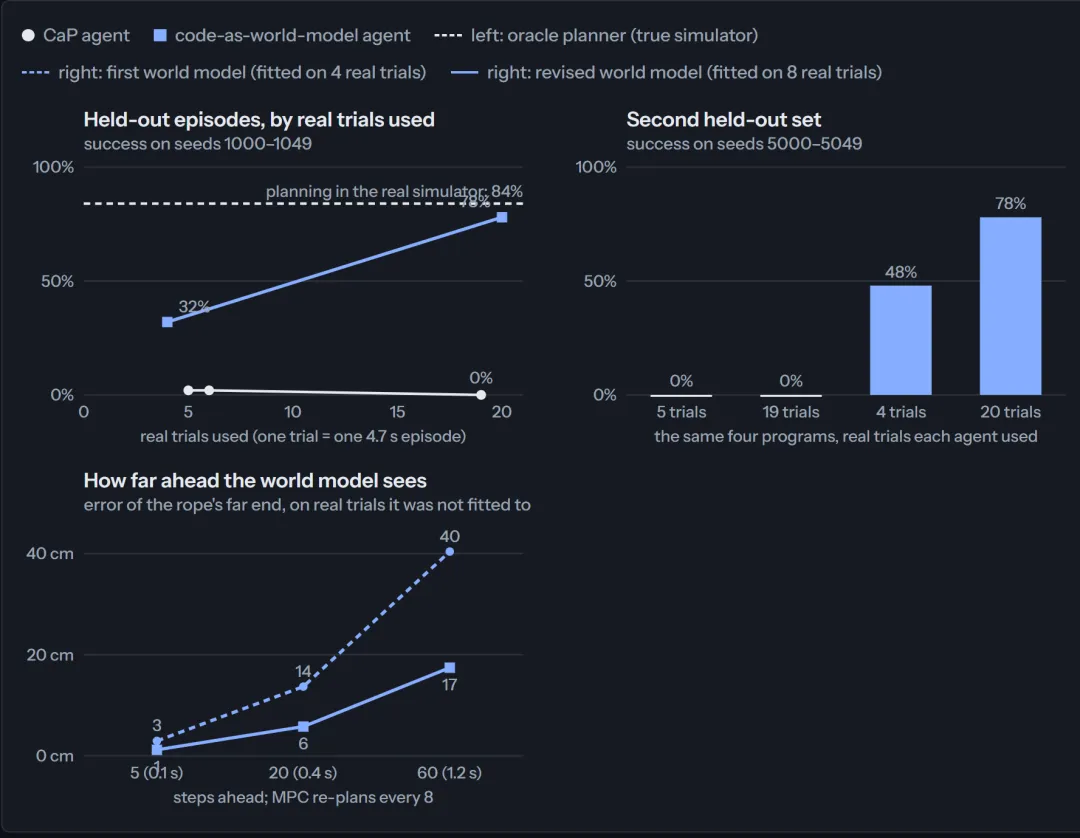
图 11. 左图:在 50 个评估 Episode 上的成功率与真实试验次数之间的关系。Code-as-Policy 在五次真实试验时成功率为 2%,六次时仍为 2%,19 次时降至 0%。Code-as-World-Model 智能体在四次真实试验后达到 32%,20 次后达到 78%。虚线表示 Oracle Planner 的 84% 成功率。
中图:在第二组未见过的 50 个 Episode(随机种子 5000–5049)上测试相同的四个提交程序,成功率分别为 0%、0%、48% 和 78%。
右图:世界模型在未参与拟合的真实试验中,对绳子远端位置的预测误差。向前预测 5、20 和 60 步时,第一个世界模型的误差分别为 3.0 cm、13.7 cm 和 40.4 cm;修订后的世界模型分别为 1.2 cm、5.8 cm 和 17.4 cm。控制器每 8 步重新规划一次。
7. 模型规模与可解释性:数百行带有明确物理参数的 Python 代码
每个世界模型都是一个 14–26 KB 的 Python 文件,其中包含具名物理参数,既可以被智能体读取和修改,也可以由人类直接检查。我们为五个系统分别编写了五套测试环境。
最大的无人机世界模型是一个 25,975 字节的 Python 文件,约为本文页面中 Mission C 视频文件(807 KB)的三十分之一。它包含四旋翼的运动方程、恒定机体角速度偏差,以及推力损失(用于描述旋翼性能下降如何通过内环控制系统体现出来)。此外,还包含一个风场模型,其中每个风区都采用沿峡谷方向的 Gaussian Profile,并考虑了风区在通道深度和高度方向上的变化;同时还包括检查点序列描述,以及 Mission C 中引入的四种随机其他飞行器行为类型、生成位置范围和运动参数。
推动任务的世界模型大小为 14,344 字节,同时覆盖 T 形和 L 形方块。它包含一个刚体冲量模型,并拟合了质心、地面摩擦、恢复系数、L 形方块的接触摩擦,以及推动器模型。
Doom 世界模型大小为 16,599 字节,包含玩家运动学、火球生成、Imp 敌人生成,以及伤害模型。
电缆世界模型大小为 13,870 字节,包含一个由 20 个节点构成的弹簧-阻尼链模型,以及弯曲刚度、桌面上的黏性阻力和库仑阻力、立柱碰撞和工具伺服模型。
绳子世界模型经历了两个版本:第一个版本为 14,313 字节,修订版本为 16,069 字节。两个版本都采用由 20 个质点构成的平面链模型,包含拉伸弹簧、弯曲刚度和阻尼、桌面摩擦与阻力、立柱接触,以及工具伺服系统。修订版本额外加入了速度相关摩擦和不可伸长连接带来的能量损失。
我们总共编写了五个世界模型,每个大小为 14–26 KB。其中,无人机世界模型使用了 Mission A 和 Mission C 中共十次真实试验的数据;其他世界模型则分别使用了每项任务两至二十次真实试验的数据。
作为对比,在真实环境中训练 PPO,需要 1,137–3,065 次真实试验才能使无人机 Mission A 的成功率超过 50%。使用 14,811 次真实试验后,PPO 的任务完成时间达到 3.0 秒。
我们的 LLM 智能体只需要四至五次真实试验,便能在不到 10 秒内完成无人机任务。使用五次真实试验训练的学习型神经动力学模型,在 Mission A 上的成功率仍然是 0/50。
在 Doom 中,使用五次真实试验的 PPO 平均只能存活 206 个游戏 Tick;即使使用 4,672 次真实试验,其存活时间也只有 1,716 Tick,仍然低于仅使用五次真实试验的 CaP 智能体所达到的 2,385 Tick。
各任务的完整控制器对比
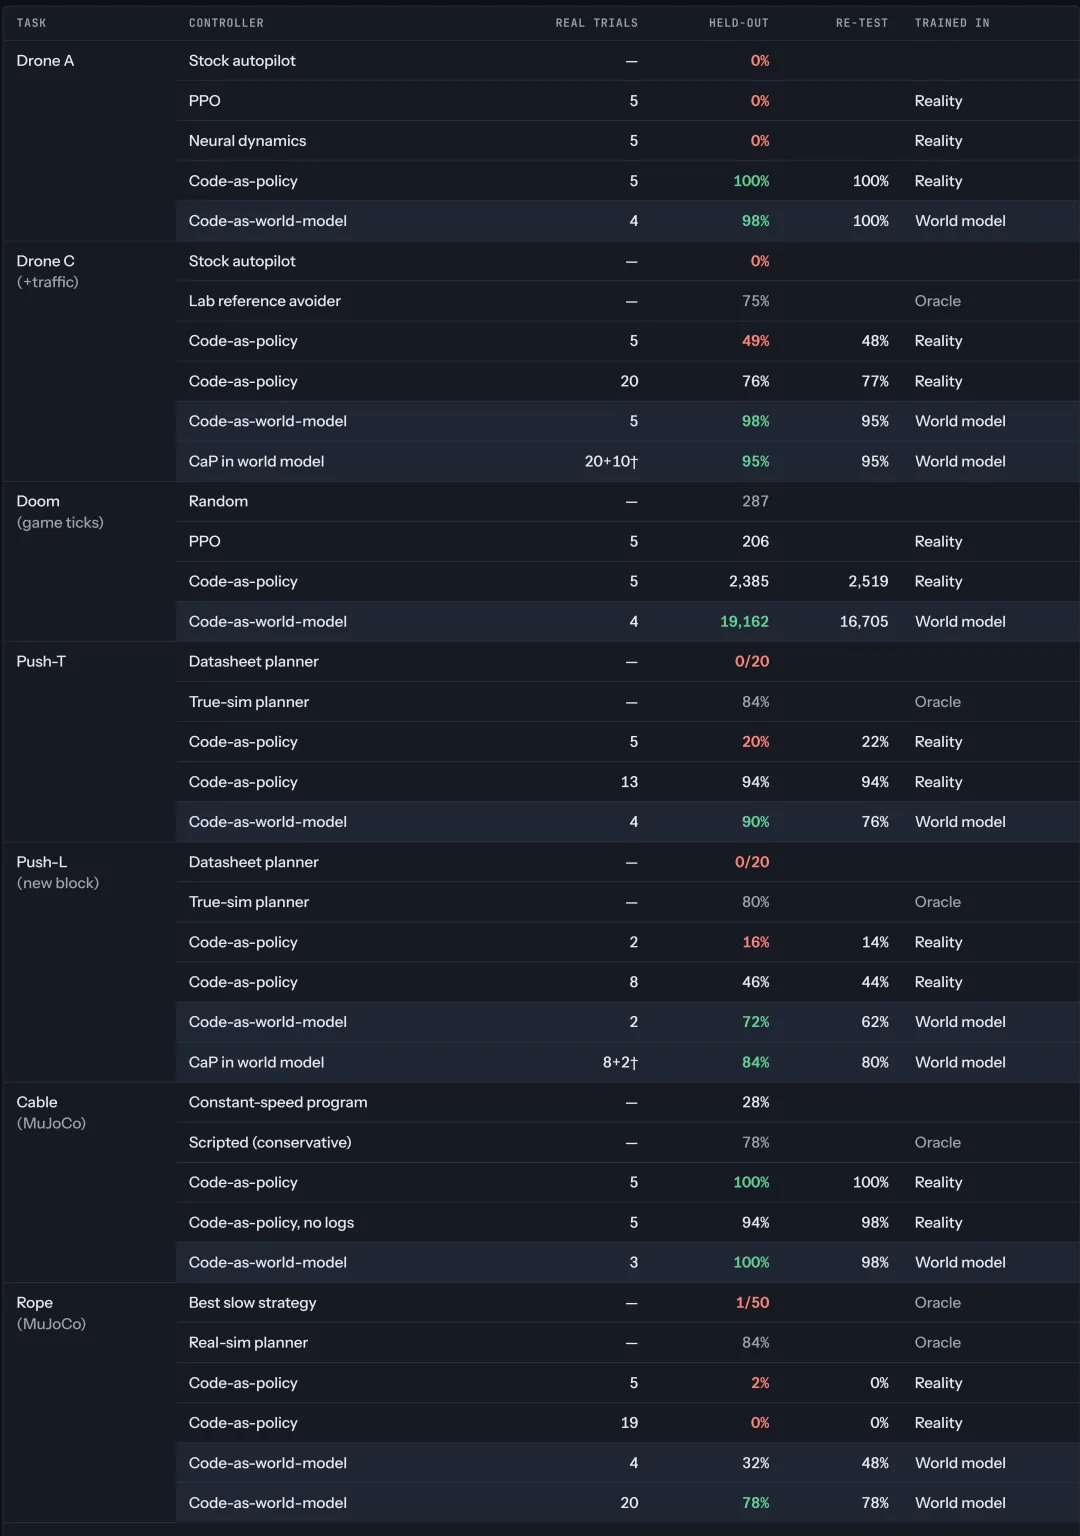
† CaP 智能体自身的真实试验次数,加上构建世界模型所消耗的真实试验次数。CaP 智能体在世界模型中运行时,不需要额外的真实 Episode。对于 Push-L,世界模型继承自 Push-T(使用四次真实试验构建),并额外使用两次 Push-L 真实试验进行重新拟合。
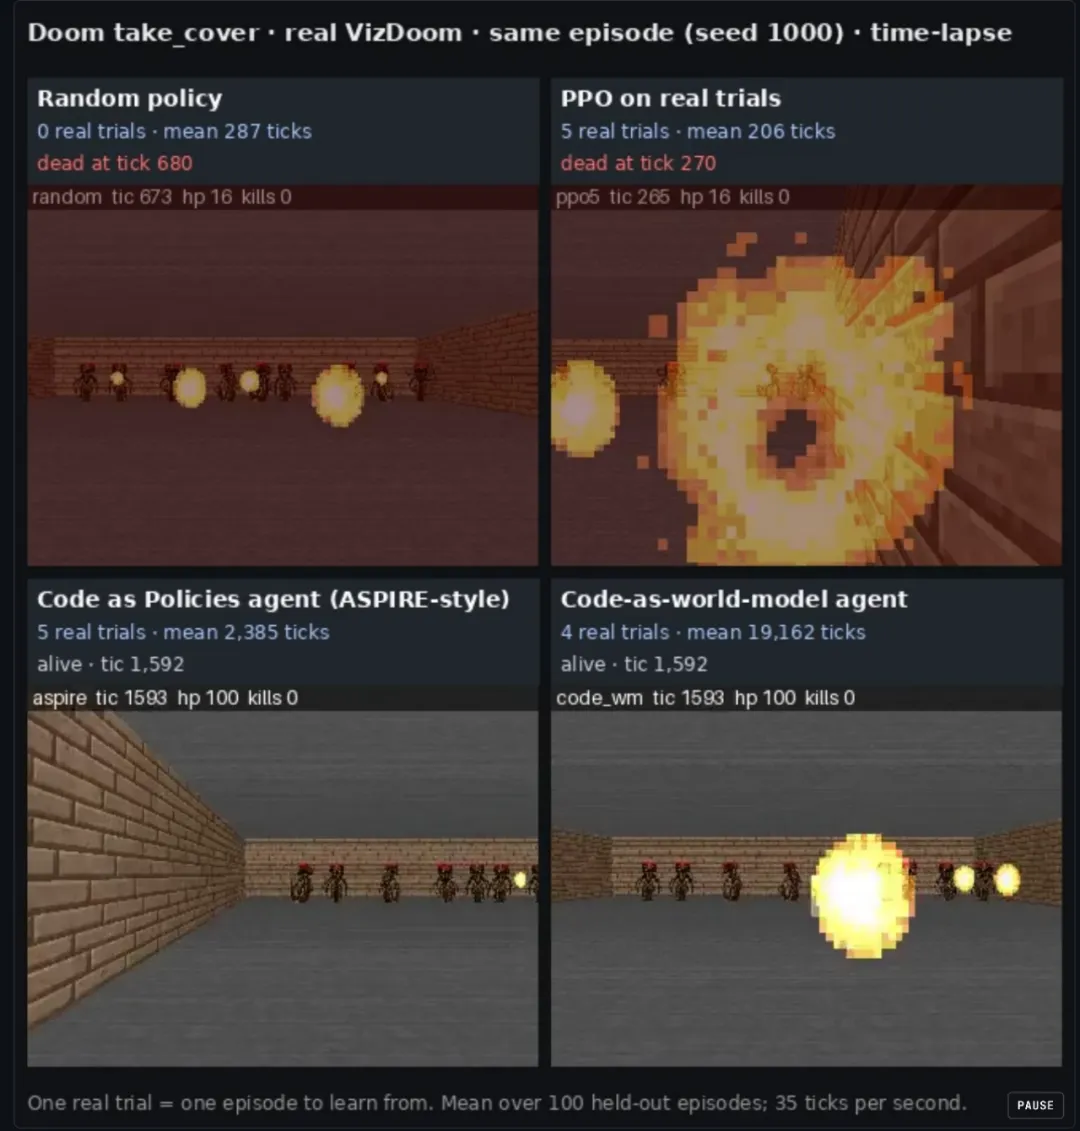
图 12. 在同一个 VizDoom Episode 中以时间序列方式比较四种控制器。随机策略在游戏 Tick 680 时死亡,PPO(五次真实试验)在 270 时死亡,Code-as-Policy 存活了 2,533 Tick。Code-as-World-Model 智能体的控制器在游戏 Tick 3,000 时仍然存活(该 Episode 实际运行了 24,421 个游戏 Tick)。
学习型视频世界模型如何?
《World Models》(Ha & Schmidhuber,2018)在相同的 Doom 任务上报告了 1,092 ± 556 的平均存活时间。该研究使用像素观测,通过 10,000 次随机 Rollout 训练神经世界模型。
相比之下,本文的 World Model 智能体仅通过 4 次真实试验,利用结构化观测构建世界模型,其控制器的平均存活时间达到了 19,162 个游戏 Tick。
需要注意,两项实验的设置存在差异:前者使用像素输入,后者使用结构化输入;前者使用 10,000 次随机 Rollout 训练,后者仅使用 4 个真实 Episode;前者采用神经网络作为世界模型,后者则采用文本形式的代码文件。
8. 提出与验证:CaP 编写程序,测试负责筛选
Code as Policies 负责提出候选控制器,世界模型测试负责验证这些控制器。
我们发现,当以下三个特征同时存在时,测试机制最有价值:
Episode 存在随机变化,因此少量真实试验无法区分不同程序版本的优劣。
物理系统存在手册未说明的隐藏变化,因此智能体必须通过观察才能发现这些变化。
系统动力学复杂,或者对细微变化非常敏感,因此每个动作都值得在执行前进行测试。
当环境变化较小,或者控制器能够实时感知失败信号并自行纠正时,测试机制的价值就会降低。
下表根据这些特征对任务进行了整理。
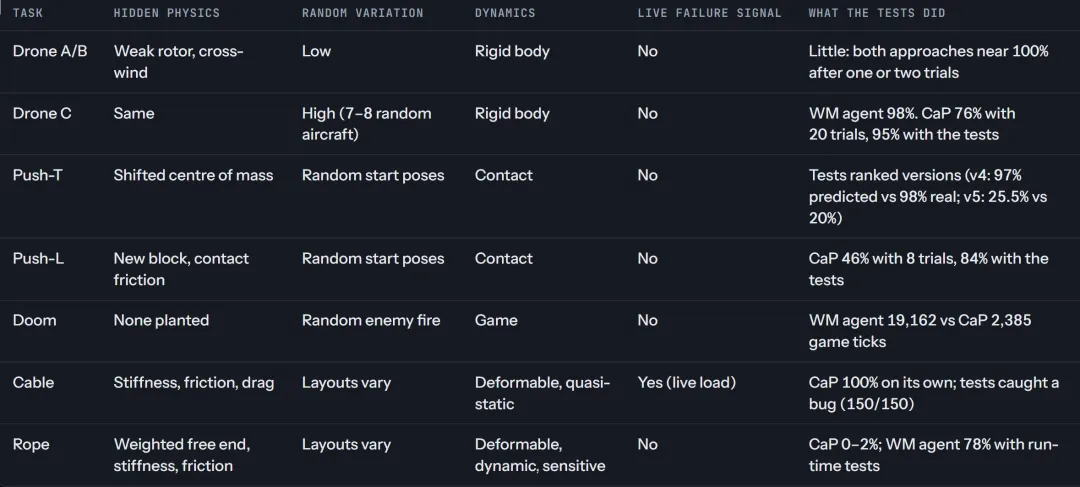
图 13. 在同一个真实 Push-L Episode 中比较四种控制器。随机策略和使用两次真实试验的 Code-as-Policy 程序均未能完成任务,后者的最佳覆盖率为 0.43。使用八次真实试验的 Code-as-Policy 程序在第 295 步(总计 300 步)完成任务。Code-as-World-Model 智能体的控制器则在第 152 步完成任务。
世界模型的核心贡献在于验证:每次真实试验背后运行数百万个模拟步骤,将少量真实 Episode 转化为具有统计意义的测试。
将 CaP 智能体与世界模型测试结合起来,效果最为明显。
在 Drone C 中,使用 20 次真实试验的 CaP 智能体成功率为 76%,加入测试后提高到了 95%。
在 Push-L 中,使用八次真实试验的 CaP 智能体成功率为 46%,加入测试后,Held-out 成功率达到 84%,重新测试达到 80%。这一结果高于两个智能体各自单独运行时的表现(CaP 为 46%,World Model 智能体为 72%),并且与 Oracle Planner 的 80% 持平。
在电缆任务中,实时读数使控制器能够自行纠正,因此测试并未提高成功率,但仍然发现了一个 Bug,覆盖了 150/150 个 Episode。
在绳子任务中,世界模型测试验证的不是整个程序,而是具体动作。它最终生成了一个能够工作的控制器,而仅通过真实试验修改程序的方法始终无法做到这一点。
绳子任务的鲁棒性来自在六个经过扰动的世界模型副本中进行测试,模型参数随机变化范围为 ±35%,从而覆盖了智能体尚未测量到的物理变化。
推动任务中还存在一个容易被误解的性能上限。即使直接使用真实模拟器本身(实际环境,不需要任何世界模型),采样式规划器在 Push-T 和 Push-L 上的成功率也只有 84% 和 80%。
我们的 Push-T 结果(合并三个评估集合后为 83%)已经接近 Oracle Planner。Push-L 的合并成功率为 66%,而 Oracle Planner 为 80%。
这些任务的瓶颈在于采样式规划器能否充分利用所获得的世界模型。Code as Policies 负责编写程序,世界模型测试负责验证程序。
9. 局限性(Limitations)
近似验证器。 与单元测试或形式化证明检查器不同,我们的世界模型可能存在错误。虽然它在整体上能够较好地对程序排序(34 个程序,平均绝对误差 5.2,相关系数 0.974),但在推动任务、Doom 和绳子任务中,它对绝对成功率的预测过于乐观。在 Push-L 中,其排序能力是所有任务中最差的,平均绝对误差为 10.1 个百分点,最大误差达到 22 个百分点。在绳子任务中,由于几乎所有程序的成功率都只有 0–2%,测试作为程序评估器的作用尚未得到充分验证。在电缆任务中,实时读数已经使控制器能够自行纠正,验证器并没有提高控制器的成功率。
小规模任务。 本文仅涉及八项任务,全部采用结构化状态观测,并且任务规模足够小,可以由单个 LLM 智能体在一次会话中完成。目前尚不清楚,当任务变得更加复杂、观测内容更加丰富时,这些世界模型以及将世界模型作为测试环境的 CaP 方法能否继续扩展。
每个智能体、每项任务仅运行一次。 PPO 的学习曲线来自单个随机种子,尚未研究不同运行之间的方差。
使用模拟器,而非真实物理系统。 所有任务都运行在 VizDoom、PyBullet/PyFlyt、pymunk 或 MuJoCo 中。本文没有测试 Sim-to-Real 迁移。
- VizDoom 并非机器人任务。 我们将其纳入实验,是因为它是最早开展的任务。研究灵感 Saltline 本身是一款第一人称射击游戏,而 take_cover 正是 2018 年《World Models》论文使用的场景。
- 推动任务中的模型族巧合(Model-family coincidence)。 Push-T 的世界模型与真实环境都采用刚体冲量物理模型。在真实机器人上,需要针对每个具体系统单独验证这种模型匹配关系。
- Push-L 的筛选误差。 世界模型在 Push-L 上的预测平均绝对误差(MAE)为 10.1 个百分点,最坏情况下达到 22 个百分点,明显高于其他任务的 0.6–5.1 个百分点。在 Push-L 的七个程序版本中,世界模型低估了其中五个版本的成功率,准确预测了一个版本,并高估了一个版本。
- CaP-in-World-Model 的试验成本。 将世界模型作为测试环境的 CaP,除了 CaP 智能体自身消耗的真实试验,以及构建世界模型所消耗的真实试验外,不需要额外的真实 Episode。在 Drone C 中,CaP 使用 20 次真实试验,世界模型构建则在 Mission A 和 Mission C 中累计使用 10 次。在 Push-L 中,CaP 使用 8 次,世界模型额外使用 2 次;其中世界模型继承自 Push-T,最初通过 4 次真实试验构建,再利用 Push-L 的 2 次真实试验重新拟合。
- 筛选实验的例外情况。 在对 Code-as-Policy 程序进行评分之前,负责推动任务的 World Model 智能体曾在一个 Push-T v5 程序的文档字符串中看到一行信息,其中写明了该版本的 Held-out 评估结果(10/50)。除此之外,针对 34 个程序的筛选过程均在盲测条件下进行。
- Mission C 中的任务继承。 两个智能体在尝试 Mission C 之前,都已经完成了 Mission A 和 Mission B。在 Mission C 的观察试验中,两个智能体获得的日志都包含其他所有飞行器的真实运动轨迹。
- 事后修改程序。 CaP 智能体用于 Mission C Held-out 评估的程序版本(v11),是在五次真实试验的预算耗尽后修改的,并且在评估之前从未进行过真实飞行。
- Doom 任务中的规则放宽。 实验进行到一半时,我们放宽了 World Model 智能体的规则,允许其编写在世界模型中调优的手工控制器,而不再仅限于使用 RL 训练的控制器。
- 回顾性评估(Retrospective Evaluations)。 图 4 中的学习曲线是我们在实验结束后进行的回顾性评估。智能体在真实试验过程中并未看到这些评估得分。
- Cable:隐藏任务身份。 电缆任务通过规则描述隐藏了任务的具体身份,仪器手册没有提及任何物体名称。实验结束后,我们审查了三个电缆任务智能体的全部命令日志,确认没有任何智能体访问被禁止的文件。
- Cable:共享环境。 电缆模拟器程序包安装在两个智能体均可访问的共享环境中。
- Cable:免费日志。 与其他所有任务不同,两个电缆任务智能体在第一次真实试验之前,都获得了一个现有程序运行 10 个 Episode 的完整逐步日志,相当于提前获得了两倍于试验预算的现成示例。对照实验表明,即使不提供这些日志,成功率仍然达到 94%,因此免费日志并不是实验结果的决定性因素。
- Cable:成功判定规则与松弛量。 成功条件仅要求电缆从每个立柱的指定一侧通过。每种布局都会留下 14–29 cm 的松弛量,成功 Episode 结束时,电缆平均只与三个立柱中的约一个保持接触。因此,这项任务并未真正测试电缆在张力作用下绕过多个立柱的能力。
- Cable:程序评估。 16 个开环程序,以及对照 CaP 智能体生成的 3 个程序版本,均由我们使用世界模型进行评分,而非由 World Model 智能体自行评估。
- Rope:扩展评估重复使用随机种子。 Held-out 评估与扩展评估均使用随机种子 1000–1049。我们通过未见随机种子重新测试(5000–5049)弥补这一问题。在这组随机种子上,World Model 智能体的控制器仍然达到 78% 的成功率,与原评估结果一致。
- Rope:计算成本。 World Model 智能体的控制器每执行一个 0.02 秒的控制步,需要约 2 秒计算时间,因此无法满足实时运行要求。
- Rope:评估测试区分度不足。 几乎所有 Code-as-Policy 程序的成功率都只有 0–2%,因此世界模型与真实结果之间的一致性很容易实现。按 Episode 计算的距离相关系数仅为 0.27。在这项任务中,世界模型作为程序级评估器的能力尚未在具有实际区分度的成功率范围内得到有效验证。
- Rope:隔离此前的研究成果。 在绳子任务智能体运行期间,电缆任务的程序、日志、世界模型及所有相关文档均已从项目目录中移出并锁定,以避免绳子任务智能体访问此前的研究成果。
10. 相关工作(Related Work)
Code as Policies
Liang et al.(2022;ICRA 2023)提出了 Code as Policies 这一概念,并展示了 LLM 如何根据自然语言指令编写机器人控制代码,将代码生成作为策略表示形式。
ASPIRE(NVIDIA GEAR)进一步将其扩展为一个智能体闭环:LLM 编写技能,在模拟器中测试技能,然后根据结果进行迭代。
Eureka(Ma et al., 2023)则利用 LLM 编写奖励函数,再通过这些奖励函数使用 RL 学习控制器。
本文的 CaP 智能体是 ASPIRE 风格的重新实现,并将真实试验次数限制在五次。
Code as World Model
Code World Models(Dainese et al., 2024)根据环境描述和离线轨迹,将环境模型编写为 Python 代码,并通过 Monte Carlo Tree Search 在程序空间中搜索,再利用生成的模型进行规划。该方法覆盖了 18 个 Gym 环境。
WorldCoder(Tang, Key and Ellis, 2024)让智能体在执行任务的过程中逐步构建 Python 世界模型,通过乐观探索和模型规划完成 Gridworld 及任务规划领域中的任务。
CWM(Meta FAIR CodeGen Team, 2025)是一个 32B 参数的语言模型,基于代码执行轨迹和智能体交互数据训练,用于建模代码执行过程。
Code as Worlds(Wang et al., 2026)将物理场景编写为可执行代码,并通过验证这些代码,为视觉语言模型提供定量物理推理的监督信号。
Code World Model: Coding Agent as World Brain(Chen, Lin and Zhang, 2026)则通过代码维护世界状态及其规则,并驱动视频模型渲染相应画面。
本文的研究灵感来自 Saltline:一个单文件浏览器 FPS 游戏,大小约为 1.43 MB,由 Claude Fable 5.2 一次性生成,开发者为 Felix Rieseberg(Anthropic)。
LLM 推理中的验证器
LLM 之所以能够在代码和数学领域发挥作用,一个重要原因是其输出可以自动验证:代码可以通过单元测试检查,数学推理可以通过证明检查器验证,数学应用题则可以使用经过训练的验证器进行评估(Cobbe et al., 2021;Lightman et al., 2023)。
机器人控制代码目前还没有类似的验证机制。机器人操作策略的真实世界评估难以规模化,也难以复现(Li et al., 2024;Kress-Gazit et al., 2024)。
少量真实试验无法构成可靠的验证器,而部署时又不存在可以直接使用的真实模拟器。Code World Model 提供了一种近似验证器,由智能体根据自己的试验记录自行编写。
Agent Harness 与 Test-time Verification
Weng(2026)将 Harness 描述为围绕基础模型构建的系统,包括规划、工具、上下文和评估机制,并提出评估器与 Held-out 测试应该位于改进智能体的闭环之外。
Self-Harness(Zhang et al., 2026)让 LLM 智能体从自身轨迹中挖掘失败模式,提出对 Harness 的小规模修改,并且只有通过回归测试后才接受这些修改。
RoboHarness(Qu et al., 2026)为 LLM 智能体提供了一个面向机器人操作的视觉几何控制面板,并在 BEHAVIOR Challenge 2025 任务上将其与视觉语言动作模型进行比较。
在世界模型中验证候选程序,意味着用 Test-time Compute 替代真实试验。
离线情况下,3,000 次模拟 Episode 可以在 19 秒内完成对 15 个推动程序的排序。在线情况下,绳子控制器每八步就在世界模型中重新规划一次,每个 0.02 秒的真实执行步约需要 2 秒计算时间。
在学习型世界模型中进行策略评估
WorldGym(Quevedo et al., 2025)是一种 Action-Conditioned Video World Model,通过 Monte Carlo Rollout 和视觉语言模型作为奖励函数,对策略进行评分。其成功率与真实机器人上的成功率具有相关性,并且能够保持不同策略之间的相对排序。
本文的世界模型则由智能体根据少量真实试验自行编写为代码。
Real-to-Sim-to-Real
Torne et al.(2024)通过重建真实场景构建 Digital Twin,在其中利用强化学习改进策略,再将策略迁移回真实环境。
本文的方法中,模拟器是智能体根据少量真实试验自行编写的 Python 文件,策略则通过搜索或代码修改在其中得到改进。
通过验证实现 Code World Model
Schwoebel(2026)使用独立编写并经过验证的代码世界模型,在符号领域生成具有精确标签的轨迹,用于微调 LLM。
Aguilar Martín(2026)则发现,即使 LLM 编写的代码世界模型在采样轨迹上具有完美的状态转移准确率,也仍然可能在实际游戏中失败,因为模型中罕见的错误可能恰好出现在决定胜负的关键规则上。
本文的世界模型也表现出类似特征:它们对程序的相对排序能力优于绝对成功率预测能力。
学习型世界模型
Ha & Schmidhuber(2018)通过像素观测训练神经世界模型,采用 VAE + MDN-RNN 架构,并在 VizDoom 中使用了 10,000 次随机 Rollout。
DreamerV3(Hafner et al., 2023)则完全在学习得到的潜在空间中进行想象和策略训练。
本文的世界模型是 LLM 根据少量结构化观测 Episode 编写的文本代码文件。
Dreamer 从像素中学习,而本文的方法从代码和结构化状态观测中构建世界模型。两者在技术结构上存在明显区别。
11. 总结(Summary)
我们研究了一个问题:面对未知物理系统时,Coding Agent 能否利用少量真实试验自行构建测试环境?
实验表明,智能体能够在全部八项任务中构建这样的测试环境。它们在 Mission C、推动方块、Doom 和绳子任务中发挥了最大作用。这些任务具有三个共同特征:Episode 存在随机变化;物理系统包含智能体事先不知道的隐藏变化;控制器无法利用实时信号自行纠正。
主动观察使智能体能够在采取行动之前自主决定观察什么。在无人机任务中,它用完整一次试验绘制其他飞行器的运动轨迹;在 Push-T 中,两次预设推动操作就找到了隐藏质心。
物理系统包含操作手册没有说明的变化:旋翼性能下降、横风扰动和质心偏移,都被显式转化为世界模型中的估计参数。在绳子任务中,模型不需要识别末端配重,也能在短时间预测范围内较好地复现运动,从而测试抛掷动作。
随机变化使少量真实试验变得不够充分。在存在随机其他飞行器的 Mission C 中,使用相同五次真实试验的情况下,我们的智能体达到了 98% 的 Held-out 成功率,而 CaP 智能体只有 49%。
Test-time Compute 改变了实验结果。CaP 智能体在没有增加任何真实试验的情况下,通过世界模型将成功率从 76% 提升到了 95%。在绳子任务中,每隔 0.16 秒就在模型中测试候选动作,使成功率达到 78%,而仅通过真实试验修改程序的方法只能达到 0–2%。
在 Drone A 和 Mission B 中,两种方法经过一至两次试验后都达到了约 100% 的成功率,测试机制几乎没有额外价值。在电缆任务中,实时读数已经足以让控制器进行反馈调整,世界模型没有提高成功率,但仍然发现了五次成功的真实试验未能暴露的程序错误,并在 150/150 个 Episode 中验证了这些问题。
我们的测试属于近似验证器。它们在推动任务、Doom 和绳子任务中高估了绝对成功率(推动任务高估 17–28 个百分点,绳子任务预测 100%,实际只有 32%)。尽管如此,它们仍然能够对 34 个程序进行排序,平均误差为 5.2 个百分点,相关系数为 。
也许世界模型并不一定需要是一个神经网络。一个包含数百行代码、根据智能体自身实验拟合的 Python 文件,就可能足以成为代码生成与物理部署之间的测试层。这种规模的模型已经接近 Oracle Planner 在绳子任务和未见过的推动方块任务上的表现。当公布一条新的无人机路线时,智能体还能够复用已有世界模型,在没有增加真实试验的情况下找到控制器。
这种方法能否扩展到更困难的任务,以及直接处理像素观测的环境,目前仍有待研究。
Code as Policies 负责生成候选控制器,世界模型测试负责验证它们。在电缆任务中,测试发现了五次成功的真实试验未能暴露的程序错误。在绳子任务中,测试将一个仅能预测 0.4 秒的模型转化为有效控制器:每隔 0.16 秒,就根据实时读数重新验证一次动作。
关于本文(About This Note)
这是一项早期探索性研究,我们将其公开,希望能够展开讨论并进一步修正。如果本文存在理解错误或技术问题,我们欢迎指出。我们也欢迎提出问题、反对意见和修正建议,以便共同完善这项工作。
附录:完整实验结果(The Full Results)
A. 隐藏异常(Hidden Anomalies)
B. 消耗的真实试验次数(Real Trials Consumed)
当 CaP 智能体的 Held-out 测试结果低于 50% 时,我们会增加真实试验次数:Push-T 总计 13 次,Mission C 总计 20 次,Push-L 总计 8 次,Rope 总计 20 次(World Model 智能体也扩展到了 20 次)。
C. 模型与基础设施(Models and Infrastructure)
Orchestrator: Claude Fable 5.2。
Agents: Claude Opus 5.5。
Environment Construction: Claude Sonnet 5.5(电缆环境使用 Claude Opus 5.5)。
RL Baselines: Claude Sonnet 5.5。
Documents: Claude Opus 4.6。
所有智能体都通过一个不透明 API 与环境交互,无法访问环境源代码。任何智能体都无法访问真实模拟器的源代码,也无法查看其他智能体的日志。
D. 实验控制(Experimental Controls)
导入保护(Import Guard)。 如果任何世界模型尝试导入模拟器或环境程序包,自动化测试就会失败。
命令日志扫描(Command-Log Scan)。 每次实验运行结束后,我们都会审查智能体的代码和命令日志。
带时间戳的假设(Time-Stamped Hypotheses)。 每个智能体都必须在第一次真实试验之前提交一份假设文件。所有文件的时间戳均早于对应任务的第一次真实试验。
评估隔离(Evaluation Isolation)。 Held-out 评估日志不会被任何智能体用于模型拟合或参数调优。
跨任务隔离(绳子任务)。 在绳子任务实验期间,电缆任务的程序、日志、世界模型和所有文档都被移出项目目录并锁定。
电缆任务初始条件(Cable Starting Condition)。 两个电缆任务智能体在第一次真实试验之前,都获得了由现有程序记录的 10 个完整 Episode 步骤日志。其他所有任务中,智能体最初都没有任何系统运动记录。作为对照,在删除这些日志后,CaP 智能体仍然达到了 94% 的成功率。
什么是 ASPIRE-style?
我们的 CaP 智能体参考了论文《ASPIRE: Agentic Skills Discovery for Robotics》(NVIDIA GEAR,arXiv:2607.00272)进行设计。ASPIRE 使用的 Rollout 数量远多于我们实验中允许的数量。将真实试验次数限制为 5 次,并非 ASPIRE 原本预期的使用方式。
“Code as Policies: Language Model Programs for Embodied Control”,Liang et al., 2022(ICRA 2023)。Code-as-Policy 指任何使用 LLM 生成可执行代码,并将其作为控制器表示形式的方法。
Lu et al.(2026)。“ASPIRE: Agentic Skills Discovery for Robotics”,NVIDIA GEAR,arXiv:2607.00272。也可参阅 research.nvidia.com/labs/gear/aspire。本文的 CaP 智能体是在五次真实试验限制下重新实现的版本。
Ha, D. & Schmidhuber, J.(2018)。“World Models”。arXiv:1803.10122。其方法使用像素观测、VAE 和 MDN-RNN,并通过 10,000 次随机 Rollout 进行训练。
单侧 Clopper–Pearson 置信界:对于 5/5 次成功,计算结果为 ;当每个版本只被测试一次时,1/1 次成功对应的下界为 。
Meta FAIR CodeGen Team(2025)。“CWM: An Open-Weights LLM for Research on Code Generation with World Models”。arXiv:2510.02387。
Wang et al.(2026)。“Code as Worlds: Agentic Discovery of Executable World Representations for Physical Reasoning”。arXiv:2608.27549。
Chen, Lin and Zhang(2026)。“Code World Model: Coding Agent as World Brain”。arXiv:2608.25927。
Weng, L.(2026)。“Harness Engineering for Self-Improvement”。Lil’Log,2026 年 7 月 4 日。
Zhang et al.(2026)。“Self-Harness: Harnesses That Improve Themselves”。arXiv:2606.09498。
Qu et al.(2026)。“RoboHarness: A Simple Harness Outperforms VLA and World Action Models”。arXiv:2610.14018。
Quevedo, Sharma, Sun, Suryavanshi, Liang and Yang(2025)。“WorldGym: World Model as An Environment for Policy Evaluation”。arXiv:2506.00613。
Schwoebel(2026)。“World-Time Compute with Verified Code World Models”。arXiv:2609.09163。
Aguilar Martín(2026)。“When a Verified World Model Still Loses: Play-Adequacy vs Prediction-Accuracy in LLM-Synthesized Code World Models”。arXiv:2607.14169。
Anthropic(2026)。“Claude Fable and Mythos 5.2”。Anthropic,2026 年 11 月 9 日。
Chen et al.(2026)。“Systematically Exploring the Capabilities of GPT-6 Astra as Embodied Policies”。arXiv:2609.38537。
致谢(Acknowledgements)
本文研究借鉴了 Code World Models(Dainese et al., 2024)、WorldCoder(Tang, Key and Ellis, 2024)、CWM(Meta FAIR CodeGen Team, 2025)、Code as Worlds(Wang et al., 2026)和 Code World Model(Chen, Lin and Zhang, 2026)。
本文的研究灵感来自 Saltline:一个约 1.43 MB 的单文件浏览器 FPS 游戏,由 Claude Fable 5.2 一次性生成,开发者为 Felix Rieseberg(Anthropic)。
引用(Citation)
@misc{cawm2026,
  title       = {World Models as Unit Tests},
  author      = {Denzel Zheng},
  institution = {Princeton University},
  year        = {2026},
  note        = {Early research note. Simulators stand in for
                 reality; one run per agent per task; results
                 are not peer-reviewed.},
  howpublished = {\url{
}来源:human five