“把计分牌上的数字加二,再按下按钮。”
这句话人说一遍就懂,机器人却得先找到计分牌、认准上面的数字、翻对两页、确认没翻错,最后才伸手按下去——中间任何一步错位,前面的力气都白费。
可动作准只是第一步。机器人还得随时知道“自己做到第几步了”,才知道下一步该干什么;而真实任务里的指令常常带数量、带条件,背景、光照、桌面纹理一变,靠画面记下的那套操作就可能失效。这也是很多模型在仿真里表现出色、换到现场却明显掉下来的原因。
现有方法大多只补上了一半:世界动作模型擅长预测接下来的画面,动作因此有了物理依据,但它并不清楚自己正在完成哪个子任务;代码式机器人系统能把任务写成程序、调用现成技能,条理清楚,却常常“看不见”真实世界的变化。AW-0的思路是把这两半接起来——让机器人把计划写成一段代码,再让这段代码在生成未来画面和动作时全程在场。
加州大学伯克利分校、英伟达与宾夕法尼亚大学研究团队提出AW-0(Agentic World Action Models):在统一的Mixture-of-Transformers(MoT)架构中,让技能程序、未来视频与连续动作一起生成,由此,让代码中的任务计划直接参与预测和控制。
实验给出了初步答案:RoboTwin 2.0的Clean与Random两种设置平均成功率达到50.7%;八项真实机器人任务的平均评分达到71.1分(百分制),较最强对比基线高25.1分。
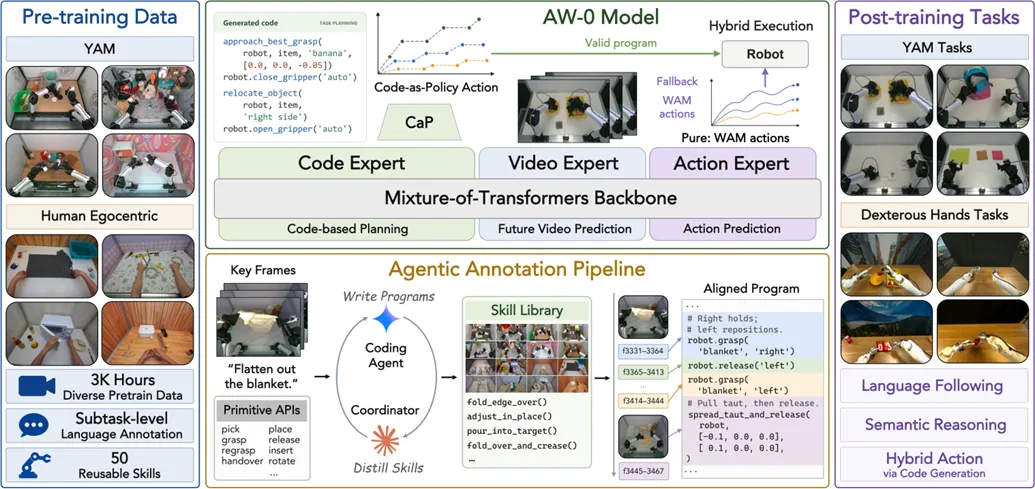
图1|AW-0总览。模型连接代码规划、未来视频预测与连续动作生成,并通过自动标注流水线学习可复用技能。来源:论文Figure 1。
11月25日(周三)晚8点,深蓝学院邀请到AW-0论文一作、北京大学的刘卓洋同学进行在线分享,主题为【具身基础模型的多模态感知与统一规划】。
本期直播将重点介绍AW-0:在统一架构中联合生成技能程序、未来视频与机器人动作,将可组合的技能规划、物理动态预测与连续控制相结合,连接高层意图与底层执行。通过真实机器人案例,探讨这一范式如何提升指令跟随、场景理解与复杂任务泛化能力,以及迈向通用具身智能的机遇与挑战。
点击预约,报名直播
 深蓝AI
01
—
三位专家协作让计划参与预测和控制
每次规划,AW-0都要同时生成当前的技能程序、接下来的画面和机器人动作。模型读取多视角观测、语言指令与机器人状态,再结合此前程序片段的紧凑记忆,把“要做什么”与“接下来会发生什么”联系起来。
三位专家,分工协作。代码专家根据场景和指令写出带参数的技能程序;视频专家预测后续画面;动作专家生成连续动作块。各专家保留自己的参数,通过共享注意力交换信息。
其中,信息按代码→视频→动作的方向传递:视频和动作都能读取代码,动作还可以读取视频表征。这让正在生成的任务计划持续参与未来预测,也为动作提供语义指导。
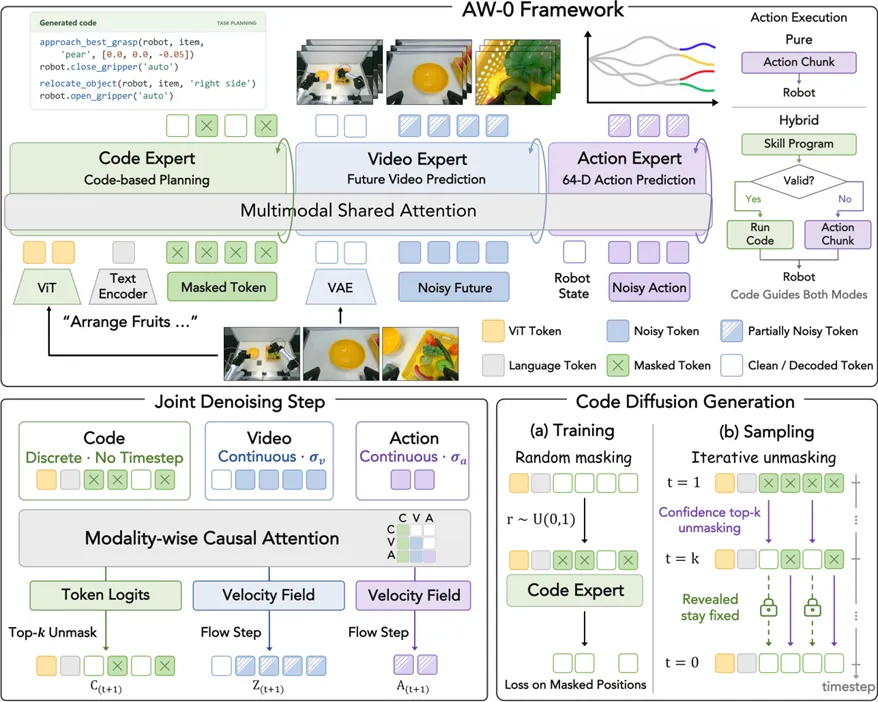
图2|AW-0的MoT架构。代码、视频与动作专家通过联合注意力交换信息,并在同一过程中去噪生成。来源:论文Figure 2。
生成过程也在同步推进。代码通过离散掩码扩散,逐步补全被遮蔽的程序;视频与动作通过连续流匹配,从噪声中逐步细化。三个专家在同一组迭代步骤中协作,无需等待整段代码写完。
为了让视频特征更好地帮助动作预测,训练时还会对视频噪声分布进行重采样,并用不同的损失权重平衡各模态的训练目标。
深蓝AI02
—
从操作演示中提炼可复用技能
有了能生成代码的模型,还需要与动作对应的程序标注。研究团队把目光转向已有的机器人演示和第一视角人类操作视频,为一段段操作配上对应的技能程序。
先从演示里发现技能。系统为每项任务抽取演示,由编码智能体基于预定义接口生成子任务程序,再由协调智能体找出反复出现的操作,将它们整理成可复用技能。
再让整套数据使用同一套技能词汇。技能库冻结后,系统重新标注抽样演示,将子任务与程序的对应关系存入缓存。
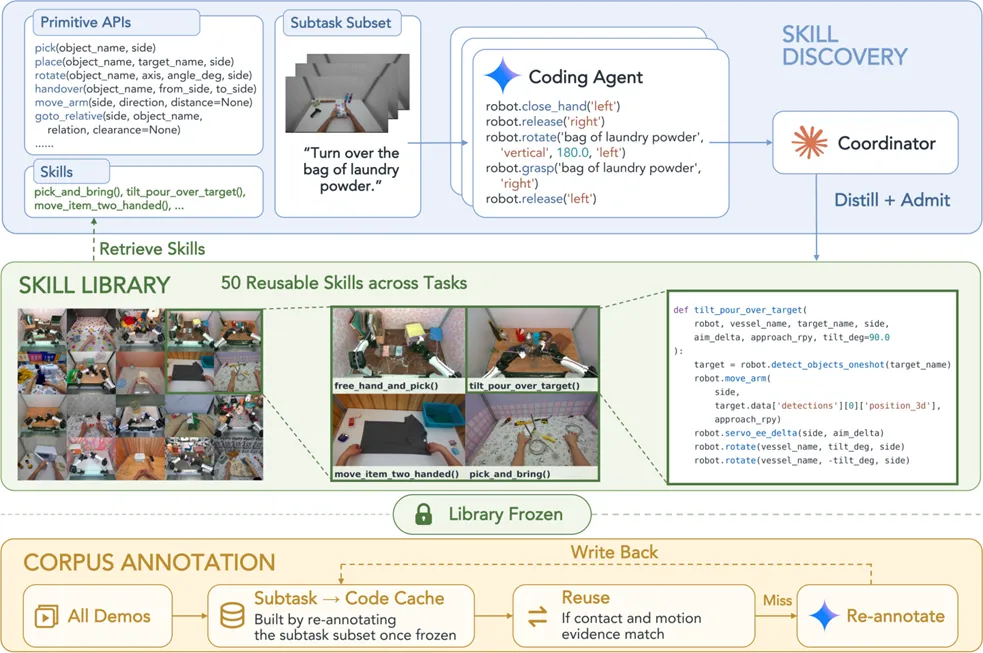
图3|自动代码标注流水线。先生成子任务程序并整理技能,再冻结技能库,以缓存复用扩展到全量演示。来源:论文Figure 3。
最后,把标注扩展到全部演示。遇到新片段,系统先根据接触与运动证据判断缓存中的程序是否适用:匹配就复用,未匹配到再生成新标注并加入缓存。这样,画面与动作轨迹就有了对应的程序步骤。
深蓝AI03
—
让技能程序进入规划与执行
程序标注准备好后,就可以用来训练代码专家。条件提示与当前子任务程序片段一起进入代码流,模型学习补全被掩码遮住的程序。到了推理阶段,每次重新规划都会更新提示,让待补全的代码与视频、动作一起生成。
默认模式下,代码用来指导规划,动作块负责驱动机器人。以装背包为例,生成的程序会写明拉链拉头、右臂与抓取技能。一个操作步骤因此有了明确的对象、参数与技能调用,也更便于检查。
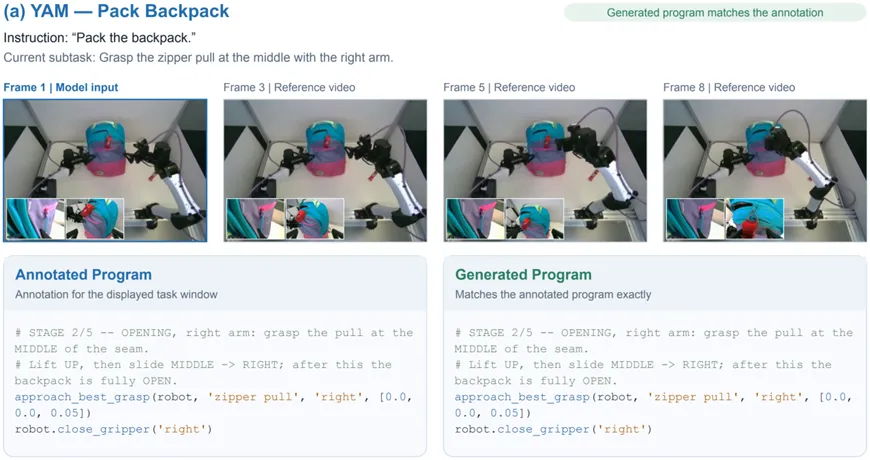
图4|装背包任务中生成的技能程序。生成程序记录于部署时,参考程序来自另一段同类演示;后续画面依论文正文为同次部署记录。来源:论文Figure 31。
任务做到哪一步,也要记下来。AW-0将此前生成的程序片段压缩为一组记忆token,供代码专家读取。这份记忆在每轮任务开始时清空,随后随新生成的程序片段更新。
代码还可以成为执行入口。在混合模式中,通过有效性与进度检查的程序会调用感知与控制原语执行;未通过时,机器人继续使用同一次前向生成的动作块。
训练分为预训练和下游微调两个阶段。AW-0先使用约2,000小时YAM机器人演示和1,000小时人类操作视频进行联合预训练。标注Pipeline共整理出50个技能条目,其中YAM23个、人类数据27个。
进入下游任务后,团队沿用冻结的技能库标注新演示,再联合微调代码、视频和动作生成,让通用技能计划与具体任务衔接起来。
深蓝AI04
—
RoboTwin仿真检验代码规划的效果
首先在RoboTwin中检验这套方法。对照模型包括π₀.₅、EgoScale、DreamZero与WLA,默认AW-0与基线使用相同的任务演示和评估协议。测试覆盖50项任务,每项用50条Clean演示训练,并在Clean、Random两种设置下各评估50次。
Hybrid则另用CaP程序演示训练,因此这组对比同时涉及训练数据与执行方式的变化。
AW-0默认模式交出的成绩是:两种设置平均成功率50.7%。优势在Clean设置下更为突出——成功率达到80.8%,比最强对比基线WLA的64.8%高出16.0个百分点。
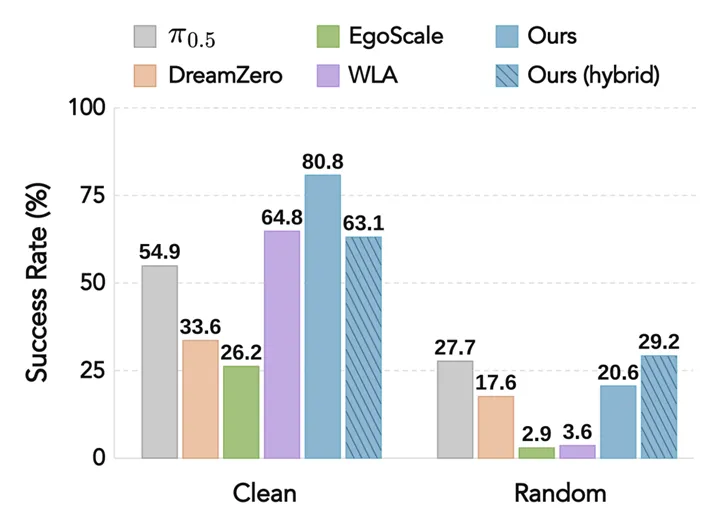
图5|RoboTwin 2.0的Clean与Random成功率对比。Ours为AW-0,Ours(hybrid)为混合执行配置。来源:论文Figure 4。
当背景、桌面纹理和光照等条件发生随机变化,考验也随之加大。Random设置下,默认模式降至20.6%,低于π₀.₅的27.7%;混合模式达到29.2%,但其Clean成功率为63.1%,低于默认模式。
两种配置各有长处,也说明应当把执行方式和训练数据放在一起考察。
深蓝AI05
—
双臂与灵巧手上的真实操作
从仿真走向真实操作,团队选择了两类硬件:配备平行夹爪的YAM双臂平台,以及搭载两只22自由度灵巧手的Tianji–Sharpa平台。八项任务覆盖整理水果、装背包、更换灯泡、叠毛巾,以及用夹子整理水果、发牌、翻计分牌和受限设置下的魔方复原。
每项任务使用100条演示进行后训练,以3个训练种子、每个种子16次评估测试。这里按任务步骤的完成情况计分,允许部分得分,因此下文报告的是平均任务评分,不是完整任务成功率。
论文表2中,AW-0的八项任务平均评分达到71.1分(百分制),高于DreamZero的46.0分、π₀.₅的43.6分、WLA的39.9分与EgoScale的35.9分,较最强对比基线提升25.1分。
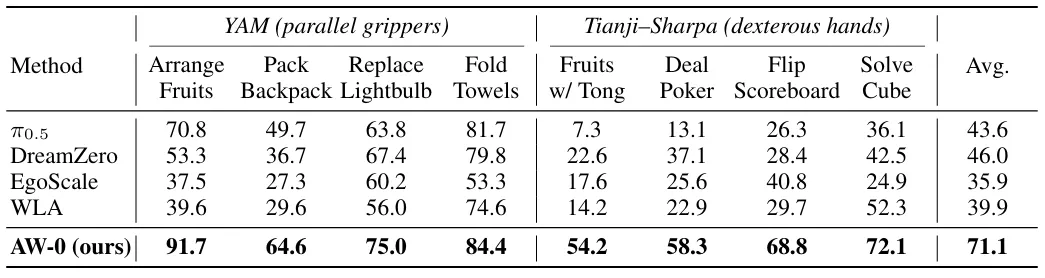
这些提升落在了具体操作上:YAM整理水果得分91.7,翻计分牌得分68.8,分别要求机器人按指令选取对象、完成计数;发牌与更换灯泡得分为58.3、75.0,则考验双手配合与精细接触。
在论文评估的八项真机任务中,AW-0的得分均高于所比较的基线。
程序直接参与执行,也在真机上得到了检验。对同一后训练模型,在相同评估条件下,YAM叠毛巾评分从默认动作块执行的84.4提升到90.6。下图中,通过检查的技能程序接管部分阶段,其余阶段由动作专家继续控制。
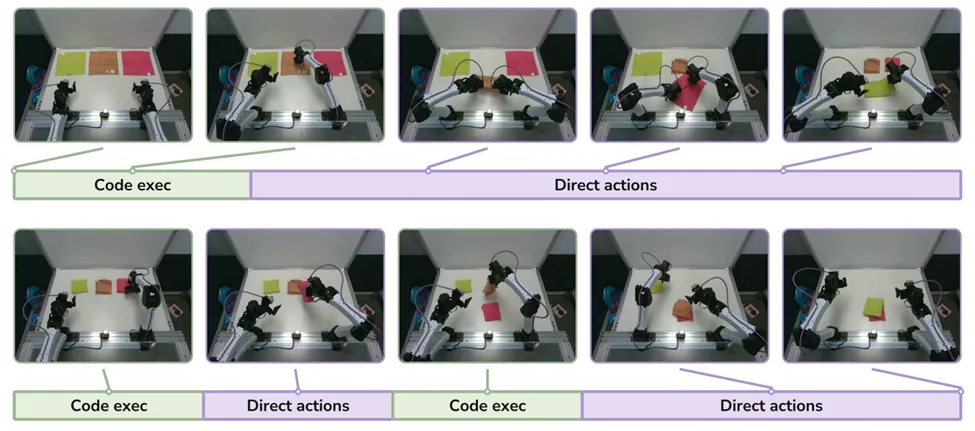
图6|真实叠毛巾任务中的混合执行。绿色为代码执行,紫色为动作专家直接输出;这项实验限定在YAM平台,不能外推为所有任务和灵巧手平台上的普遍收益。来源:论文Figure 35。
深蓝AI06
—
拆解性能提升背后的三个因素
先看代码放在哪里。团队比较了无代码、视频→代码→动作、代码→视频→动作三种结构。整体结果支持让代码同时指导视频与动作生成,也就是让任务计划在预测阶段就发挥作用。
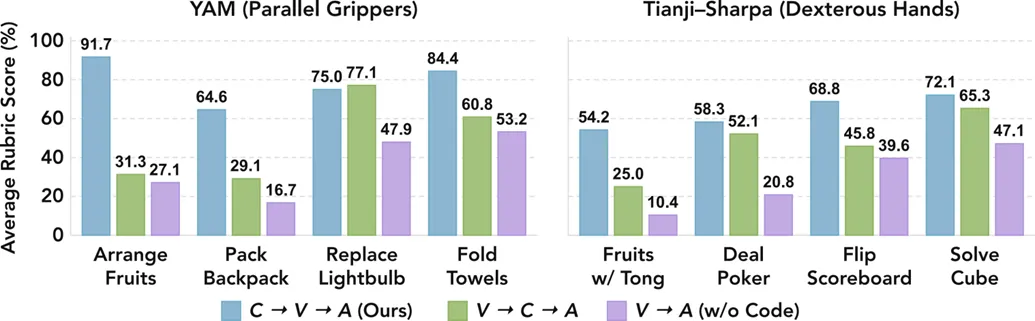
图7|代码专家与注意力结构消融。C、V、A分别代表代码、视频和动作;指标为真机任务评分,个别任务的排序不同。来源:论文Figure 5。
代码专家“看场景”的方式同样影响结果。采用专用ViT表征,在八项任务上都优于复用VAE特征,平均评分为71.1对55.6(论文表3)。
再看程序里哪些信息有用。去掉注释或可复用技能调用后,八项任务的表现均下降。例如,移除技能调用,发牌评分就从58.3降至42.0。完整程序还在八项任务中的七项优于纯自然语言子目标,表明技能抽象、解释性语言与程序结构都在提供规划信息。
最后看生成方式。与自回归代码生成(AR)相比,联合去噪在八项任务中的七项表现更好,平均评分为71.1对54.5。
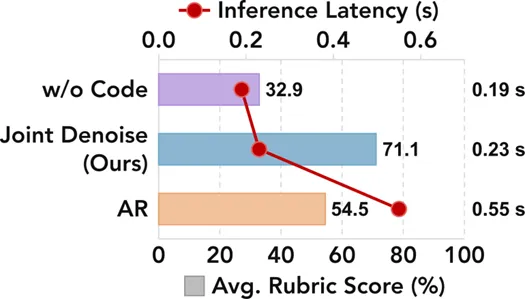
图8|联合去噪与自回归代码生成对照。柱状图为平均任务评分,折线为RTX 5090上的端到端推理延迟。来源:论文Figure 6。
速度也有改善。在论文测试配置下,联合去噪的端到端延迟为0.23秒,AR为0.55秒,对应2.39倍加速。与无代码版本的0.19秒相比,代码流增加了0.04秒开销,同时改善了八项真机任务的表现。
深蓝AI07
—
让技能规划走进世界动作模型
放回已有研究中看,AW-0连接了两条技术路线。
世界动作模型把未来视频与动作生成结合起来,用物理动态预测辅助操作;一些工作进一步加入子任务预测。AW-0则让带有显式参数、技能调用和控制逻辑的程序参与联合生成,使预测能够读取更明确的任务计划。
另一条路线是Agentic Robotics。Code-as-Policies等工作通过程序组合感知与控制接口,后续编码智能体进一步探索编写、执行和修复程序。AW-0把代码引入端到端模型,作为高层规划接口,同时探索用生成程序补充动作专家的直接控制。
让任务计划参与预测,也参与控制,是AW-0的核心尝试。自动标注把操作演示转化为学习这种能力所需的程序;从RoboTwin到双臂与灵巧手,实验展示了它对指令遵循、语义推理和技能执行的帮助。
接下来,技能如何在交互中持续改进,仍值得探索。当前系统在视觉随机化和程序可靠性方面还有提升空间,也尚未实现从自身交互中在线持续学习。技能复用与交互反馈,为连接规划、预测和执行留下了进一步研究的方向。
到这里,AW-0的链条已经走完一遍:代码规划、未来预测、连续动作,以及把三者串起来的自动标注与混合执行。受篇幅所限,推送只能讲到这——哪些设计真正在起作用、这条路接下来往哪走,还有很多值得展开的部分……
下周三晚8点,我们把AW-0的第一作者刘卓洋同学请到了直播间,点击下方预约按钮,一起参与直播,共同交流吧~
直播设有在线QA环节哦~
点击预约,报名直播 
论文题目:Agentic World Action Models
论文链接:https://arxiv.org/abs/2610.30136v1
项目主页:https://agentic-wam.github.io/
代码:https://github.com/ZhuoyangLiu2005/agentic-wam
模型权重:https://huggingface.co/miniFranka/agentic-wam-pretrain-yamego3k-soup-e1
来源:深蓝具身智能