上一篇博客介绍了 VLA 的历史及其演进过程。写完之后,我想亲自动手,围绕 VLA 做一些实验。
VLA简史:从RT1到MolMoAct2
遗憾的是,我没有太多算力。我偶然发现了 nanogpt,它的目标是用尽可能少的算力训练一个类似 GPT 的模型。我想,我也可以在笔记本电脑的 GPU 上做类似的事情!!
microVLA 就这样诞生了。这是一篇简短的开发日志,记录了我在开发这个项目时的直觉和想法 :)
背景与动机
给不了解 VLA 的读者一个简短说明:在 VLA 中,你给模型一张相机图像和一条指令,例如“拿起盘子旁边的黑碗,把它放到托盘上”,模型就会输出控制机械臂的电机指令。
我想亲自动手研究 VLA,以便建立更好的直觉。但最近的大多数模型,例如 π0 和 π0.5,参数量都达到数十亿,训练时使用了大量算力,而且它们的规模也难以在移动芯片上轻松进行推理。
除此之外,我还想做一些架构消融实验,并学习 VLA 的推理优化。nanogpt 提供了一个可以效仿的清晰范例,于是我开始用 Claude 动手开发这个项目。
目标是:如何在笔记本电脑的 GPU 上完成简单的训练和推理,同时让代码易于理解和修改,方便我快速迭代。
让训练跑起来
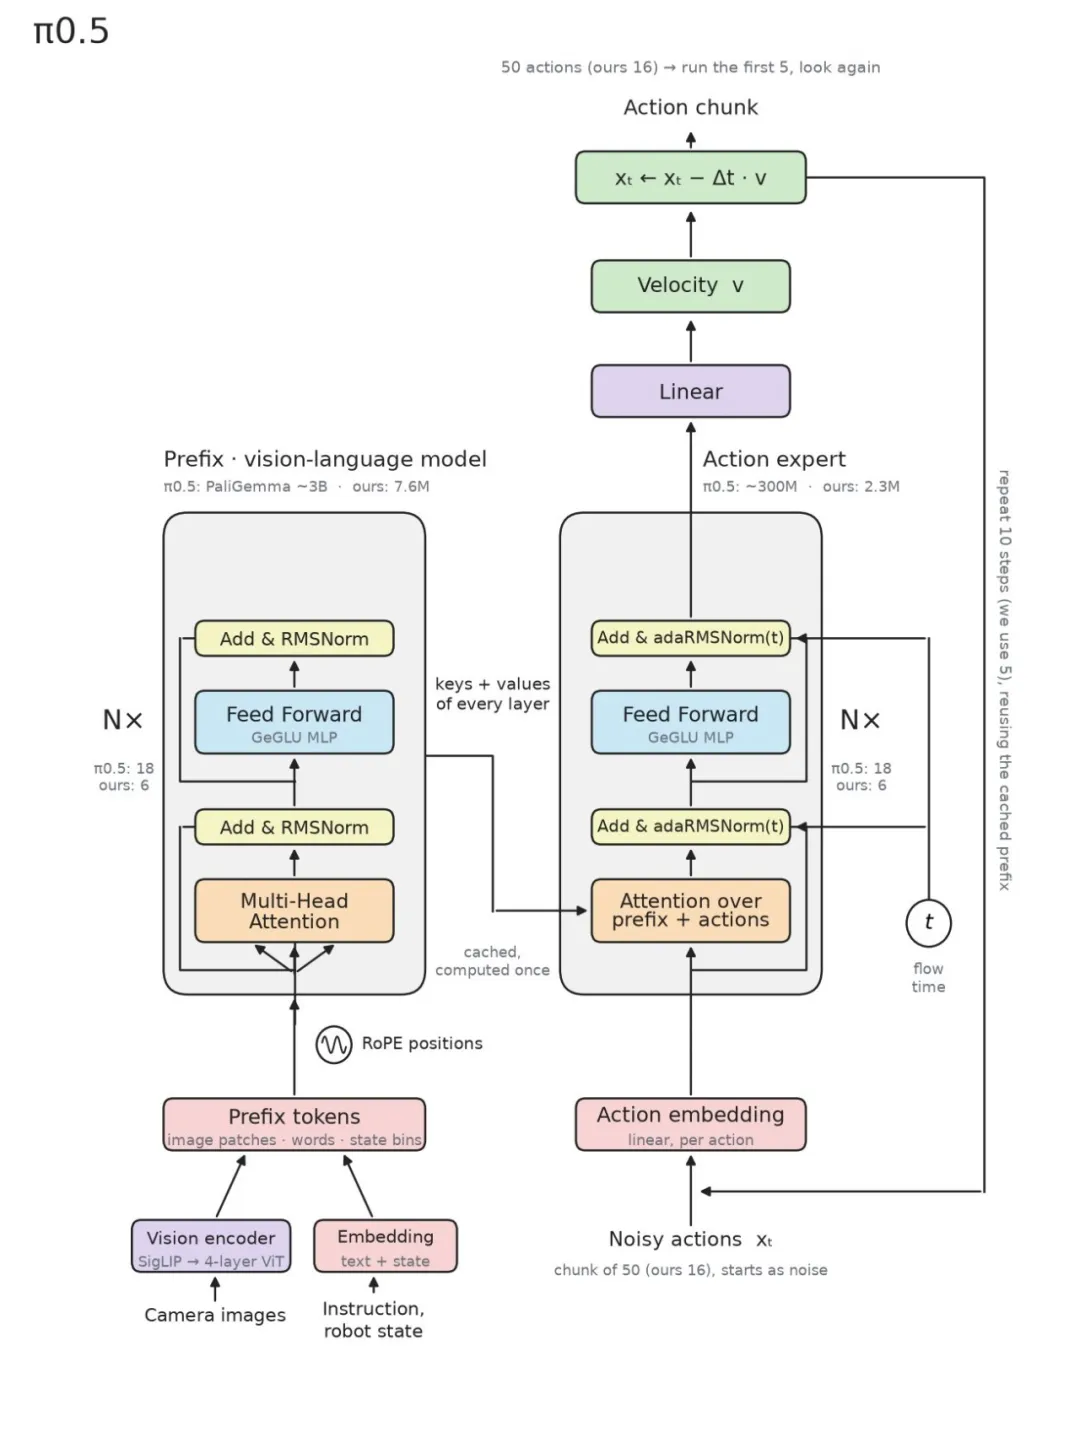
图 1:π0.5,以及我们的 10.5M 参数版本如何缩小各个部分。
我选择 π0.5 作为想要实现的模型架构,因为:
- 它很受欢迎;
- 它由一支非常强的团队开发,这支团队也参与了最早一批 VLA 的开发;
- 我喜欢它。
简单来说,VLA 根据图像 patch、语言指令和机器人状态预测一个动作块。Action Expert——一个规模较小、基于 Transformer 的模型——根据它看到的前缀数据预测动作。
动作通过 Flow Matching 生成。从一条示范中取出一个真实动作块 ,再取出形状相同的随机噪声 ,在两者之间画一条直线:
沿着这条直线的方向始终是 ,因此模型要学习从直线上的任意一点预测这个方向。
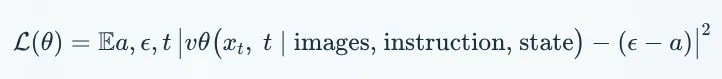
执行动作时,从纯噪声出发,沿着预测方向走几步,最终得到一个动作块。不过,这些数学内容确实有点难理解,所以这里有一张更直观的图,帮助我更好地理解了其中的数学原理。
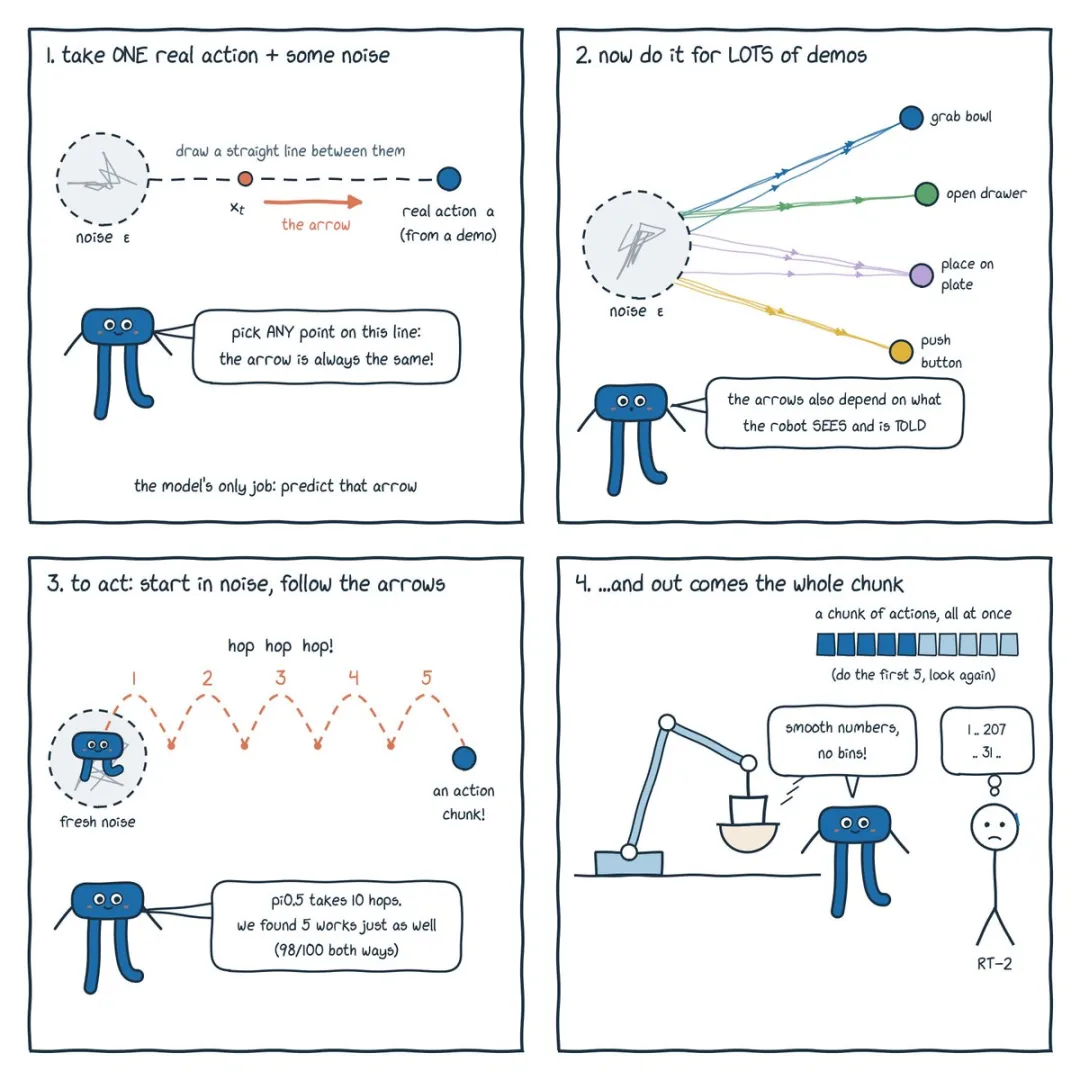
图 2:用四个面板解释 Flow Matching。
基础实现与合理性检查
我将 π0.5 缩小到大约 10.5M 参数:一个 4 层视觉 Transformer(1.9M)、一个 6 层前缀 Transformer(5.7M)和一个 6 层 Action Expert(2.3M)。开始训练之前,我想先对整个配置做一次合理性检查。
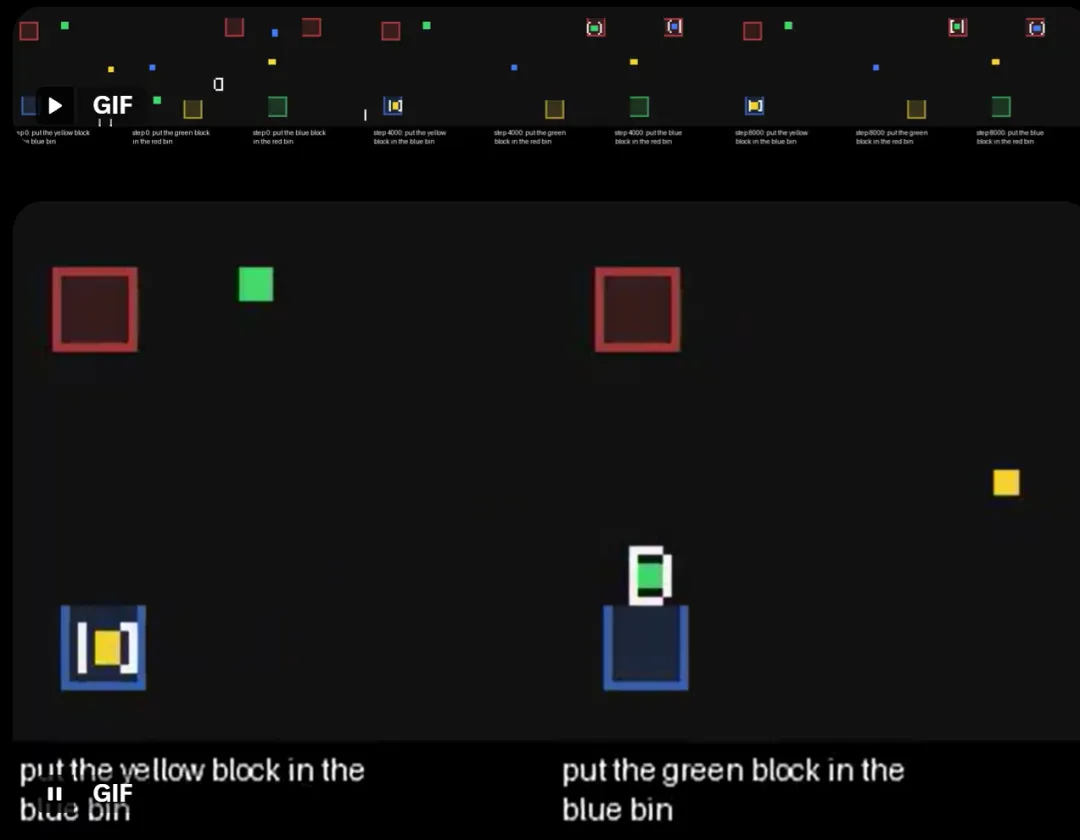
最初我想从 LIBERO 开始——后来我确实用它进行了训练——但用它做合理性检查会花太长时间,于是我创建了一个供 VLA 求解的玩具数据集和玩具问题。这个玩具世界是一个在 GPU 上运行的二维抓取放置环境,有两个彩色方块、两个彩色盒子,以及“把红色方块放进蓝色盒子”这样的指令。
模型开始训练了,损失也下降了,但机械臂基本不知道该做什么。我记录了预测移动方向与专家移动方向之间的余弦相似度:如果模型知道该往哪里走,这个值应该接近 1。结果是 。模型看不见东西吗(?)
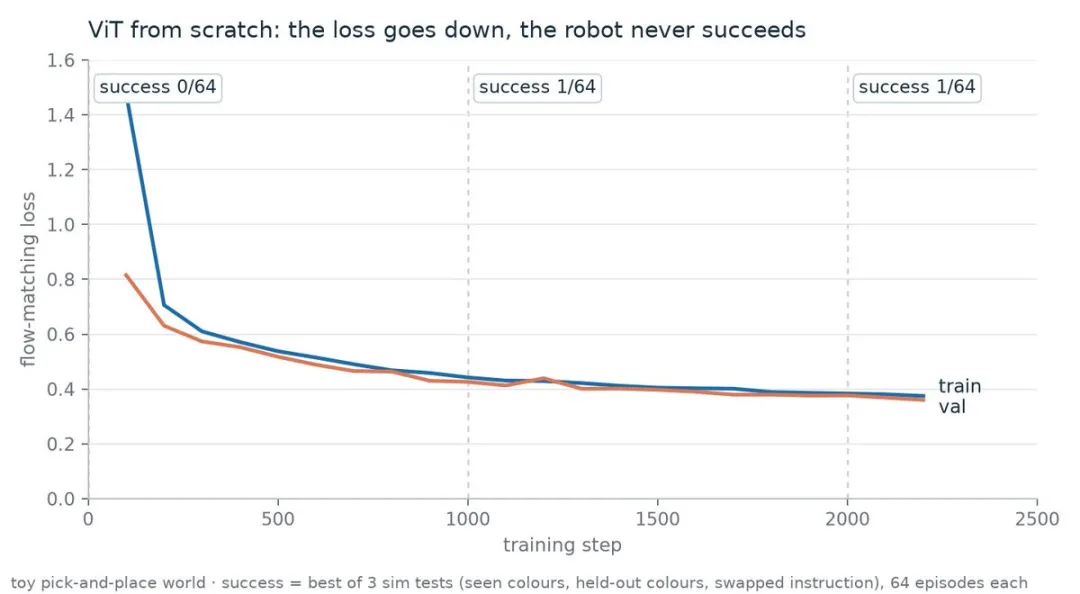
图 3:第一次运行,从零训练 ViT:损失看起来很正常,机器人却没有做出任何有用的动作。
在尝试修复视觉问题之前,我想先确认问题确实出在视觉上。因此,我训练了另一个版本:不给模型图像,而是将方块和盒子的真实位置作为 token 输入。这个版本的方向余弦相似度达到了 0.86,夹爪开合正确率为 93%,而且它能够对指令作出响应。
也就是说,除了视觉,其他部分都能正常工作。想想视觉编码器需要完成什么,就能理解这一点:仅凭一个告诉它“你的动作有点偏差”的损失信号,一个小型 ViT 就必须学会什么是方块、方块在哪里,以及如何区分不同颜色。对于学习视觉能力而言,这是一个非常弱的信号。真正的 π0.5 也不是从机器人数据中学习视觉能力的;它从预训练的 SigLIP 开始。
因此,我可以选择使用预训练视觉骨干网络,也可以将它蒸馏到我的模型中。直接使用 SigLIP 会让视觉部分的参数量达到约 90M,几乎是模型其余部分的十倍,这就违背了构建小型 VLA 的初衷。
所以我选择了蒸馏:在任何动作训练开始之前,让我的小型 ViT 学习模仿一个冻结的 SigLIP。小型 ViT 的 patch 特征经过一个线性层后,使用余弦损失与 MSE 损失进行训练,以匹配 SigLIP 在相同图像上的 patch 特征。我调整了 SigLIP 的输入尺寸,让两个模型生成相同的 patch 网格。这样,我的 ViT 的每一个 patch 都能获得大模型在对应位置看到的信息。
它立刻就奏效了:
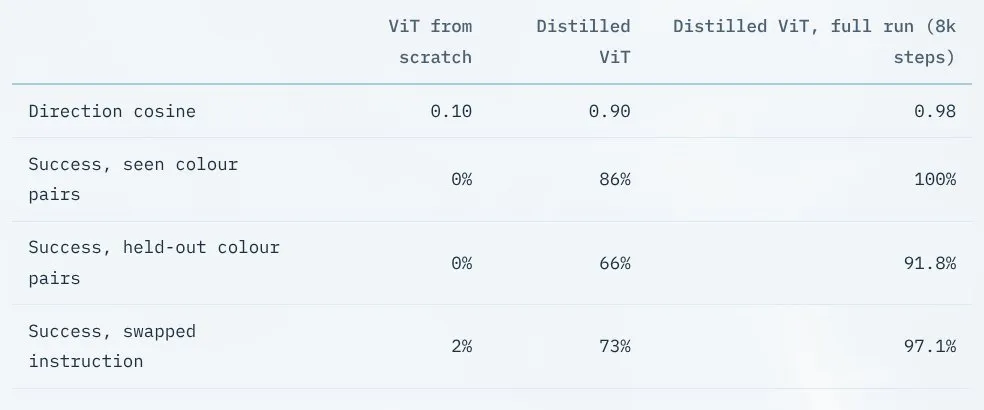
前两列对应同一次仅训练 1,200 步的短实验,唯一改变的是视觉编码器。未见过的颜色组合和交换后的指令,是我最关心的测试。模型在训练时从未见过的颜色组合上取得了 91.8% 的成绩,而且在相同场景下能够遵循改变后的指令。这说明模型确实在读取指令,而不是记忆动作。
在 LIBERO 上训练
玩具世界跑通后,是时候尝试真正的机器人 Benchmark 了。我选择了 LIBERO,因为大多数 VLA 论文——包括 π0.5——都会报告它的成绩。具体来说,我选择的是 LIBERO-Spatial:其中包含 10 项任务,例如“拿起盘子旁边的黑碗,把它放到托盘上”。这些任务中的物体始终相同,但位置会发生变化。
数据包括 432 条人类示范、约 5.3 万帧,以及两个相机视角:一个观察场景,另一个安装在手腕上。我将图像缩小到 96 像素,以便所有数据都能放进 GPU。
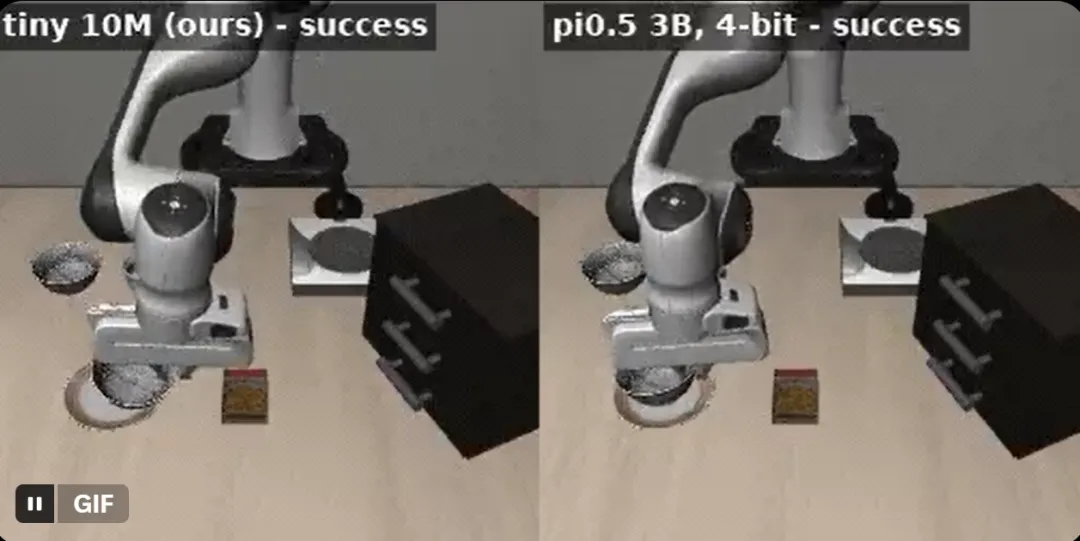
训练方法与玩具环境相同:先进行 SigLIP 蒸馏,再进行 8,000 步 Flow Matching 训练。训练耗时约 25 分钟,模型在 100 次 episode 中成功完成了 75 次,每个动作块的推理耗时为 70 毫秒。太好了!
模型真的在使用输入吗?
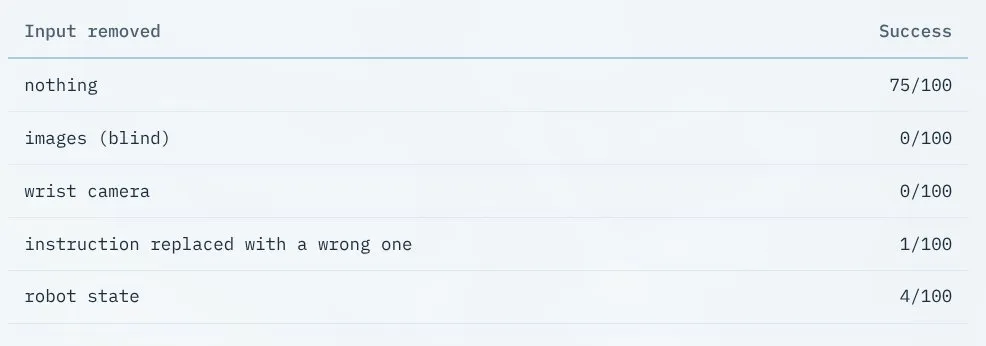
75% 这样的成绩可能让人以为模型已经学会了任务,但实际上,模型也可能只是找到了一条捷径,例如始终从相同的起始位置执行相同的动作。
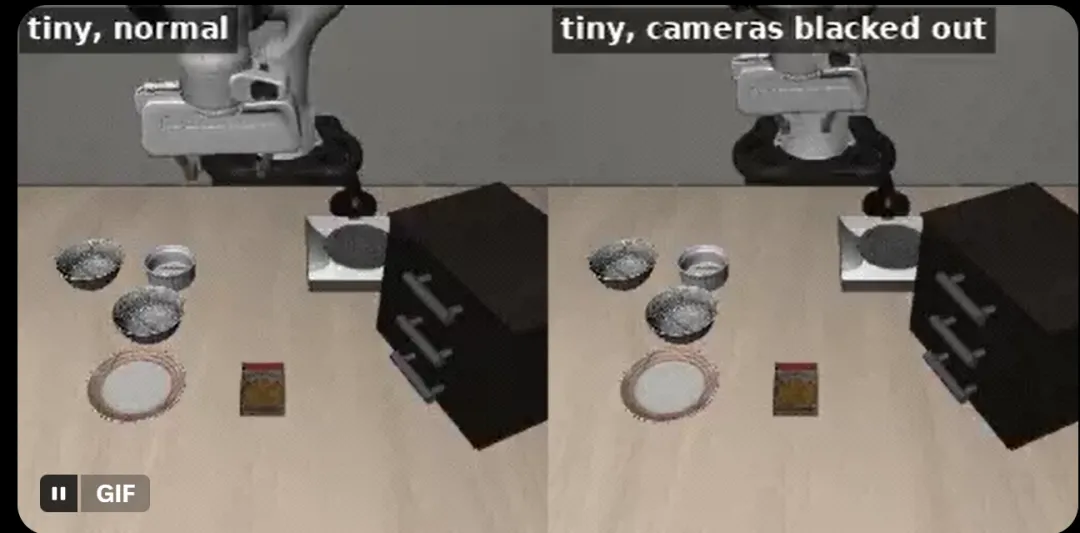
因此,我每次移除一种输入,然后再次运行模型:
突破 75%
在做任何改动之前,我先划分了 Benchmark。每个 LIBERO 任务都有 50 种固定的初始布局,因此我使用编号 0–19 的布局来做决策,直到最后才接触编号 20–49 的布局。这是为了防止过拟合。
第一轮改动包括:延长蒸馏时间,从 1,000 步增加到 3,000 步;将 batch size 从 32 增加到 64,因为 GPU 没有被充分利用;对权重使用指数移动平均;以及加入颜色抖动,让模型不能依赖精确的颜色。
我将模型训练了 3 万步,想看看它从什么时候开始不再提升。验证损失在大约 5,000 步时降到最低,随后从 0.135 上升到 0.264,几乎翻了一倍。
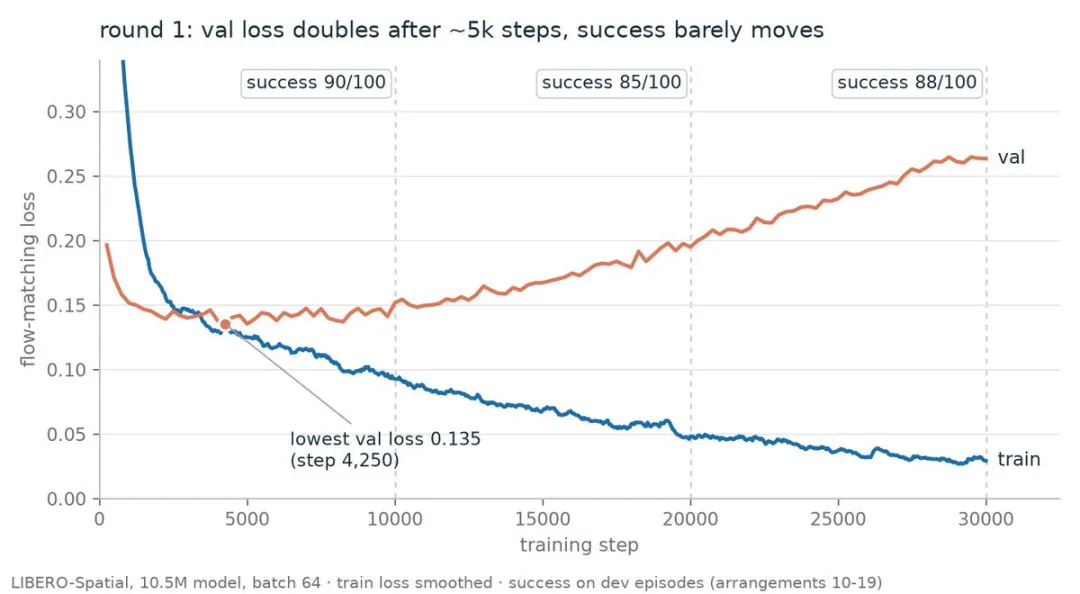
这是教科书式的过拟合,所以我评估了几个 checkpoint,原本以为后期 checkpoint 的表现会很差:
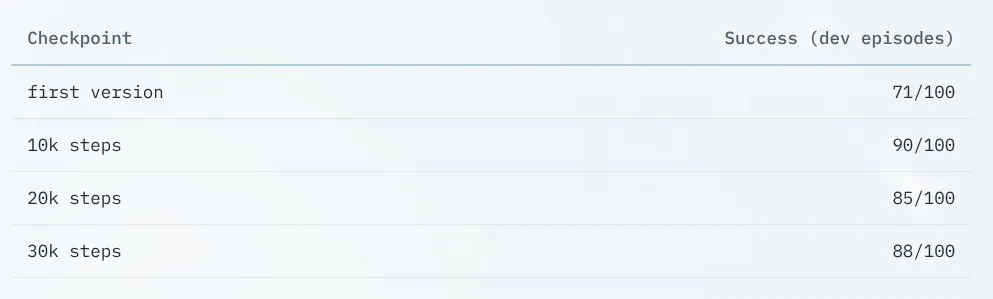
验证损失翻了一倍,但机器人的表现并没有像我想象的那样大幅下降。完成任务只需要一个足够好的动作,因为下一个动作块无论如何都会进行修正。因此,动作与人类动作有多接近——这里的验证损失衡量的正是这一点——在这个实验中并没有那么重要。
第二轮将图像从 96 像素提高到 128 像素,并训练 1 万步,因为我脑海里有一个很合理的解释:抓取涉及微小距离,所以更多像素应该有所帮助。结果,128 像素模型取得了 91/100,而 96 像素模型取得了 90/100。因此,这个解释并没有经受住数据的检验。
接下来是在此前没有使用过的编号 20–49 的初始布局上进行一次最终测试:最终模型成功了 270/300 次,也就是 90%;第一个版本成功了 210/300 次。在相同的 300 次 episode 中,新模型在旧模型失败的情况下成功了 70 次,而只在旧模型成功的情况下失败了 10 次。所以我还可以继续改进这个模型,太好了!
Muon
训练方面的最后一个实验是 Muon,它是 modded-nanogpt 速通挑战所使用的优化器。
Adam 大致上独立地更新权重矩阵中的每一个数值,而 Muon 会对整个更新进行正交化,让权重在各个方向上的移动更加均衡,而不是主要沿着梯度占主导地位的一两个方向移动。
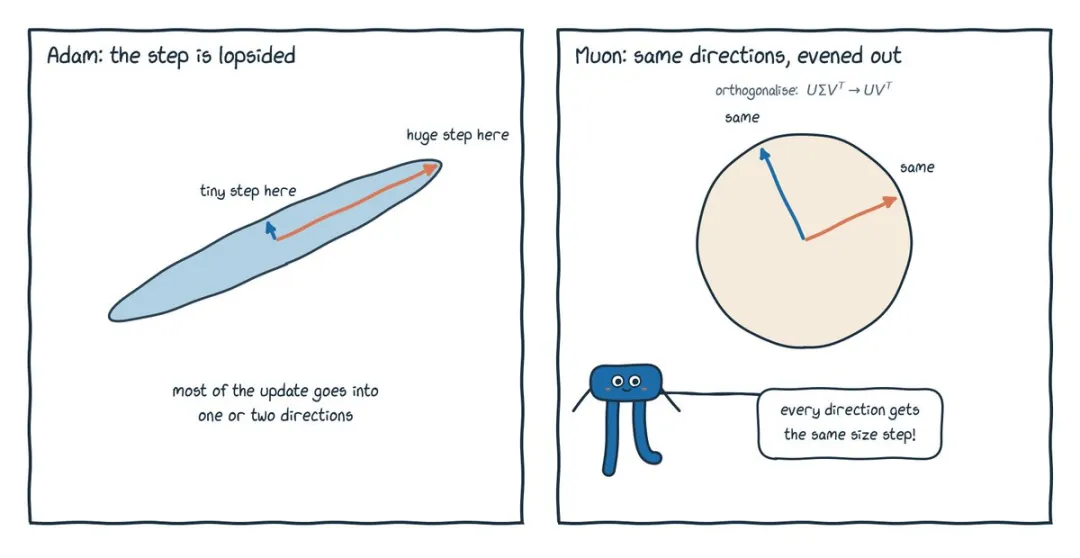
图 8:Muon 保留更新的方向,并使各个方向上的移动幅度更加均衡。
Muon 只适用于二维矩阵,因此我将它用于 Transformer 和 ViT 的权重,其他部分仍然使用 AdamW。
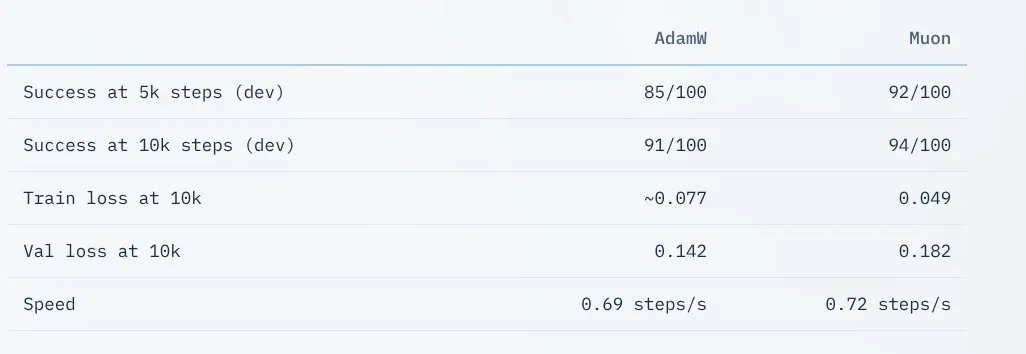
Muon 对训练数据的拟合程度高得多,验证损失上升得更快——和上面的情况一样——而机器人的表现略有提升。
近期我想针对这个 VLA 的不同组件做更多这样的消融实验,详细研究每个组件对性能的影响,或许还会把它变成一项速通挑战 :)
在 4 GB 显存上运行真正的 π0.5
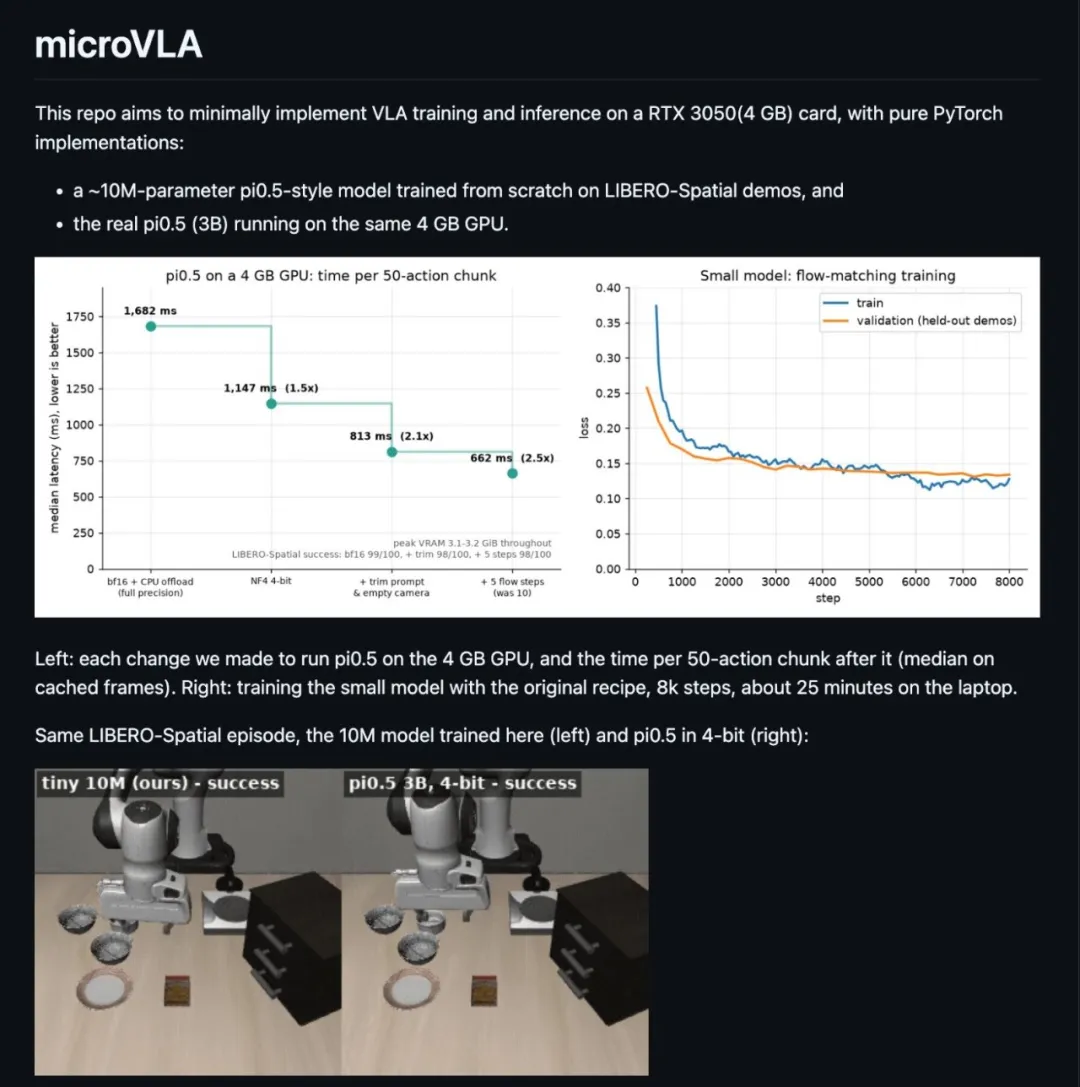
这个项目的后半部分也涉及推理优化。π0.5 大约有 3B 参数,使用 bf16 时,每个参数占 2 字节,因此仅权重就需要约 6 GB。
我的笔记本电脑只有 4 GB 可用显存,于是问题来了:我该怎么让它跑起来,哈哈。
尝试一:bf16 加 CPU 卸载。 将能够放下的部分保留在 GPU 上,每次生成动作块时,再从 CPU 内存中复制其余部分。这保留了完整的 bf16 精度,但每次都要付出复制的代价,主要受限于 CPU 和 GPU 之间的数据传输速度。
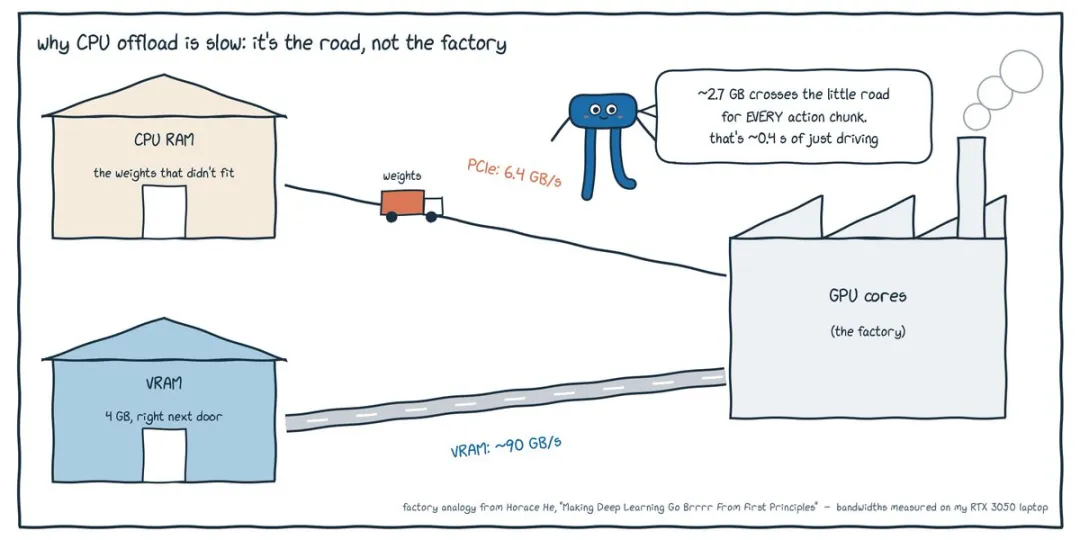
图 9:参考 Horace He 的《Making Deep Learning Go Brrrr From First Principles》。
尝试二:4-bit 权重。 NF4 用 4 bit 存储每个权重,并为每个块设置一个缩放因子。我量化了视觉和语言部分,让 Action Expert 保持 bf16,因为它的规模较小,而且负责输出实际的数值,所以我想保留这部分的精度。
按照常规方式加载时,会先在 CPU 内存中构建整个模型,我的笔记本电脑无法很好地应对。因此,我在 PyTorch 的 meta device 上构建模型:只创建形状,不分配实际内存,然后一次填充一个张量。
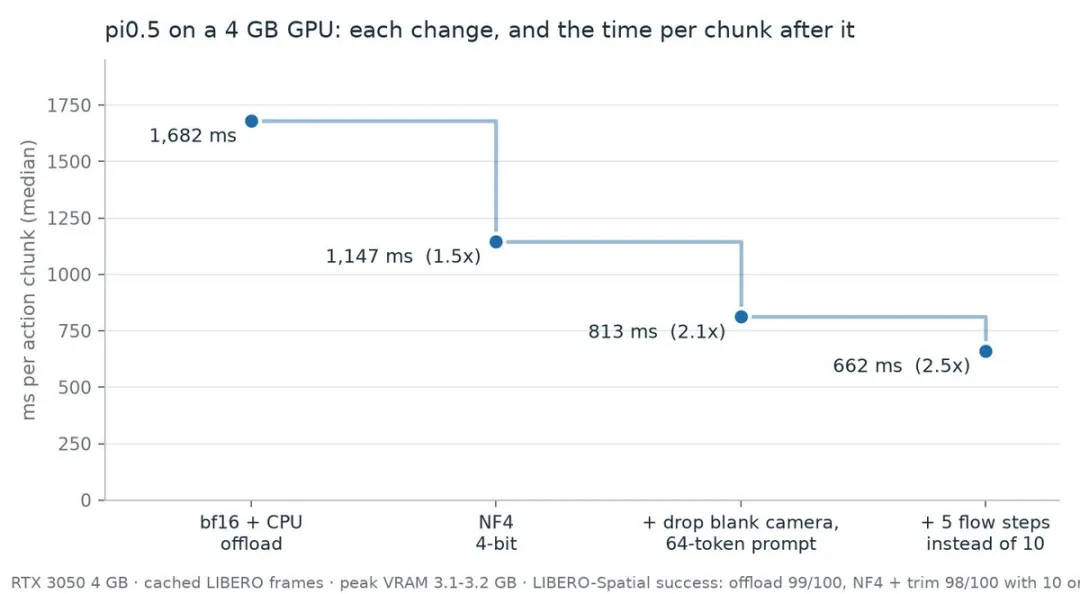
这样模型终于放得下了:推理耗时 1,147 毫秒,显存占用为 3.22 GB。
接着,我查看了模型实际在计算什么。LIBERO checkpoint 有三个相机输入槽位,但 LIBERO 只有两个相机,因此第三个槽位是一张空白图像,却仍然会消耗 256 个 token。而最长的指令只需要 62 个 token,prompt 却被填充到了 200 个 token。
因此,前缀长度从:
减少到:
输出基本相同——动作变化约为 0.002——推理耗时则降到了 813 毫秒。
最后是 Flow Matching 的采样步数。性能分析显示,前缀计算耗时约 520 毫秒,而每一步 Flow Matching 只需要约 30 毫秒。因此,从 10 步减少到 5 步,最多也只能节省约 150 毫秒。不过试一下没有成本:结果是 662 毫秒。
速度变快,模型会变笨吗?
以上耗时是在保存下来的图像帧上测得的。唯一重要的问题是:机器人是否还能完成任务?因此,我在 LIBERO 仿真器中运行了模型,并尽量与作者的设置保持一致。
我还让每一种设置都在相同的 100 次 episode 上运行,这样就可以逐个 episode 进行比较,而不只是比较总成绩。
结语
要让所有东西都放进一块小 GPU,就必须弄清楚每一个字节和每一毫秒都花在了哪里,而这也正是整个项目的意义所在。
我深入学习了 VLA 的工作原理,以及如何管理和开展好的实验;更重要的是,我理解了软件和硬件如何协同工作。所有内容都在代码仓库中,小模型的第一个版本训练只需要约 25 分钟,所以尽管去折腾它吧 :)
附:我计划把这个项目做成类似 modded-nanogpt 速通挑战的形式,不过针对的是 VLA:设定一个固定的 Benchmark,启动计时器,看看一个小型 VLA 能以多快的速度达到目标成功率。
来源:human five