论文:HALO: Human-Aligned Data Collection for WhoLe-body MObile Manipulation
项目主页:https://robbyant-research.github.io/Lingbot-ALOHA
作者:Shuai Yang*, Fangyi Xu*, Yishu Shen, Kecheng Zheng, Yinghao Xu†(HKUST, Robbyant)
摘要
学习全身移动操作,需要能够同时刻画双臂操作与底盘移动之间协调关系的示教数据。然而,现有的采集接口往往在直接的机器人控制、感知与动作的对齐以及操作者的自然移动三者之间相互取舍,使得高质量的全身协调示教难以获取。
该论文提出 HALO,一个与人对齐(Human-Aligned)的全身移动操作数据采集系统。HALO 将操作者的感知–动作空间与机器人对齐,同时保留直接的物理反馈和自然的人体运动:操作者通过直接示教(Kinesthetic Teaching)引导机器人末端,并在移除部署底盘的情况下推动一个低阻力平台完成双臂操作。针对紧密人机耦合带来的示教与部署之间的差异,作者提出面向部署对齐的示教数据处理:对平台运动进行标定与时间对齐,使其匹配部署底盘的响应;并对观测中的示教者手部进行分割与修复。
与 Mobile ALOHA 和 VR 遥操作相比,HALO 的示教采集速度最高提升 2.9 倍,同时保持相当或更高的成功率。基于 HALO 数据训练的策略能够完成穿扎带这类精细操作任务,并在一个包含多次底盘–手臂协调运动的六阶段长程任务上达到 73.3% 的成功率。
1. 背景与动机
1.1 从桌面操作到全身移动操作
端到端策略与模仿学习(ACT、Diffusion Policy、OpenVLA、π0 等)已在大量真实操作任务上取得显著进展,但绝大多数工作仍局限于固定工作空间的桌面场景。真实应用则要求机器人在操作的同时通过移动扩展工作空间,即协调的全身双臂操作。学习这类行为的前提,是能够高效采集同时包含底盘运动与双臂操作的示教数据。
1.2 现有采集范式的取舍
现有的全身数据采集方法大致可分为三类,它们在保留人的自然协调能力方面各有取舍:
间接遥操作(如 VR 接口):通过手柄或空间设备间接控制机器人,缺乏直接的操作控制与力反馈。
主从臂系统(如 Mobile ALOHA):主从臂提供了更直接的操作方式,但操作者的双手、视点与机器人末端在空间上相互分离,形成感知鸿沟;同时动力底盘占据了操作者的活动空间,形成移动鸿沟。
基于重定向的方法(如 UMI、HoMMI):保留不受约束的人体运动,再通过重定向或全身控制器映射为机器人动作;但底盘运动难以精确控制,视觉与控制上的本体差异依然存在。
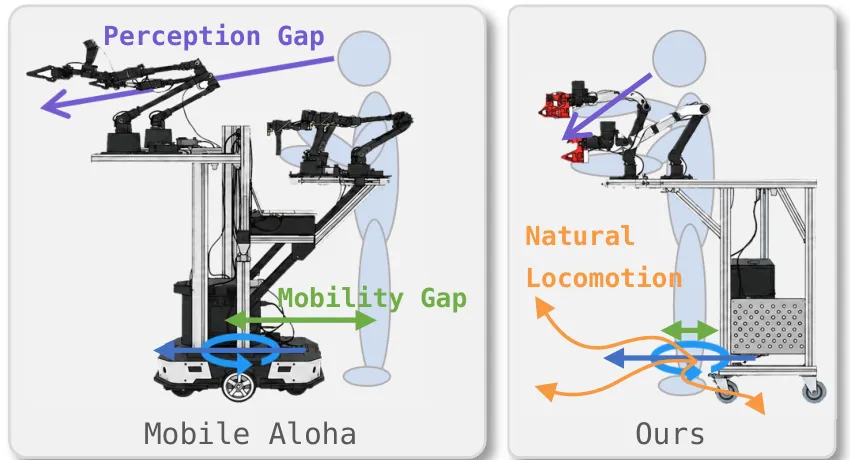
图 1:接口对比。Mobile ALOHA 同时存在感知鸿沟与移动鸿沟;HALO 对齐了人与机器人的感知,并保留了操作者的自然运动。
下表从全身移动操作数据采集所需的几项关键性质出发,对代表性接口进行定性比较:
| 方法 | 支持移动 | 第一视角感知 | 力反馈 | 自然移动 | 无需重定向 | 底盘精确控制 |
|---|---|---|---|---|---|---|
| GELLO | ✗ | ✗ | ✗ | ✗ | ✓ | ✗ |
| Mobile ALOHA | ✓ | ✗ | ✗ | ✗ | ✓ | ✓ |
| VR | ✓ | ✗ | ✗ | ✗ | ✓ | ✓ |
| 外骨骼 | ✓ | ✓ | ✓ | ✓ | ✗ | ✗ |
| UMI / HoMMI | ✓ | ✓ | ✓ | ✓ | ✗ | ✗ |
| HALO | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
表 1:数据采集系统的定性比较。
可以看到,以机器人本体为中心的接口(Mobile ALOHA、VR)能提供无需重定向的动作和精确的底盘控制,但牺牲了操作者的感知与移动自由;以人体为中心的接口(UMI/HoMMI、外骨骼)则恰好相反。HALO 的目标是在同一个系统中同时满足这两组性质。
1.3 设计原则
作者认为,有效的全身示教需要在保留机器人原生动作约束和直接物理反馈的同时,对齐操作者的感知–动作空间,并保留操作者的自然移动能力。据此,HALO 遵循两条设计原则:
操作接口应保留直接的机器人控制与反馈。 作者保留机械臂并采用直接示教,让操作者贴近末端执行器,以缩小感知鸿沟,同时保留直接的视觉与力反馈。
移动接口应保留操作者的自然移动,而不要求其显式控制底盘。 作者在采集时移除移动底盘,以缩小移动鸿沟,让操作者通过自然的身体移动完成重新定位。
这一设计可以看作对 UMI 思路的选择性应用:UMI 把整个机器人本体从采集系统中移除,代价是需要重定向;HALO 只移除对人体运动约束最大的底盘,而保留能够直接给出真实关节动作和力反馈的机械臂。
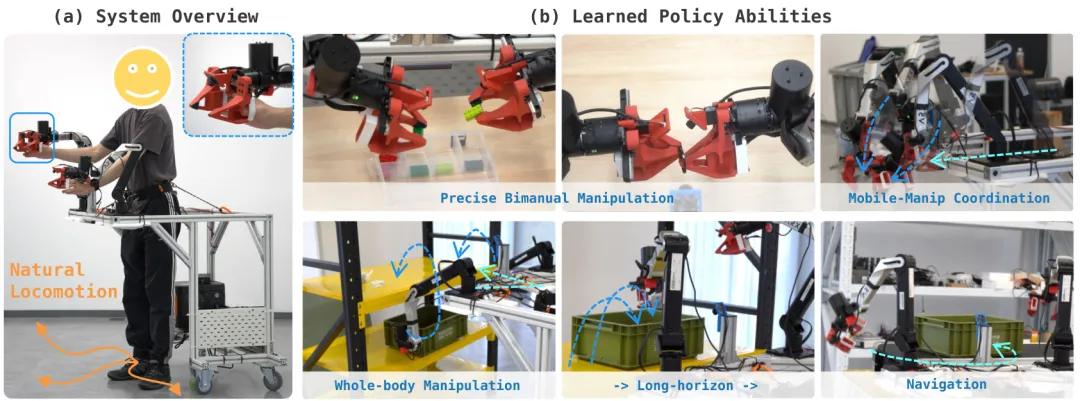
图 2:(a) HALO 的采集形态:自然行走与直接的双臂示教;(b) 学到的策略具备精细操作、全身协调控制、长程移动操作与导航能力。
2. 方法
HALO 由三部分组成:操作接口(2.1 节)、移动接口(2.2 节),以及用于消除人机耦合与无底盘采集所致差异的示教数据处理(2.3 节)。最后介绍策略学习与异步执行(2.4 节)。
2.1 操作接口
采集接口应当适应操作者,而不是要求操作者去适应机器人。ALOHA 的主从臂设计虽然提供了直观的双臂控制,但操作者的双手与从臂末端在空间上分离,第一人称视角也与机器人视角不同,削弱了感知与动作的对齐。因此 HALO 采用直接示教。
然而,ALOHA 原有的末端执行器并不是为这种物理交互而设计的:手柄限制了靠近桌面时的工作空间,剪刀式机构也不利于施加较大的力,使得在紧凑或接触密集的任务中难以稳定抓取和施力。作者为直接示教重新设计了末端:去掉手柄与剪刀机构,改用紧凑、高接触面积的结构。新设计使末端尺寸缩小一半以上(242 mm → 105 mm),可用俯仰角增加约 40°,在保留直接视觉与力反馈的同时,支持更贴近、更灵活的操作。
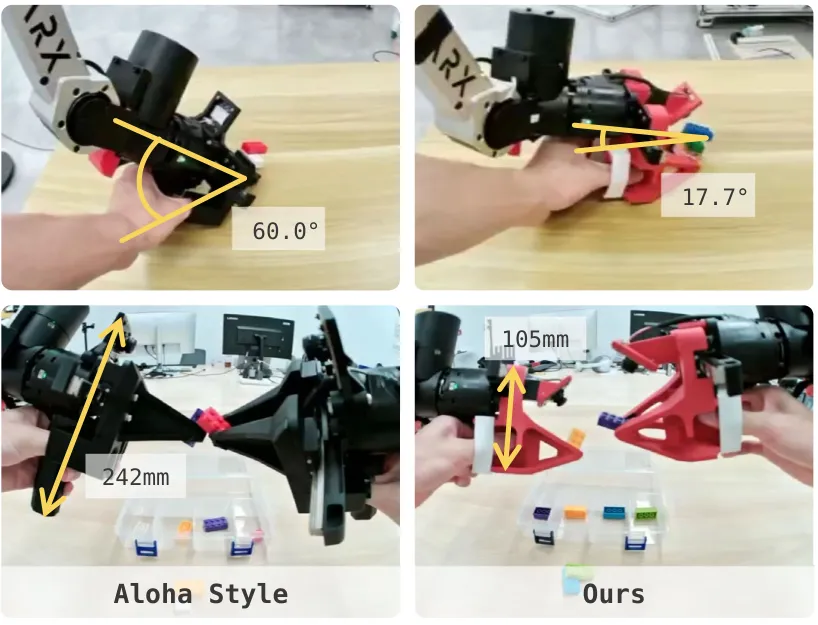
图 3:末端执行器重设计。与 ALOHA 末端相比,新设计增大了手部接触面积,实现紧凑而稳定的物理控制。
在开源版本中,末端采用模块化设计:电机、手指安装座与可更换手指相互解耦,手指形状可以针对不同任务调整,而驱动与安装结构保持不变。
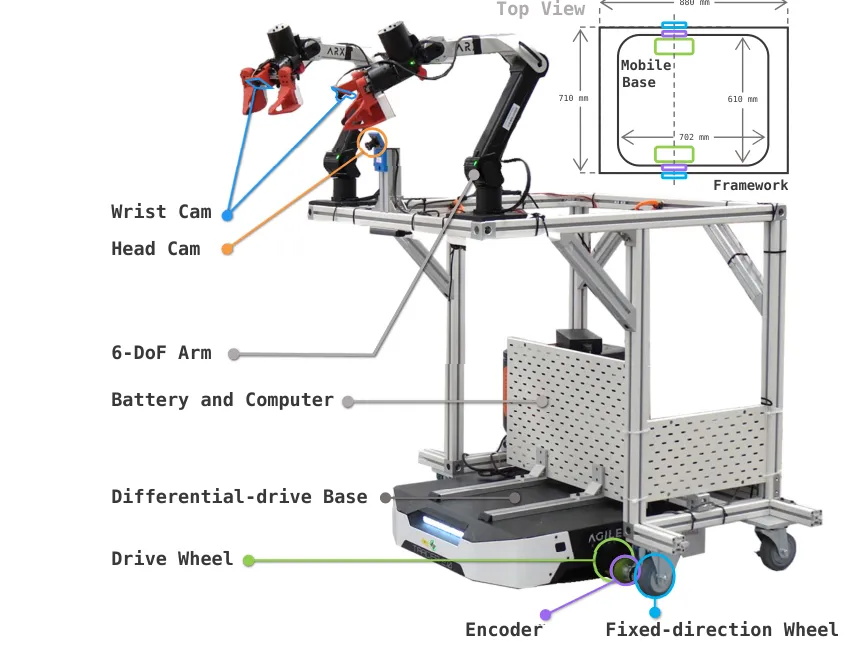
图 4:模块化末端执行器。左:装配图;右:爆炸图。
紧密的人机耦合让双臂示教更加自然,但也导致操作者的手出现在机器人的观测画面中。这一视觉差异将在 2.3 节处理。
2.2 移动接口
移动接口的目标是在保留操作者自然移动的同时,维持部署底盘的运动约束。Mobile ALOHA 的动力底盘会占据操作者的活动空间;HALO 在采集时移除底盘,让人体运动直接带动一个低阻力的示教平台,使操作者能够隐式地控制移动,把注意力集中在双臂操作上。
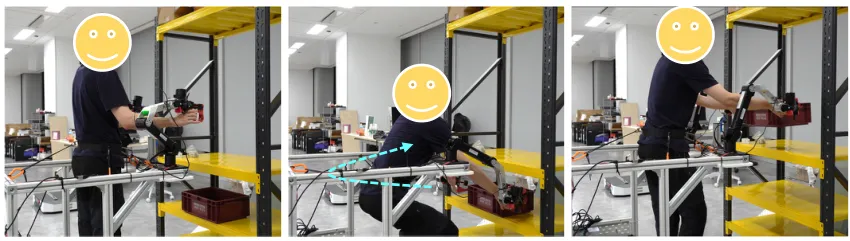
图 5:隐式底盘控制。低阻力采集平台使底盘运动自然地来自操作者的移动,无需会干扰手部操作的显式底盘控制。
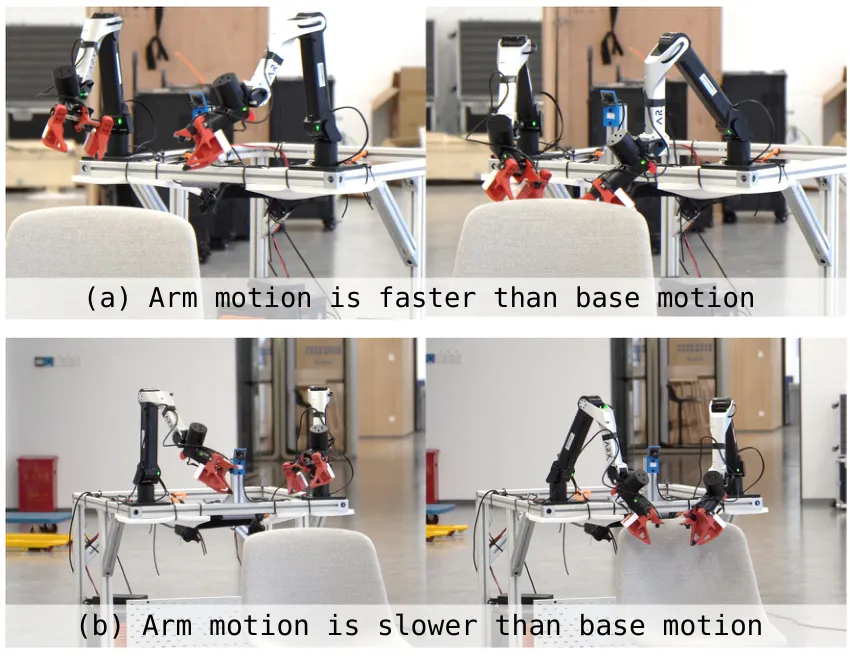
图 6:HALO 部署系统,包括双臂操作单元、机载相机、差速底盘、编码器与计算单元。采集时底盘被移除。
运动学兼容。 部署系统使用 AgileX Tracer AGV 2 差速底盘;采集平台使用被动轮,并在驱动轮轴线上布置两只定向轮。这一配置在机械上把采集平台约束到与部署底盘相同的非完整运动空间,从而无需事后重定向即可保证运动学兼容。与 HoMMI 等通过优化求解底盘运动的方法相比,这里的约束由硬件结构直接施加。
移动阻力。 移除动力底盘显著降低了推动所需的力:
| 平台 | 所需水平推力 |
|---|---|
| 完整部署系统 | 47.3 N |
| Mobile ALOHA | 13.0 N |
| HALO 采集平台 | 2.3 N |
里程计。 驱动轮轴附近安装的两个编码器测量采集平台的运动。Mobile ALOHA 需要改装 DYNAMIXEL 电机并使用 3D 打印件;HALO 则直接采用现成的工业测量轮组件(欧姆龙旋转编码器、测量轮与弹簧预紧机构),无需定制加工。所用编码器为每转 300 脉冲,也有更高分辨率的型号可选。
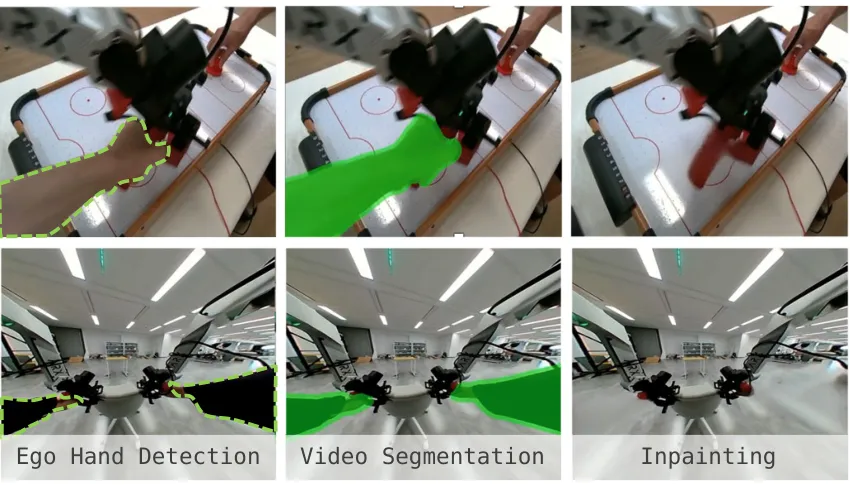
图 7:用于轮式里程计的工业测量轮组件。
由于采集平台是被动的,它的动力学与部署底盘不同,测得的运动不能直接用作部署时的动作。平台运动到底盘速度的映射以及部署底盘的响应延迟,将在 2.3.2 节标定。
2.3 面向部署对齐的示教数据处理
紧密的人机交互和无底盘的采集平台让示教更加自然,但也在示教与部署之间引入了视觉和控制两方面的分布偏移。
2.3.1 视觉处理
直接示教时操作者的手在画面中可见,而自主执行时并不存在。为了缩小这一视觉差异,作者对示教视频依次进行手部分割、时序掩码传播和视频修复:
将视频划分为相互重叠的时间片段,并在片段内采样关键帧;
用 CaRE-Ego 在关键帧上预测左右手掩码,作为 SAM2 的提示;
在每个片段内,先从最后一个有效检测的关键帧沿时间反向传播掩码,再从第一个有效关键帧沿时间正向传播,覆盖检测前后的帧;
在相邻片段的重叠区域融合掩码概率以平滑边界,并去除小连通域、填补空洞、膨胀掩码以覆盖残留的手部边缘;
用 DiffuEraser 结合光流引导的可见内容传播和扩散模型修复,重建被遮挡区域,最后与原始帧融合。
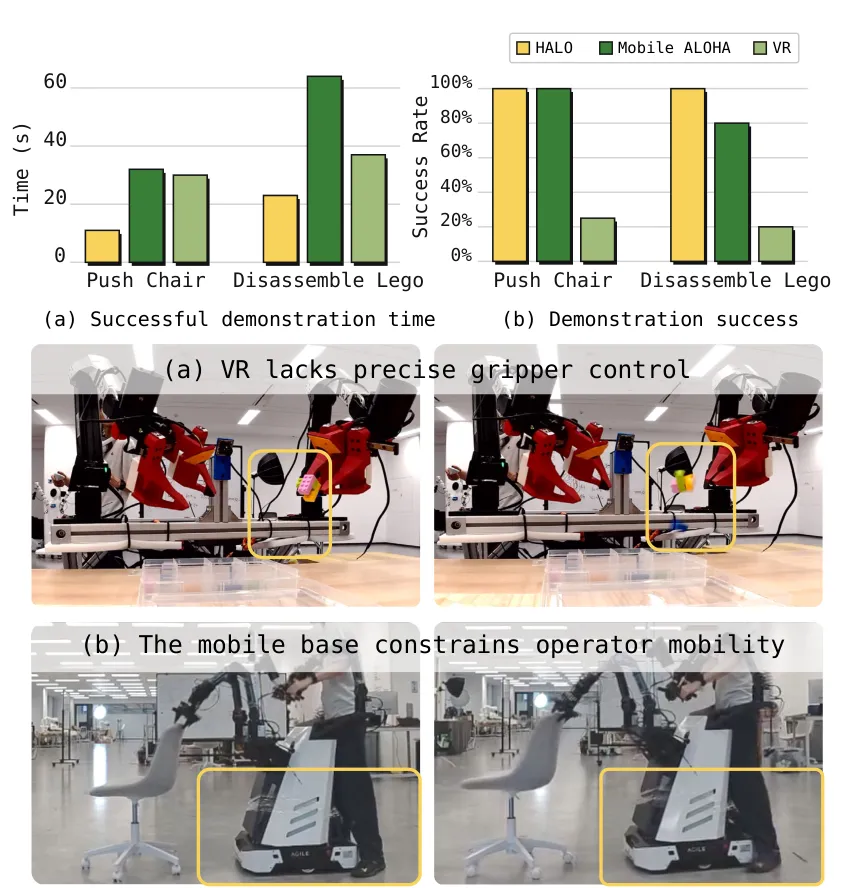
图 8:视觉处理流程:手部检测 → 视频分割 → 修复。在快速运动、双手操作和第一人称交互下均能去除操作者的手部。
与 DexUMI、Ego2Robot、EgoBridge 等从人到机器人的迁移方法相比,一个重要区别在于:直接示教本身就提供了真实的机器人动作,因此只需消除视觉与控制中由示教者带来的伪影,而不需要额外的动作标注或回放。
2.3.2 底盘运动对齐
运动学约束已由采集接口匹配,剩下需要对齐的是被动平台与动力底盘在动力学与控制响应上的差异。编码器读数被转换为平台左右轮速度 。作者标定部署底盘从指令速度到编码器观测运动的响应,估计相应的动作–状态延迟并据此做时间对齐;忽略这一延迟,会在指令动作与实际底盘运动之间造成系统性错位(图 9)。
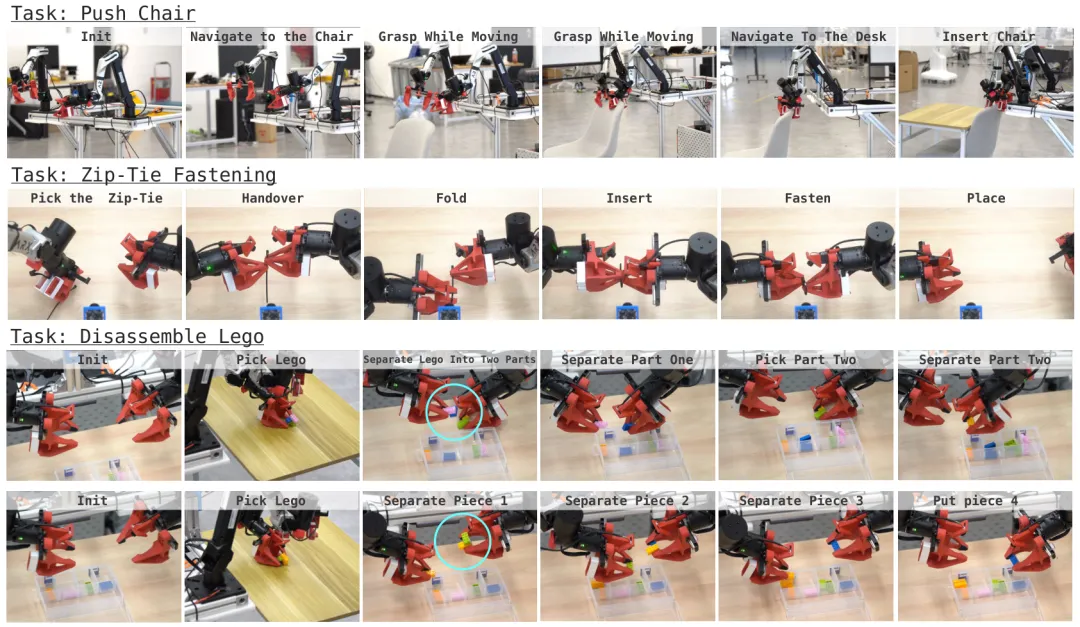
图 9:高移动性任务中的失败案例。(a) 未补偿底盘延迟时,手臂运动快于底盘运动;(b) 同步推理带来额外控制延迟,导致底盘行驶超出预期。
进一步,作者拟合一个从平台测量运动到部署底盘速度的仿射映射:
其中 为部署底盘的线速度与角速度,系数与偏置由在部署系统上成对采集的平台测量值与指令速度估计得到。为了避免对估计运动积分造成误差累积,作者用底盘速度而不是位姿作为动作表示。
2.4 策略学习
为了评估 HALO 示教数据的有效性,作者以预训练的 π0.5 视觉-语言-动作(VLA)模型作为基础策略,在示教数据上进行全参数微调。
观测:1 路头部相机和 2 路腕部相机图像,以及机器人关节位置与底盘线速度、角速度;
动作:左臂关节目标与夹爪指令、右臂对应指令、底盘线速度与角速度,直接拼接为 16 维向量;
训练:AdamW 优化器,学习率 5×10⁻⁵(100 步预热),批大小 128,训练 5k 步,动作预测长度 25;不使用预训练初始化的模型采用相同设置训练 10k 步。
作者发现,只需把底盘动作和手臂动作直接拼接,就能获得较强的全身协调控制,无需额外的架构设计。这与用规划器或全身控制器分别协调底盘与手臂的分层方法形成对比:当移动与操作需要同时演化时,统一建模耦合的底盘–手臂动作更为有效。
异步执行。 紧密的全身协调要求连续执行和频繁重规划。作者采用异步的实时动作分块(RTC):在执行当前动作块的同时预测下一个动作块。给定最新观测 和已提交的动作前缀 ,策略预测:
其中 为以控制步计的推理延迟, 为预测长度。以已提交的前缀为条件,保证了相邻动作块之间的连续性。训练时随机选取 0–9 个初始动作作为干净前缀,这部分不计入流匹配损失。
3. 实验
作者从三个方面评估 HALO:
采集效率:与现有遥操作接口相比,能否更高效地采集成功的全身示教?
灵巧性:采集的示教能否把人的操作灵巧性迁移到学到的策略中,尤其是精细的双臂操作?
全身协调控制:学到的策略能否协调底盘运动与操作,尤其是在需要精确重新定位和长程执行的任务中?
所有任务的完整采集过程(含场景复位与物体准备)都限制在 1 小时以内,且不对示教多样性加任何约束(如固定初始底盘位姿或物体摆放)。操作者被要求按自然节奏采集,在移动操作中自然行走。
3.1 采集效率
作者在需要移动与双臂操作紧密配合的任务上,将 HALO 与 VR 遥操作和 Mobile ALOHA 进行比较。为保证公平,所有方法由同一名操作者在相同的任务设置、时间预算和复位流程下评估,且该操作者此前没有使用过任何一种被评估的接口。
推椅子:操作者以约 0.7 m/s 的正常步行速度移动,同时用双夹爪抓住椅背,然后导航并把椅子推进桌下。任务要求在快速底盘运动中保持稳定的双臂抓取。
拆乐高:拆开一个由四块组成的乐高结构,并把每块放进对应颜色的格子。乐高构型和物体摆放均随机。
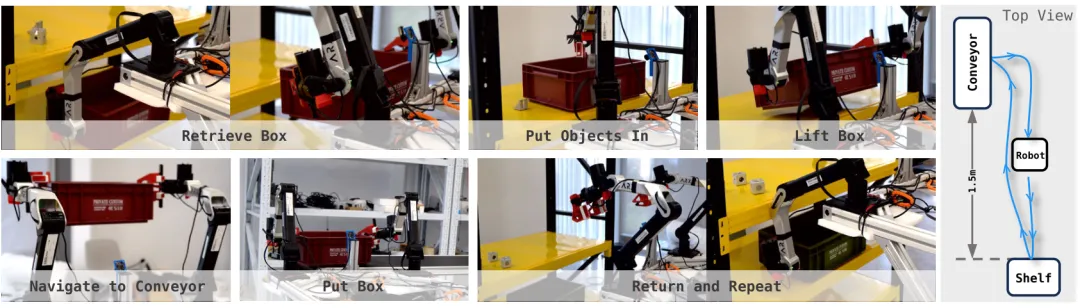
图 10:上:成功示教的平均时长与采集成功率。下:现有接口的典型局限——VR 缺乏精确的夹爪控制与力反馈;移动底盘限制了操作者的活动。
结果。 HALO 的示教成功率与基线持平或更高,同时把成功示教的平均时长最多缩短 66%。与 Mobile ALOHA 相比,HALO 在推椅子和拆乐高上分别提速 2.9 倍和 2.8 倍,后者的成功率还高出 20 个百分点。两种基线的困难各不相同:VR 的感知鸿沟妨碍了精确的夹爪控制;Mobile ALOHA 的物理底盘限制了操作者的移动——在推椅子任务中,操作者不得不在抓取前停下,尽管成功率较高,示教时长却明显增加。
3.2 灵巧性
穿扎带任务需要一系列精细的双臂操作:拾取、交接、折弯、插入、拉紧和放置。策略需要在整个过程中操作一根又短又小的扎带,要求达到亚毫米级的操作精度。
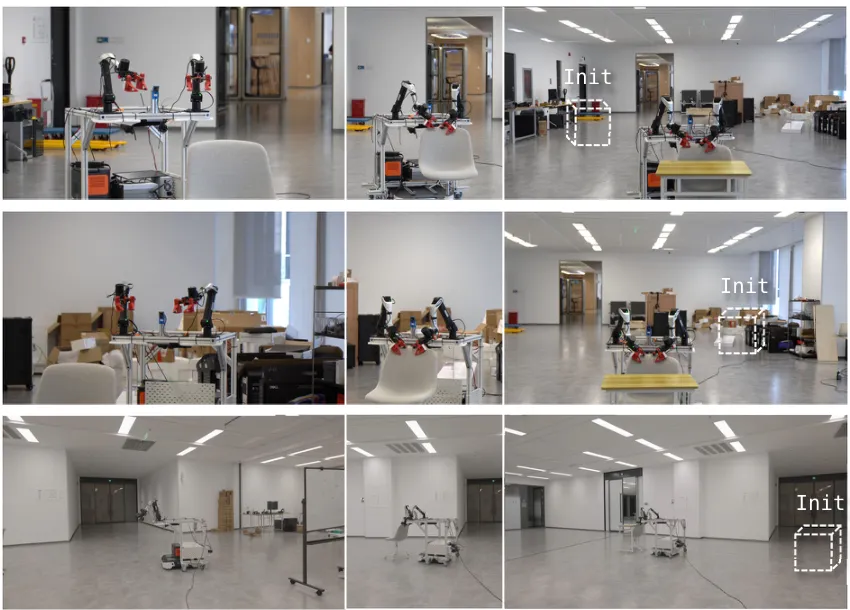
图 11:推椅子、穿扎带与拆乐高。推椅子任务中,策略导航到椅子旁、在移动中抓取、运送到目标桌前并推入。拆乐高任务中,随机的拆分方式改变了所需的拆解策略;第三行包含两块同色积木,策略把拆开的两块都放进了正确的格子。
| 穿扎带 | HALO | Mobile ALOHA | VR |
|---|---|---|---|
| 成功率 | 30.0% | 0.0% | 0.0% |
| 平均用时(秒) | 41 | – | – |
表 2:灵巧性评估(10 次试验)。
基于 HALO 数据训练的策略成功复现了穿扎带所需的精细操作。相比之下,Mobile ALOHA 受感知鸿沟影响,操作者离扎带太远,看不清操作细节;VR 遥操作则无法可靠提供折弯和拉紧扎带所需的控制精度与灵巧性。这两种接口的示教成功率都很低、数据质量较差,学到的策略也就无法完成任务。
3.3 全身协调控制
拆乐高:策略需要相对工作台精确定位底盘,并协调两个末端完成小型互锁积木的抓取、分离和放置;不同的连接紧度要求双臂在力和运动上协调配合。成功率为 30/40(75.0%)。
长程任务(六个阶段):从货架取箱 → 把目标物体放进箱中 → 双臂抬起装好的箱子 → 导航到传送带 → 把箱子放到指定位置 → 返回货架并重复。成功率为 11/15(73.3%)。尽管任务中包含多次前进、后退和旋转,策略始终能把底盘带回初始位置,使整个流程可以可靠地重复执行。
图 12:需要全身协调控制的长程移动操作任务。
在相同的采集时间预算下,基于 VR 和 Mobile ALOHA 数据训练的策略在这两个任务上都失败了,原因在于示教速度慢、停顿频繁,加上采集失败率高导致有效数据不足。
3.4 消融实验
推理策略。 由于全身协调对推理停顿非常敏感,作者研究了 RTC 相关的执行设计:
| 推椅子 | 同步(H=8) | 同步(H=25) | 异步(H=4) | 异步(H=6) | 异步(H=8) | 异步(H=10) |
|---|---|---|---|---|---|---|
| 成功率 | 0.0% | 35.0% | 75.0% | 75.0% | 85.0% | 70.0% |
表 3:同步与异步推理在不同执行长度 H 下的成功率。
同步执行时推理停顿无法完全消除,执行长度越长成功率反而越高——频繁重规划会带来更多停顿,破坏手臂与底盘之间的协调。异步执行缓解了推理延迟的影响,整体成功率更高。但重规划并非越频繁越好:过于频繁会降低动作块之间的时间一致性,过长的执行长度又会降低对新观测的响应。响应性与时间一致性之间存在权衡,中等的重规划间隔效果最好。
视觉后处理。 在推椅子任务上,用最佳推理设置(异步,H=8)比较有无 2.3.1 节视觉处理训练出的策略:去除手部后成功率从 55% 提升到 85%(+30 个百分点),验证了视觉对齐处理的有效性。
动作表示。 在拆乐高任务上比较末端位姿空间(EEF)与关节空间两种动作表示。EEF 动作由记录的关节动作经 ARX-X5 官方 URDF 正运动学计算得到,执行时再用 Mink 求逆运动学转回关节指令。
| 从 VLM 初始化(PaliGemma) | 预训练 π0.5 | |
|---|---|---|
| 末端位姿空间 | 12.5% | 47.5% |
| 关节空间 | 7.5% | 75.0% |
表 4:不同动作空间与基础模型下的成功率。
从零训练时末端位姿空间表现更好,而基于预训练 π0.5 时关节空间动作的成功率更高。这说明预训练使策略能够更好地利用直接的关节空间控制。值得注意的是,直接示教采集到的恰好是原生关节空间动作,不需要任何逆运动学转换。
泛化性。 虽然采集时目标桌子的位置是固定的,学到的 VLA 策略仍能把推椅子任务泛化到未见过的背景和差异很大的椅子–桌子布局。相比 Mobile ALOHA 中 5–10 cm 的初始位置扰动,作者把随机化范围扩大到了 2–3 m。
图 13:在大范围初始位姿变化和未见环境下评估推椅子任务。
作者认为这种泛化能力部分来自基于速度的底盘控制:它鼓励策略学到一种持续把椅子推向桌子的反应式运动模式,而不是记住某个固定的全局位姿。
4. 讨论
结合实验结果,以下几点值得进一步讨论:
示教的时间结构会传递到策略中。 在相同时间预算下,基线方法的失败不仅源于有效数据不足,也源于示教本身"慢且频繁停顿"。推理策略的消融从另一个侧面印证了这一点:执行中的停顿会直接破坏底盘与手臂的协调。对全身移动操作来说,采集接口能否支持连续、流畅的协调运动,与示教数量同样重要。
把约束放进硬件,而不是放进求解。 HALO 通过定向轮的布置在机械上复现了差速底盘的非完整约束,使采集到的底盘运动天然可执行;剩余的动力学差异只需一个低维仿射映射加延迟标定即可补偿。这与通过全身逆运动学或优化事后求解底盘轨迹的路线形成对照,后者难以保证底盘位置的精确性。
无需重定向简化了从人到机器人的迁移。 由于动作直接在真实机器人的关节空间中记录,HALO 的本体差异被压缩到了视觉层面(画面中可见操作者的手),而这部分可以用现成的分割与修复模型处理。同时,原生关节空间动作与预训练 VLA 的结合取得了最好的效果。
局限性。 HALO 保留了机械臂,因此依赖真实机器人硬件,不具备 UMI 类方法那种在任意场景采集的可扩展性;手部去除效果依赖分割与修复模型的质量;机器人头部相机视角固定,而人在操作中会主动调整视线。未来可以引入主动感知,让机器人在操作过程中自适应地调整视角,更接近人的视觉行为。
5. 结论
该论文提出了 HALO,一个面向全身移动操作、与人对齐的数据采集系统。其核心观点是:机器人接口应当适应人的能力——对齐感知与操作,同时保留自然的移动。这一设计实现了协调示教的高效采集;面向部署的数据处理则缓解了紧密人机耦合带来的视觉与控制偏移。在快速移动操作、灵巧操作和长程任务上的实验表明,与人对齐的接口可以为高效的数据采集和鲁棒的全身策略学习提供有效基础。
📄 论文:
🌐 项目主页:
来源:human five