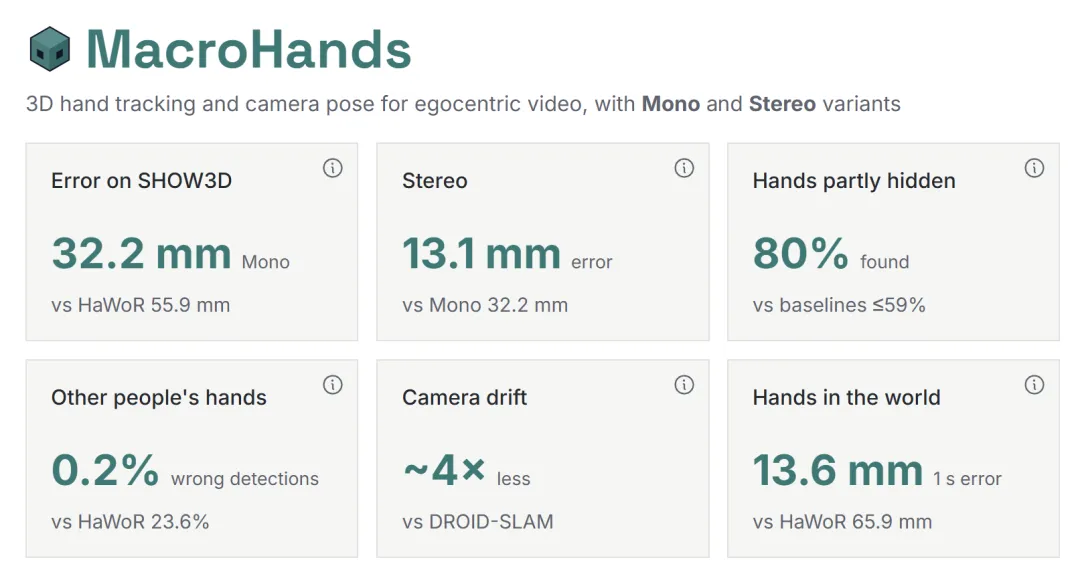
MacroHands 是我们面向第一视角视频开发的 3D 手部追踪与相机位姿模型,包含单目和双目版本。在我们的测试中,它们优于所有开源基线。
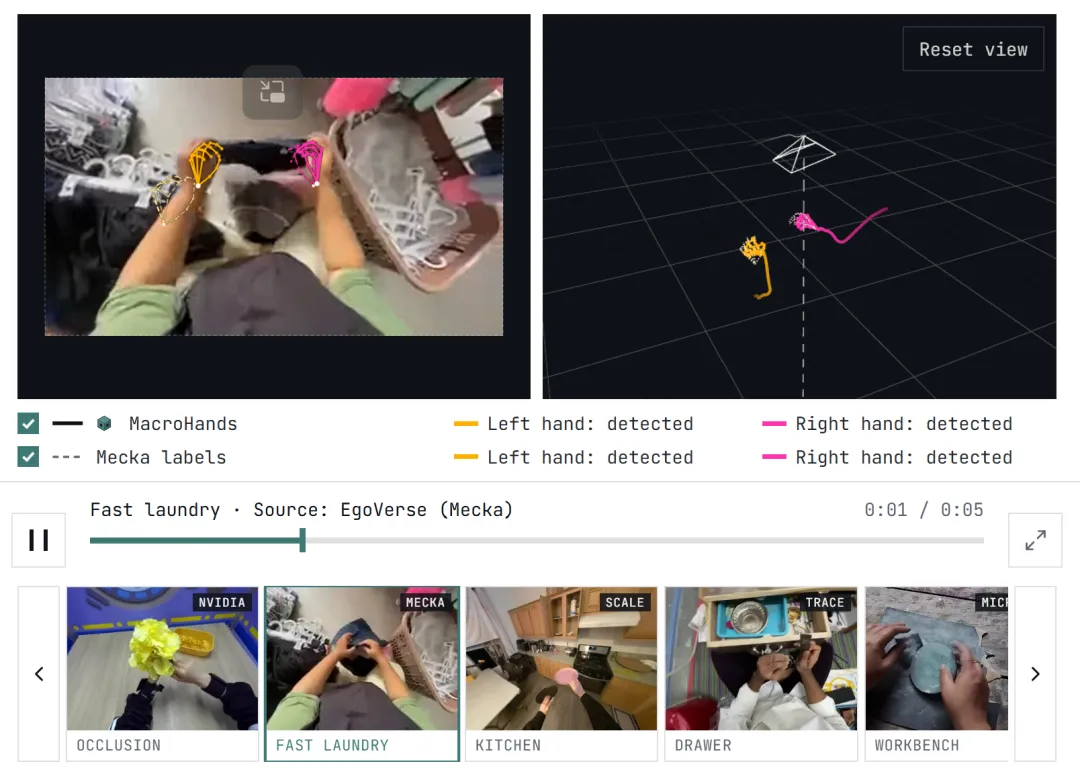
MacroHands 在第一视角视频中进行 3D 手部追踪:
遮挡:手部移动一束花,部分被花瓣遮挡。来源:NVIDIA。
快速整理衣物:整理衣物时手部快速移动。来源:Mecka。
厨房:佩戴者在厨房中走动,右侧视图跟随相机的运动路径。来源:Scale。
抽屉:佩戴者整理抽屉。来源:Trace。
工作台:一个工作台场景。来源:MicroAGI。
花枝:佩戴者整理花枝。来源:NVIDIA。
花束:佩戴者拿着一束花。来源:NVIDIA。
盒装鲜花:佩戴者将黄色鲜花放入盒中。来源:NVIDIA。
桌面鲜花:佩戴者将紫色鲜花放在桌上。来源:NVIDIA。
其他人:其他参与者伸手越过桌面,移动桌面上的棋子。
镜子:佩戴者在镜子前清洁水槽。
脚:佩戴者为一位客户修磨脚趾甲,脚出现在画面中。
手套:佩戴者戴上白色工作手套并往手推车上装物品。
快速运动:用刷子快速来回擦洗,手部出现运动模糊。
攀岩:佩戴者攀岩时伸手抓握支点,头部运动迅速。
户外:佩戴者在阳台的晾衣绳上晾晒衣物。
精细点按:在手机上滚动和滑动时,拇指做小幅运动。
手指点按:手指在桌面上点按,动作幅度小、速度快。
厨房台面:佩戴者擦拭厨房台面。
床头柜:佩戴者擦拭床头柜。
架子:佩戴者整理架子,视频为竖屏拍摄。
鞋:佩戴者一只手拿着鞋,另一只手将其擦干净。
MacroHands 在真实第一视角视频中进行 3D 手部追踪。手部移动一束花,部分被花瓣遮挡。
核心内容
我们推出 MacroHands:面向第一视角视频的 3D 手部与相机路径估计模型系列,包含单目(Mono)和双目(Stereo)版本,性能达到当前最先进水平。
MacroHands-Mono 优于我们测试过的所有开源基线,包括所有双目基线。在 SHOW3D 上,MacroHands-Mono 的误差为 ,HaWoR 为 ,表现最好的双目基线为 。
MacroHands-Stereo 在 Mono 的基础上进一步提升,误差降低至约 :在 SHOW3D 上从 降至 ,提升主要来自更准确的深度估计。
MacroHands 能处理部分遮挡,甚至短暂的完全遮挡。在手部经常被部分遮挡的视频片段中,它仍能检测出 的手部,而基线方法最高为 。
MacroHands 能区分佩戴者和其他人的手:它将其他人的手误检为佩戴者手部的比例为 ,HaWoR 约为 。它也适用于佩戴手套的视频,以及其他大多数模型表现不佳的常见真实场景。
我们的相机位姿估计同样达到当前最先进水平;有 IMU 数据时表现进一步提升。在 Monado 和 Aria Gen 2 上,其漂移约为 DROID-SLAM 的四分之一。
第一视角视频的兴起
规模更大、能力更强的机器人模型不断涌现,训练所用的数据量也越来越大。在上一篇博客中,我们深入讨论了第一视角数据:使用简单的头戴式相机,就能以比机器人遥操作更低的成本、更高的可扩展性获取训练数据。
此后,第一视角数据受到的关注持续增长。NVIDIA 今年早些时候发布的初步研究成果 EgoScale(Zheng 等人,2026),以及近期 Dyna 发布的 Dyna-2(Dyna Robotics,2026;在超过 100 万小时第一视角视频上完成预训练)都展示出了实际潜力,见图 2。在商业领域,多家公司宣布,销售这类数据的年化收入已达到较高水平。
例如,截至 2026 年 6 月,Mecka 的年化收入超过 1 亿美元;microagi 的 Shift 推出六个月后,年化收入达到 1 亿美元以上。
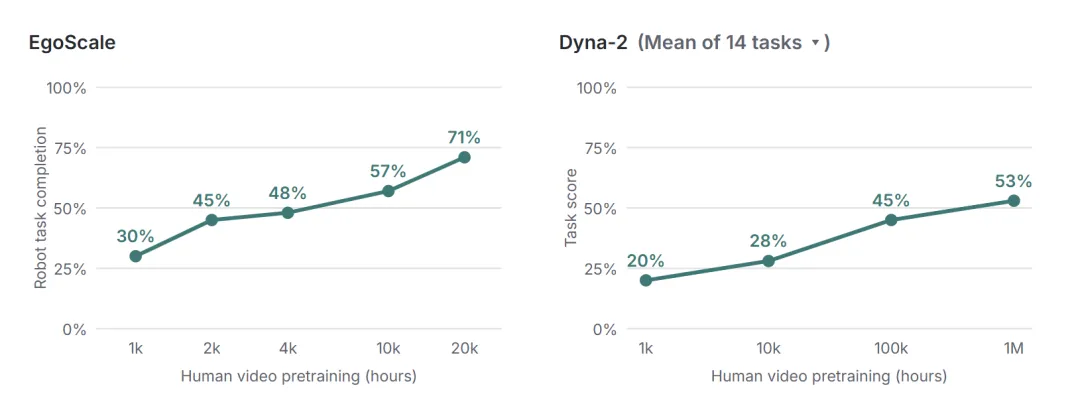
机器人性能与人类视频预训练时长的关系。左:EgoScale 的平均任务完成率(Zheng 等人,2026)。右:Dyna-2 在 14 项任务上的平均得分,也可以选择查看单项任务(Dyna Robotics,2026)。
但第一视角数据本身并不包含动作。在上一篇博客《Turning Egocentric Video into Robot Actions》中,我们讨论了研究者通常如何依靠手部追踪和动作重定向(Retargeting),将这类数据转化为可供训练的形式。我们还考察了现有的开源手部追踪方案,以及它们在真实第一视角视频中有多么不稳定。
Egocentric Video 转换成机器人动作:仅 RGB 输入的手部动作处理完整 Pipeline
动作是机器人策略在每一步输出的指令,例如手部或夹爪下一步应该移动到哪里。遥操作可以直接记录这些动作。第一视角视频只展示人如何完成任务,因此需要从视频中提取动作。Retargeting 则将追踪到的人手运动映射到机器人的手部或夹爪上。
遗憾的是,目前大多数 3D 手部追踪模型和处理 pipeline 仍然存在我们之前发现的那些问题:部分遮挡就可能导致视频无法使用;操作人员佩戴手套、在人员密集的环境中工作,甚至画面中出现赤脚时,手部估计都会变得不可靠——许多模型会把脚误认为手。总体而言,尽管一些供应商宣称能够达到“亚毫米精度”,现有估计结果,尤其是深度,即手部与相机之间的距离,仍远远不够准确。
过去几个月,我们一直在解决这个问题。今天,我们正式推出 MacroHands:面向第一视角视频的 3D 手部追踪与相机位姿模型系列。MacroHands 包含两个版本:Mono 适用于任意单个相机拍摄的视频;Stereo 使用双目设备的两个视角。
MacroHands
面向第一视角视频的 3D 手部追踪与相机位姿估计,包含 Mono 和 Stereo 两个版本。
SHOW3D 上的误差
在相机坐标系中,不进行对齐,计算每个预测手部关节与其真实 3D 位置之间的平均距离。SHOW3D 使用 Quest 3 采集,包含 32 人;参与比较的模型均未在该数据集上训练。这里的深度误差会使机器人学习的动作中的手部位置偏差达到数厘米。
MacroHands-Mono:
HaWoR:
双目版本
当 MacroHands 使用头戴设备的两个前置相机,而非其中一个时,在 SHOW3D 上采用相同指标得到的误差。几乎所有提升都来自深度估计,即手部与相机距离的估计;手部形状误差基本不变,PA-MPJPE 分别为 和 。
MacroHands-Stereo:
MacroHands-Mono:
手部部分遮挡
在手部经常被部分遮挡的视频片段中,例如被手持工具遮挡时,模型检测到佩戴者手部的比例。每漏掉一只手,都会在记录中留下一处空缺,从而减少可用于训练的视频量。
MacroHands:检测到
基线方法:不超过
其他人的手
在我们人工标注的第一视角视频 Benchmark 上,模型报告的手部检测结果中,落在画面内其他人手上的比例。如果追踪目标跳到另一个人身上,训练数据中就会出现佩戴者从未做过的动作。
MacroHands:错误检测比例为
HaWoR:错误检测比例为
相机漂移
使用双目视频和头戴设备的 IMU 时,在整段记录中估计的相机路径偏离真实路径的程度,以 ATE 衡量。在 Monado 上,两者分别为 和 ;在 Aria Gen 2 上分别为 和 。重建场景并将手部放入场景中,需要较低的漂移。
- 相比 DROID-SLAM,MacroHands 的漂移约低 倍。
世界坐标系中的手部
在 HOT3D 双目数据上,使用各方法各自估计的相机路径,将手部运动放入世界坐标系,不进行对齐,比较未来一秒的手部运动误差,即 Action MPJPE。一秒对应机器人策略所学习的动作块长度。
MacroHands:
HaWoR:
MacroHands 概览。所有数值均来自下文的 Benchmark。
MacroHands-Mono 优于我们测试过的所有开源基线,包括 SHOW3D 上的双目方法;Stereo 又将误差降低至约 。两个版本都能在遮挡期间持续追踪,并保持对佩戴者手部的追踪。它们还会估计相机位姿,即头戴式相机在每一帧中的位置和朝向,因此即使佩戴者移动,也可以将手部放入世界坐标系。
我们的相机位姿估计优于主流开源 SLAM(Simultaneous Localization and Mapping,同步定位与建图)系统;如果有 IMU(Inertial Measurement Unit,惯性测量单元,即大多数头戴设备和手机内置的加速度计与陀螺仪)数据,性能还会进一步提升。
3D 手部与相机位姿评测
解决此类问题的第一步,是建立具有准确真实值标注的 Benchmark。遗憾的是,对于 3D 手部位置和相机位姿,即使由人工操作,事后获取真实值标注也几乎不可能。人可以大致标出 2D 关键点,但判断 3D 深度极其困难。被遮挡的手部也是一大难题,相机运动估计同样如此。你可以在下面的互动示例 1 和互动示例 2 中尝试猜测,亲自体会这有多难。
因此,必须在录制视频的同时采集真实值。对于手部,相关数据集使用动作捕捉:ARCTIC(Fan 等人,2023)和 HOT3D(Banerjee 等人,2025)利用摄影棚相机系统追踪手上的小型标记点;SHOW3D(Rim 等人,2026)则使用与头戴设备同步的背包式外向相机阵列,无需标记点。
对于相机位姿,参考值来自设备自身的闭环追踪系统,如 Aria Gen 2(Meta Reality Labs Research,2025);或者来自外部追踪系统,如 Monado 中使用的 SteamVR Lighthouse(de Mayo 等人,2025)。这些方案都需要摄影棚或专用硬件,因此此类数据集屈指可数。
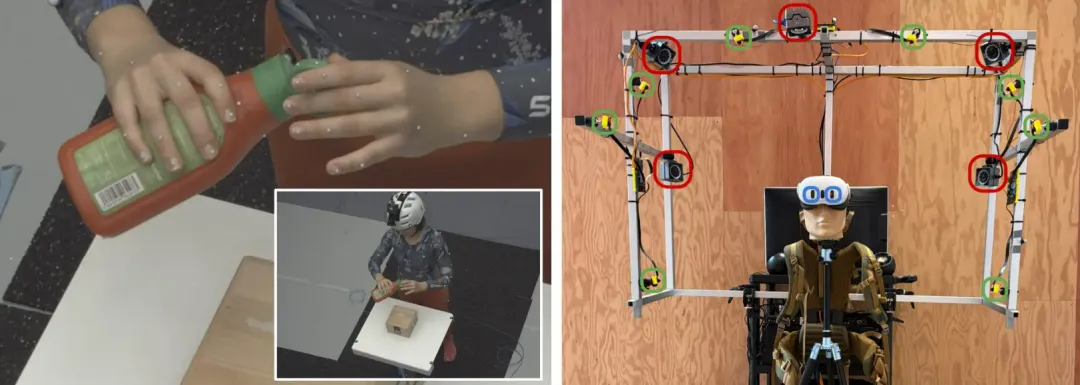
左:ARCTIC,手上贴有标记点(Fan 等人,2023)。右:SHOW3D 的背包式相机设备,手上无需标记点(Rim 等人,2026)。
评测 3D 手部
每只手由相机坐标系中的 21 个 3D 关键点表示:一个手腕关键点,以及每根手指上的四个关节关键点。
关于手部表示,以及如何将这些关键点转化为机器人动作的更多信息,请参阅我们之前的文章。
我们使用以下数据集作为 Benchmark:
| 数据集 | 设备 | 规模 |
|---|---|---|
| SHOW3D(Rim 等人,2026) | Quest 3 双目 | 93 个场景,32 人,0.89 小时 |
| HOT3D(Banerjee 等人,2025) | Quest 3 双目 | 6 段序列,6 人,0.21 小时 |
| ARCTIC s05(Fan 等人,2023) | 第一视角相机(单目) | 34 段记录,0.24 小时 |
3D 手部 Benchmark。我们主要使用 SHOW3D 进行评测,参与比较的模型均未在该数据集上训练。在 HOT3D 或 ARCTIC 上训练过的基线方法,在结果中用 * 标记。
我们重点关注两类指标:预测关节位置与真实关节位置之间的平均误差,即 MPJPE,单位为毫米;以及完整手部检测的召回率。大多数论文只报告将预测结果与真实值对齐后的 MPJPE:以手腕为基准对齐的 root-relative MPJPE,或进一步对旋转和尺度进行对齐的 PA-MPJPE。
我们仍然报告 PA-MPJPE,因为它可以单独衡量手部形状的质量。不过,我们的主要指标是完全不进行对齐时的误差,称为 Cam-MPJPE,因为真实视频没有可用于对齐的真实值。对齐还会掩盖最困难的部分——深度预测,见互动示例 1。
MPJPE:Mean Per-Joint Position Error,平均每关节位置误差,即预测关节与真实关节之间的平均距离。
PA:Procrustes Alignment,指在计算误差前,对预测结果施加最优旋转、平移和尺度变换,使其与真实值对齐。
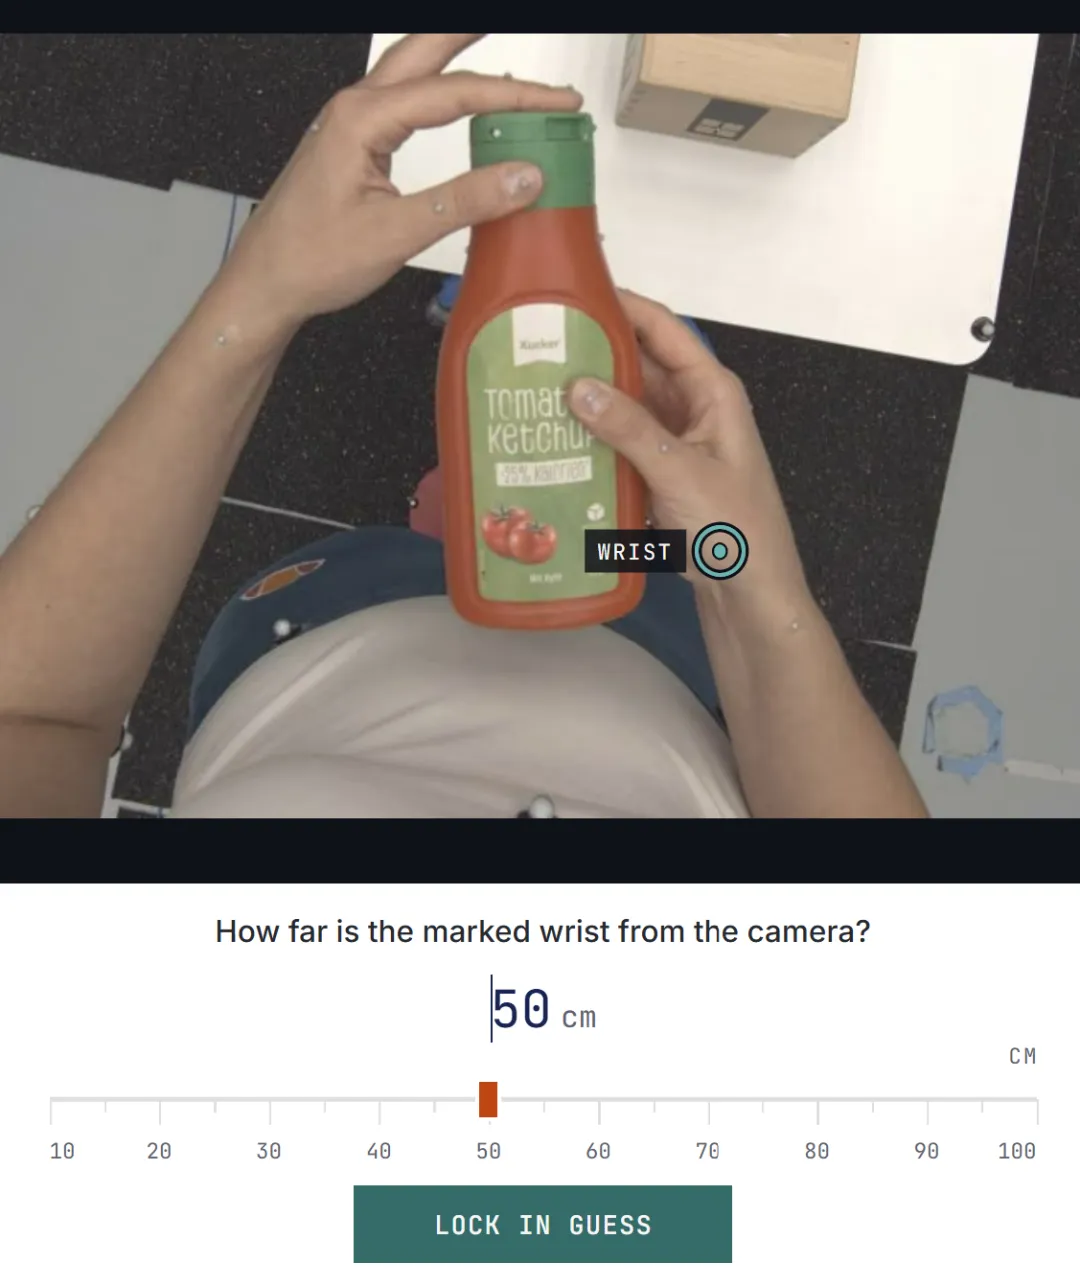
手腕有多远?画面和真实距离来自 ARCTIC、SHOW3D 和 HOT3D。
评测指标:
Cam-MPJPE(mm):在相机坐标系中,不进行对齐,计算预测关节与真实关节之间的平均距离。报告均值、中位数和第 90 百分位数。
召回率:模型检测到的真实手部所占比例。只有当模型正确判断左右手,并且预测关节投影到图像后形成的包围框(不添加 padding)与真实关节包围框的交并比满足 时,才算检测到该手。
PA-MPJPE(mm):将每只预测手部的旋转、平移和尺度与真实值对齐后的关节误差,因此只衡量手部形状。
Benchmark 补充细节
使用完整序列,帧率为 。SHOW3D 以 发布;为了与常见相机帧率保持一致,我们每隔一帧取样。
当一只手至少有 个关节位于主相机图像内时,才对该手进行评分;该手所有已标注的关节均计入评分,包括画面外的关节。这一规则只考察主相机,因此即使双目模型还能看到第二个相机的画面,其评分所用的手部样本也与单目模型完全相同。
真实值质量:不对未通过数据集自身质量检查(QA)的帧进行评分,包括 HOT3D 的
qa_pass检查和 ARCTIC 的有效性过滤。在 SHOW3D 中,如果公开的头戴设备位姿在某些帧上被冻结,即与前一帧完全重复,就会导致手部标注位置错误。我们剔除了此类帧占比超过 的场景,共 个;其余场景中另有 帧不参与评分。详见下文“完整采样与评分细节”。基线方法使用其公开代码和权重,并采用作者推荐的设置,不在这些 Benchmark 上重新训练或调参;它们获得的输入帧与 MacroHands 相同。
完整采样与评分细节
Benchmark 采样。所有列出的序列均完整使用,帧率为 。
| Benchmark | 序列 | 相机与图像 |
|---|---|---|
| HOT3D | 6 段具有公开真实值的 Quest 3 序列,每位参与者对应一段:P0002_45904c71、P0003_90feb35f、P0010_5edabbe9、P0013_b6ee6ae4、P0017_1a07e9e7、P0018_2188e5dc。帧率为 ,共 22,608 帧。 | Quest 3 前置追踪相机 1201-1 和 1201-2,分别进行鱼眼校正,转换为共享针孔相机模型下的正向图像,分辨率为 。左相机为评分相机。 |
| SHOW3D | 96 个场景,来自公开版本中具有手部位姿的全部 32 名参与者,每人 3 个场景。这些数据属于训练集,也是唯一公开了手部位姿的数据划分。对于每位参与者,按照 md5(scene_id) 的顺序选取场景,跳过已经选取过的活动类型,因此整个集合覆盖 96 种不同活动。由于公开数据中部分位置的头戴设备位姿被冻结,即与前一帧完全重复,导致手部标注位置错误,我们剔除了 3 个场景,另外还有 207 帧不参与评分。最终保留 93 个场景,共 95,857 帧;数据以 发布,评测时按 使用。被排除的场景和帧与序列列表一同公开。 | Quest 3 的 headset0 和 headset1,使用公开的去畸变竖屏图像,分辨率为 。headset0 为评分相机。 |
| ARCTIC s05 | 验证集参与者 s05 的全部 34 段记录。帧率为 ,共 25,917 帧。 | 第一视角相机 0,使用其标定参数进行去畸变,并调整至 。 |
真实值。
每只手包含 21 个关节:先是手腕,然后每根手指各 4 个关节。SHOW3D 标注了其中 20 个,不包含拇指根部关节。
当一个关节位于相机前方至少 处,并通过数据集自身的质量标记时,才视为已标注关节。具体要求如下:
HOT3D:通过
qa_pass和hand_pose_available检查;SHOW3D:标注置信度高于 ,且头戴设备位姿来自追踪,而非合成;
ARCTIC:帧位于 EgoForce 的手部存在列表中,并具有
visible_hand标记。
3D 手部评分。
所有预测结果和真实值均位于评分相机的坐标系中,单位为毫米。
左右手身份直接使用模型自身的标签,不进行重新匹配。
将所有输出手部中参与评分的关节误差汇总计算,不先按手或按序列分别求平均。未输出的手只会降低召回率。
PA-MPJPE 对每只预测手部使用最优相似变换,即尺度、旋转和平移,与真实值对齐;仅对至少有 4 个参与评分关节的手进行计算。
评测相机位姿
对于每一帧,我们还需要知道相机位姿:相机在固定世界坐标系中的旋转和平移,即从相机坐标系到世界坐标系的变换。通过这一变换,可以将每一帧中的手部放入同一个 3D 空间,从而区分手部运动和头部运动。
我们使用以下数据集作为 Benchmark:
| 数据集 | 设备 | 规模 |
|---|---|---|
| HOT3D(Banerjee 等人,2025) | Quest 3 双目,无 IMU | 6 段序列,0.21 小时 |
| Monado Index(de Mayo 等人,2025) | Valve Index 双目 + IMU | 11 段记录,0.99 小时 |
| Aria Gen 2 Pilot(Meta Reality Labs Research,2025) | Aria Gen 2 双目 + IMU | 12 段记录,1.10 小时 |
相机位姿 Benchmark。这些数据集中的所有记录均未用于训练我们的模型。
我们将预测的相机路径与参考路径进行比较。这里存在与手部评测相同的注意事项:SLAM 论文通常只在通过旋转、平移和尺度变换将预测路径拟合到参考路径后,才报告绝对轨迹误差(ATE),即整段记录中的相机位置误差。
我们的指标不进行尺度拟合,包括一次刚体对齐后的 ATE、1 秒 RPE 和尺度误差,因为对于单目相机而言,准确估计运动尺度是最困难的部分,见互动示例 2。
RPE:Relative Pose Error,相对位姿误差,指相机在短时间步长内自身运动的误差,此处时间步长为 1 秒,不进行对齐。
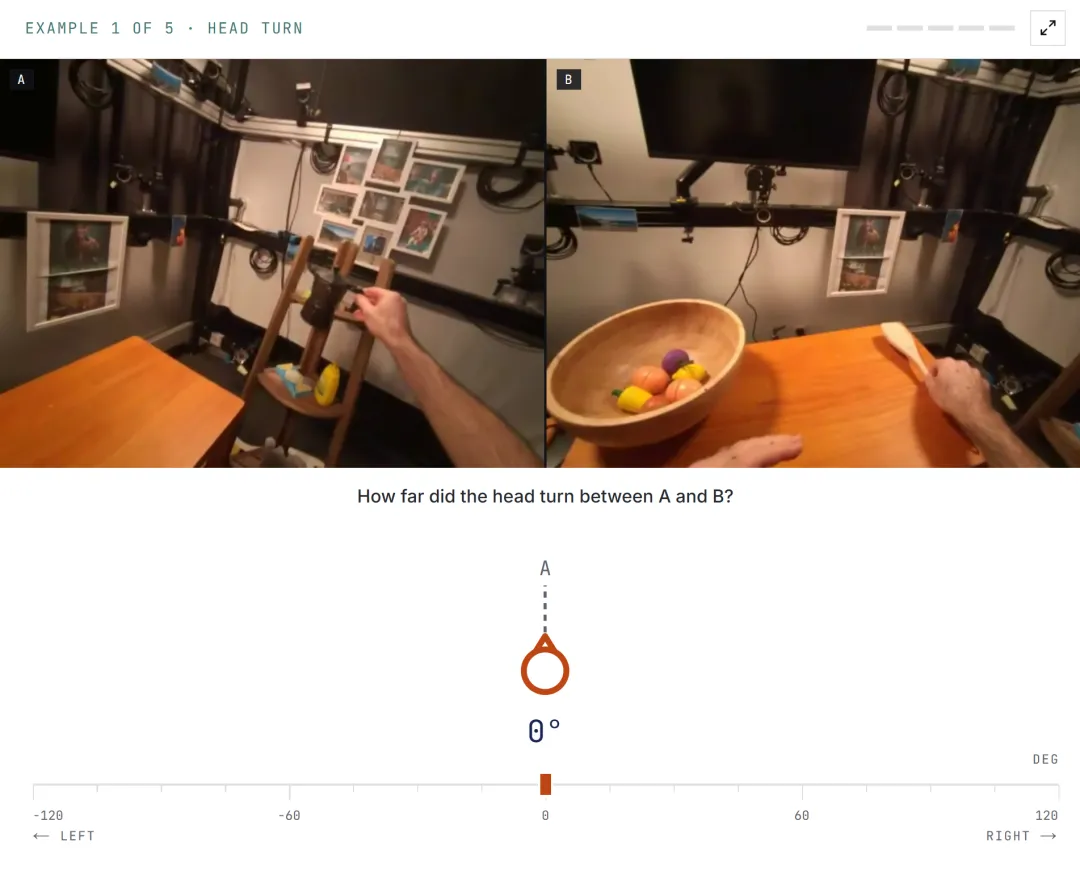
头部转动或移动了多少?真实运动由记录的头戴设备位姿给出。
评测指标:
RPE 1 s(cm / °):相机每个 1 秒时间步内的运动误差,包括平移和旋转,不进行对齐。
尺度误差(%):对于相机移动超过 的每个 1 秒时间步,用预测移动距离除以真实移动距离。尺度误差是这些比值的中位数偏离 1 的程度。例如,预测的相机运动距离比真实值长 或短 ,尺度误差均为 。
ATE(cm):整段记录中的相机位置误差,以均方根误差(RMSE)衡量。计算前,对整条路径进行一次刚体对齐,仅使用旋转和平移,不调整尺度;该指标通常称为 ATE-SE3。
Benchmark 补充细节
使用完整的视频记录,帧率最高为 ,与大多数第一视角视频的帧率一致:HOT3D 使用 ,Aria Gen 2 使用 ,均为各自的原始帧率;Monado 使用 ,即对其原始 视频每隔一帧取样。所有方法使用相同的帧。
基线方法使用其公开代码和权重,并采用作者推荐的设置,不在这些 Benchmark 上重新训练或调参;它们获得的输入帧和标定后的相机内参与 MacroHands 相同。
完整采样与评分细节
Benchmark 采样。
| Benchmark | 序列 | 相机与图像 |
|---|---|---|
| HOT3D | 6 段具有公开真实值的 Quest 3 序列,每位参与者对应一段:P0002_45904c71、P0003_90feb35f、P0010_5edabbe9、P0013_b6ee6ae4、P0017_1a07e9e7、P0018_2188e5dc。帧率为 ,共 22,608 帧。 | Quest 3 前置追踪相机 1201-1 和 1201-2,分别进行鱼眼校正,转换为共享针孔相机模型下的正向图像,分辨率为 。 |
| Monado Index | MIPT02、MIPT03、MIPP06、MIPP01、MIPB03、MIPB01、MIO13、MIO12、MIO01、MIO04、MIO02,包括 VR 游戏和大量手部活动的记录。排除了标定记录、时长不足 的记录,以及一段长达 37 分钟的记录。使用帧率为 ,即原始帧率 的一半。 | Valve Index 双目鱼眼相机,基线距离为 ,图像经过去畸变处理。真实值来自 SteamVR Lighthouse 追踪系统。 |
| Aria Gen 2 Pilot | walk_0、walk_1、clean_0、cook_0、eat_0–eat_3、play_0–play_3:具有闭环轨迹的完整记录。每种活动内部按时长从长到短排序,再从不同活动中轮流选取。帧率为 。 | Aria Gen 2 前置双目相机,图像经过校正。参考轨迹为 Aria MPS 闭环轨迹。 |
相机位姿评分。
在真实值对应的时间戳上进行评分。当相邻两个预测帧的时间间隔不超过 时,在真实值时间戳处对预测结果进行插值;否则记为预测缺失。
我们对每段记录分别评分,再对所有记录的结果按时长加权求平均。
MacroHands-Mono
MacroHands-Mono 只需要一个相机:它可以直接从普通视频中预测佩戴者每只手的 21 个 3D 关节,结果位于相机自身的坐标系中。
在 Benchmark 上,MacroHands-Mono 是三个数据集中两个数据集上精度最高的模型,而且在所有数据集上都能检测到几乎每一只手,见图 5。
最明显的是 SHOW3D:参与比较的模型都没有在该数据集上训练过。我们预测的关节与真实位置之间的平均距离为 ;表现最好的开源基线 HaWoR 为 ,而且大约每五只手中就会漏掉一只。
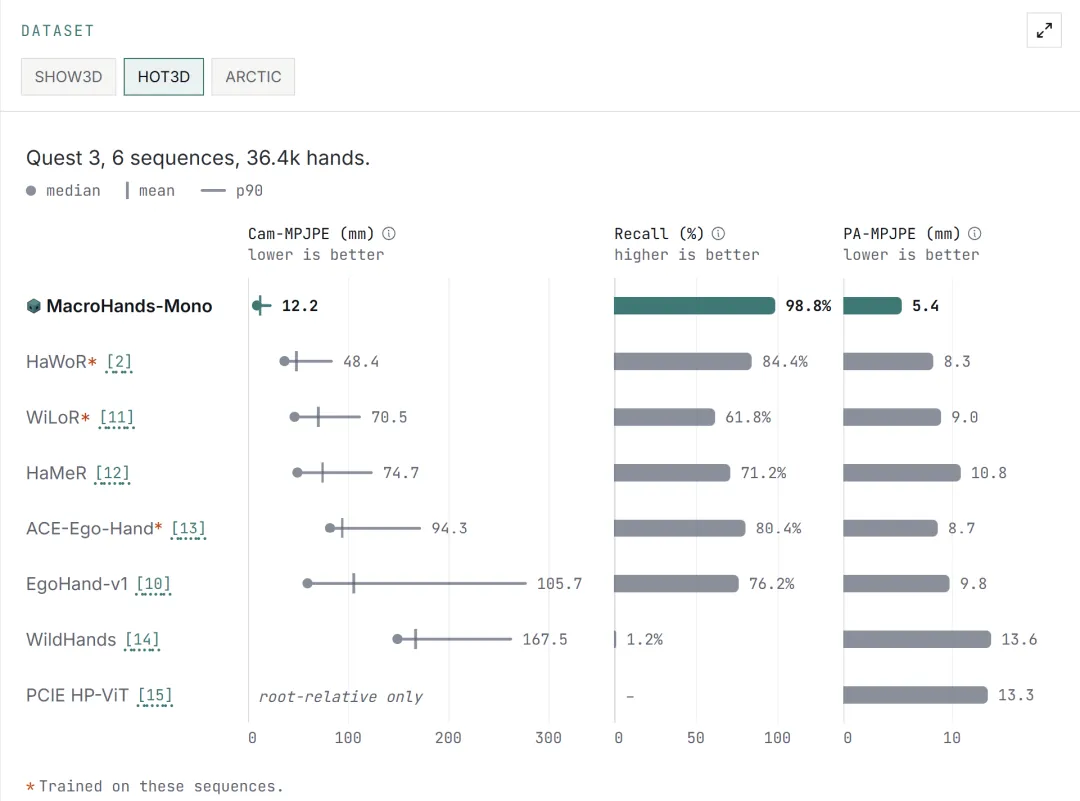
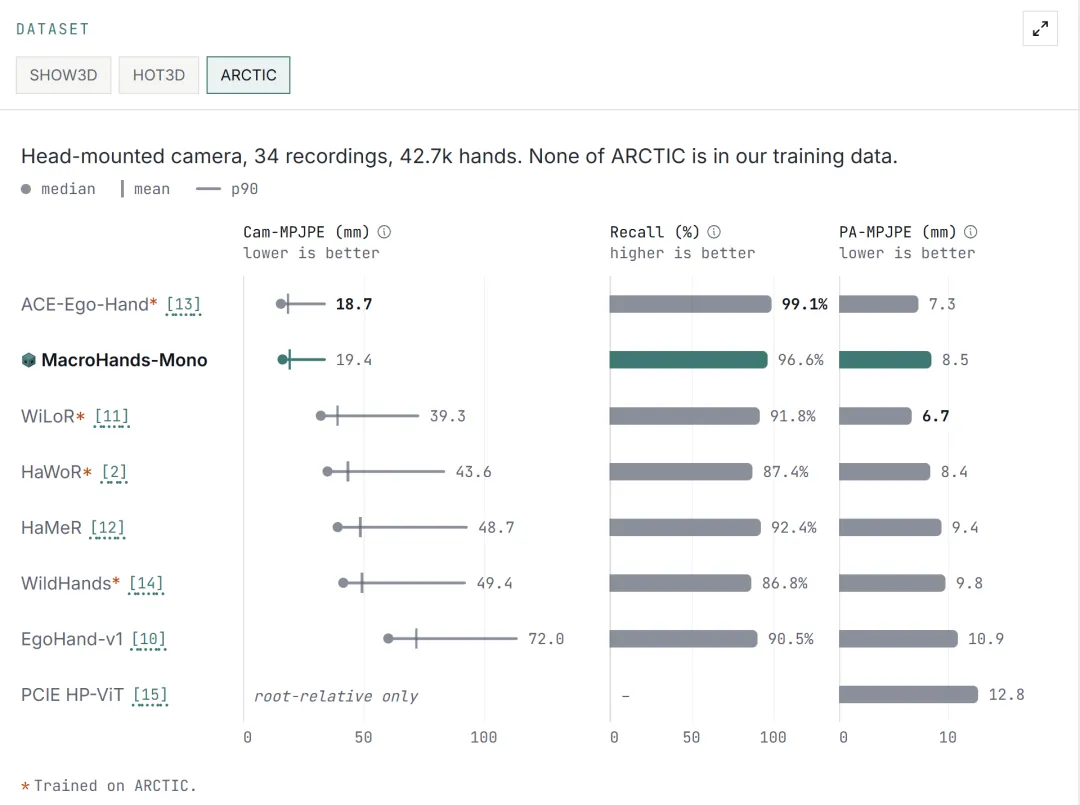
我们只在 ARCTIC 上略微落后:在 ARCTIC 数据集本身上训练过的 ACE-Ego-Hand 达到 ,我们的结果为 。MacroHands 从未见过任何一帧 ARCTIC 数据,甚至没有使用过它的训练集。
数据集:
SHOW3D
HOT3D
ARCTIC
SHOW3D:Quest 3,93 个场景,32 人,143,900 个手部样本。参与比较的模型均未在 SHOW3D 上训练。
中位数 / 均值 / 第 90 百分位数
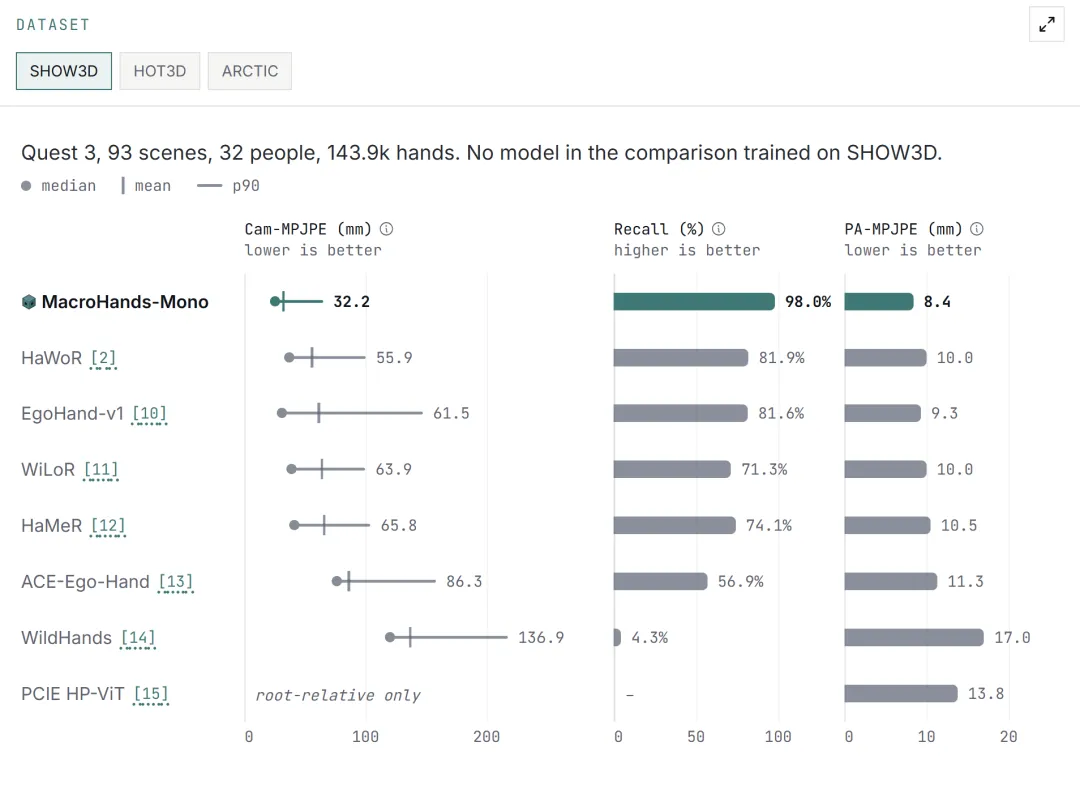
Cam-MPJPE(mm):在相机坐标系中,不进行对齐,预测关节与真实关节之间的平均距离。展示均值、中位数和第 90 百分位数。数值越低越好。
召回率(%):模型检测到的真实手部所占比例。模型须正确判断左右手,且预测包围框与真实包围框的 。数值越高越好。
PA-MPJPE(mm):将每只预测手部的旋转、平移和尺度与真实值对齐后的关节误差,因此只衡量手部形状。
MacroHands-Mono
PA-MPJPE(mm):将每只预测手部的旋转、平移和尺度与真实值对齐后的关节误差,因此只衡量手部形状。数值越低越好。
| 方法 | Cam-MPJPE 均值(mm)↓ | 召回率(%)↑ | PA-MPJPE(mm)↓ |
|---|---|---|---|
| MacroHands-Mono | 32.2 | 98.0 | 8.4 |
| HaWoR | 55.9 | 81.9 | 10.0 |
| EgoHand-v1 | 61.5 | 81.6 | 9.3 |
| WiLoR | 63.9 | 71.3 | 10.0 |
| HaMeR | 65.8 | 74.1 | 10.5 |
| ACE-Ego-Hand | 86.3 | 56.9 | 11.3 |
| WildHands | 136.9 | 4.3 | 17.0 |
| PCIE HP-ViT | 仅提供相对根关节的结果 | — | 13.8 |
单相机 3D 手部估计精度。MacroHands 用蓝绿色表示,开源基线用灰色表示。
尺子测试
ARCTIC 是唯一一个有基线方法的误差低于我们的 3D 手部 Benchmark:该方法为 ,我们为 。但这一基线 ACE-Ego-Hand 使用 ARCTIC 的训练集进行过训练。
这只是一个更大问题的缩影:Benchmark 污染。早期我们为内部使用测试手部追踪模型时,经常看到模型在训练过的 Benchmark 上取得很好的成绩,但在来自另一种设备的视频上完全无法准确估计深度。
我们认为原因是数据稀缺:带有 3D 手部标注的数据集屈指可数,因此大多数模型都使用那几个可以充当 Benchmark 的数据集进行训练。一个 Benchmark 的训练集与测试集中的相机、人物和房间相匹配,因此模型只要学会这些记录中常见的手部大小和距离,就可能取得不错的分数。
要严格测试这一问题,就需要在动作捕捉摄影棚中自行录制一个带真实值的留出数据集,这既耗时又昂贵。但模型之间的差距往往非常大,以至于一个简单得多的测试就能看出来。
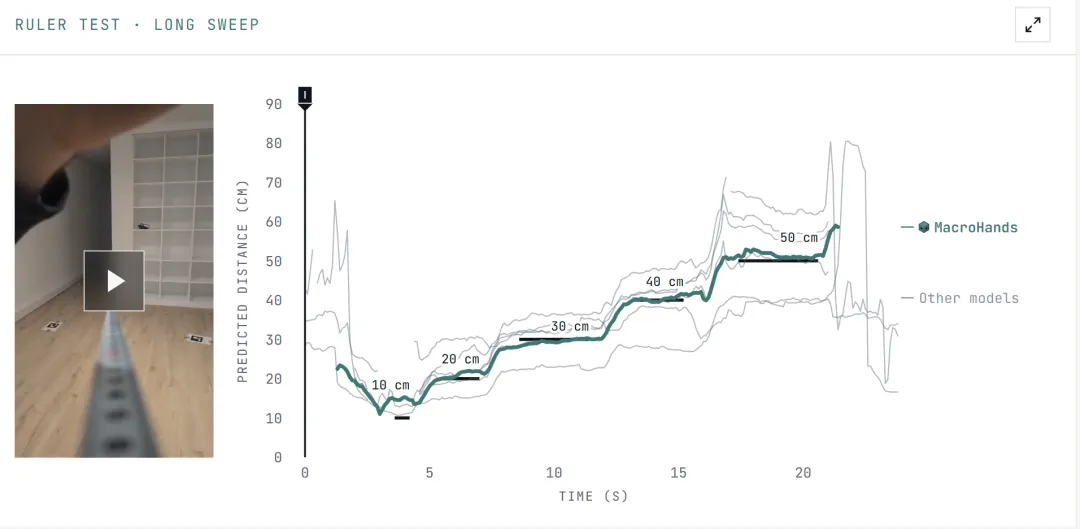
找一部相机内参已知的手机和一把卷尺,关闭视频防抖,因为防抖会裁剪和移动图像,使原有内参失效。然后录制自己沿着卷尺依次将手腕放在 、、、 和 处的视频。伸到 有些吃力,但可以做到。接着,使用手机的相机内参运行模型,并将模型估计的手腕深度与卷尺读数进行比较。
这种测量的精度只能达到 –,但应该足够了。我们尝试的许多其他手部追踪模型,误差并非几厘米,而是 –;而且手离相机越远,误差越大。如果你正在评测手部追踪模型,我们认为这应该是你做的第一个测试。
尺子测试 · 大范围移动
我们的尺子测试:使用一部手机拍摄,设备为 Pixel 10a,关闭防抖。每个模型都使用手机真实的相机内参;Perceptron Egocentric 1.0 不接收内参,而是使用自己的估计值。横向的阶梯表示手在卷尺上的位置。MacroHands 用蓝绿色表示,其他模型用灰色表示。在 处,手几乎无法完整进入画面,六个基线模型中有四个在该位置没有输出结果。
找到正确的手
除了深度之外,我们在真实第一视角数据中反复遇到的第二个问题,是模型能否先找到并追踪正确的手。
与 Benchmark 视频不同,真实视频中充满了容易让模型出错的情况:其他人的手伸入画面;佩戴者的赤脚出现在画面中,看起来可能非常像手;佩戴者自己的手消失在手持工具后面;以及完全遮住手部的工作手套。
Benchmark。为了衡量我们的模型和其他模型处理这些情况的能力,我们构建了一个内部第一视角视频片段 Benchmark,所有参与测试的模型都没有在这些片段上训练过。
每一帧中,佩戴者的每只手都由人工标注包围框,并标明左手或右手。我们也标注画面中其他人的手,这些手约占所有标注手部的三分之一。如果模型将其中一只手识别为佩戴者的手,就记为错误。视频片段还按场景打上标签:画面中出现脚、遮挡、手套,以及画面中没有佩戴者的手。
评分方式。我们以相同方式,根据各模型输出的 3D 手部结果进行评分。我们将模型预测的 21 个关节投影到图像上,取其外接框并向外扩展 ,作为检测框;这样做是因为我们的标注框由人工绘制,范围稍大。
当一个检测结果的置信度高于 ,并且其检测框与佩戴者手部标注框的交并比至少为 ,即 时,该检测才算正确。AP50 是在这一交并比阈值下计算的平均精度,它综合了所有置信度阈值下的精确率和召回率;数值越高越好。
其余情况均视为错误。对于不正确的检测框,如果它与某个已标注手部的重叠度至少为 ,就将它归到重叠度最高的那只手:
- 正确的手,但检测框只覆盖了其中一部分;
- 佩戴者的另一只手,即左右手识别颠倒;
- 其他人的手。
如果检测框与所有已标注手部的重叠度都低于 ,则记为误检。如果佩戴者的一只手没有对应的正确检测框,则记为漏检。
下图同时展示两个方面:佩戴者的每只手被如何识别,以及模型输出的每个检测框落在了哪里。
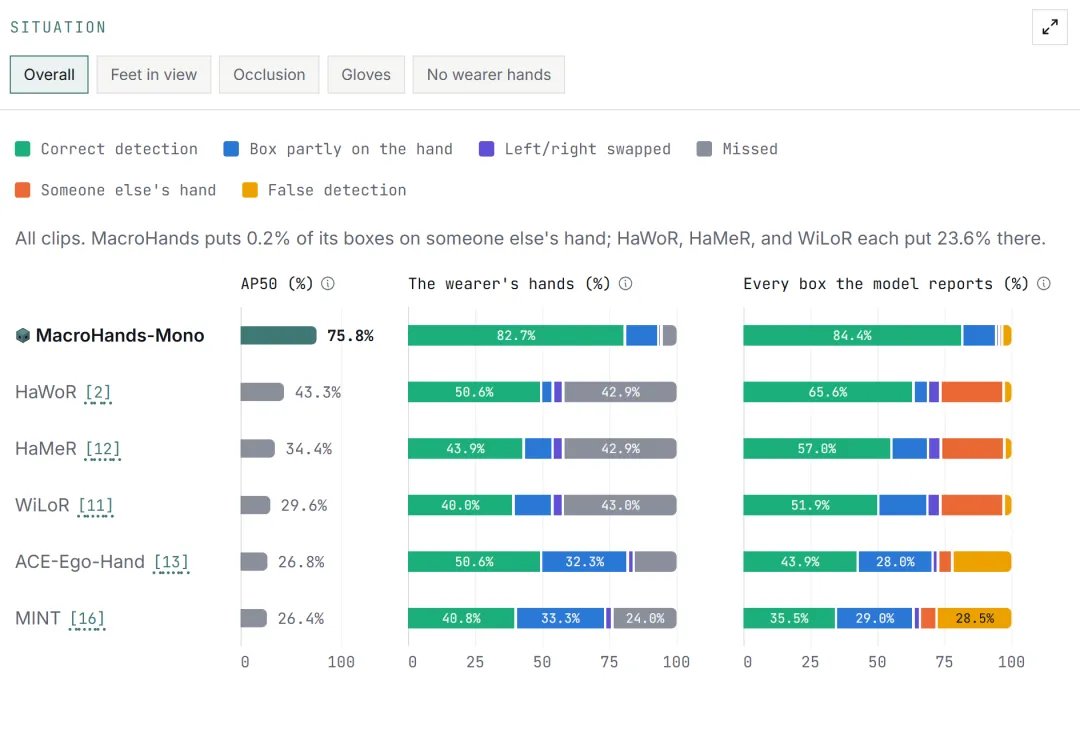
在所有视频片段中,MacroHands 有 的检测框落在其他人的手上;HaWoR、HaMeR 和 WiLoR 的这一比例均为 。
AP50(%):与佩戴者手部标注框的交并比至少为 ,即 时的平均精度,综合所有置信度阈值下的精确率和召回率。
佩戴者的手(%):每只已标注的佩戴者手部的检测结果:被正确检测框找到、仅被部分覆盖、左右手颠倒,或被漏检。
模型输出的所有检测框(%):每个检测框落在什么位置:正确的手、仅部分覆盖正确的手、佩戴者的另一只手、其他人的手,或没有任何标注手部的位置,即误检。
| 方法 | AP50(%) |
|---|---|
| MacroHands-Mono | 75.8 |
| HaWoR | 43.3 |
| HaMeR | 34.4 |
| WiLoR | 29.6 |
| ACE-Ego-Hand | 26.8 |
| MINT | 26.4 |
人工标注 Benchmark 上的检测结果。左:每只已标注的佩戴者手部的检测情况。右:模型输出的每个检测框所落的位置。
MacroHands 找到了佩戴者 的手,精确率为 。最强的基线 HaWoR 找到了 的手,精确率为 。
当其他人出现在画面中时,差距最大。在那些长时间看不到佩戴者的手、但经常可以看到其他人手部的视频片段中,正确做法是不输出任何结果。在这些片段中,MacroHands 没有任何检测框落在其他人已标注的手上;而 HaWoR、HaMeR 和 WiLoR 有 的检测框落在其他人的手上。
在视频变得困难的地方,基线方法也恰恰会丢失佩戴者的手。佩戴手套时,表现最好的基线找到 的手,MacroHands 为 ;存在遮挡时,表现最好的基线找到 ,MacroHands 为 。
由于包含内部数据,我们无法公开这个 Benchmark,但图 8 展示了来自开源视频的示例。
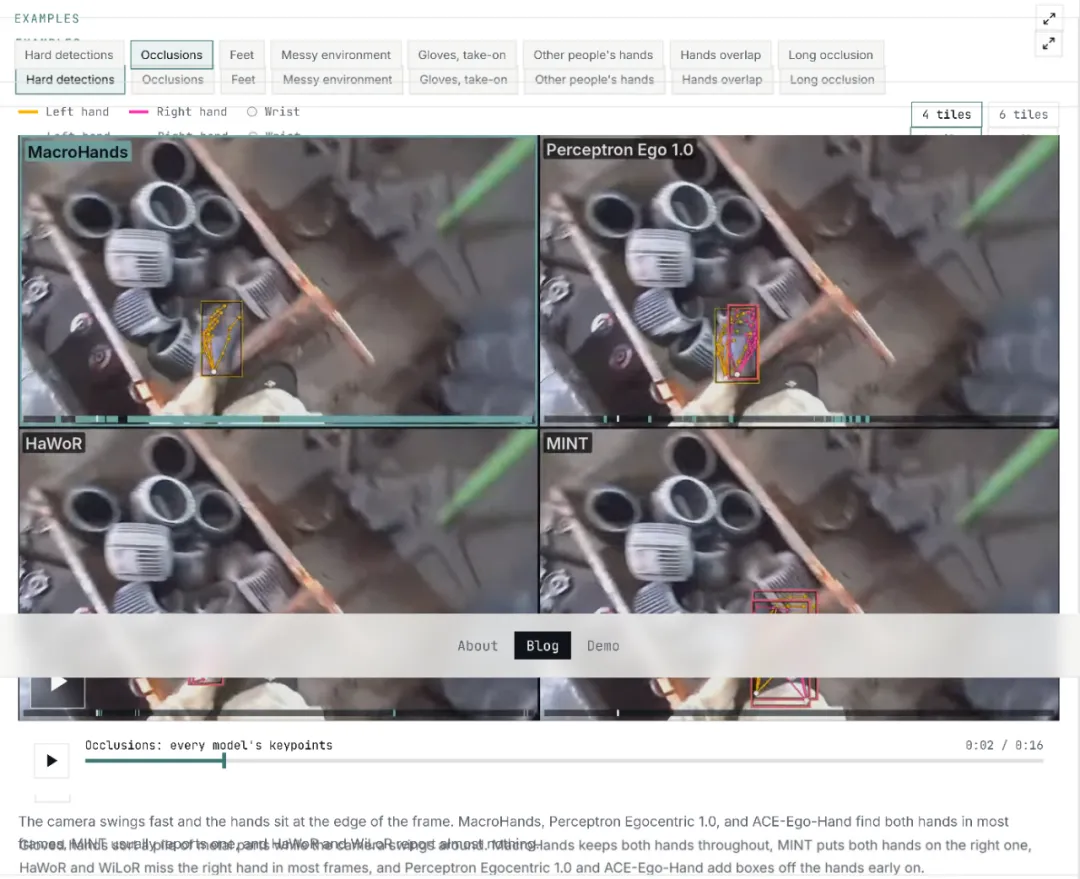
戴着手套的双手在整理一堆金属零件,相机不断转动。MacroHands 在整个过程中都保持对双手的追踪;MINT 将两只手的结果都放在右手上;HaWoR 和 WiLoR 在大多数帧中漏掉了右手;Perceptron Egocentric 1.0 和 ACE-Ego-Hand 在视频前段输出了落在手部以外的检测框。
视频来自 Egocentric-10K(build.ai,Apache-2.0),工厂 6,工人 4。每个模型都使用相同的去畸变视频和标定后的相机参数。
MacroHands-Stereo
前面的所有结果都只使用一个相机。虽然 MacroHands-Mono 已经相当准确,但仍然可能估错深度。双目相机通过增加同一场景的第二个视角来帮助估计深度;两个视角之间存在轻微位移,见图 9。
我们专门训练了一个接收双目视频的模型版本:MacroHands-Stereo。在 SHOW3D 上,MacroHands-Stereo 的误差从 降至 ,约降至原来的 ;在 HOT3D 上,误差从 降至 。
最困难的帧也获得了类似程度的改善:SHOW3D 上的第 90 百分位误差从 降至 ;HOT3D 上从 降至 。
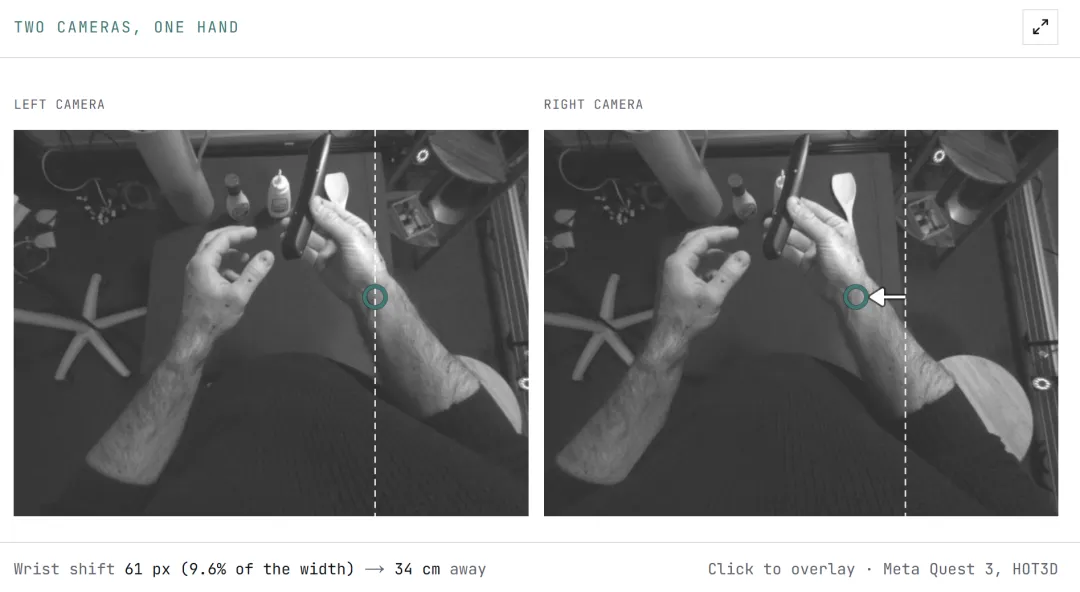
手腕位移 ,占画面宽度的 ,对应距离为 。
点击叠加 · Meta Quest 3,HOT3D
两个相机从略有不同的位置观察同一只手,就像人的双眼。手离相机越近,它在两张图像之间的位移就越大;模型可以根据这一位移判断手有多远。
最初用于单目评测的 Benchmark 中,只有 SHOW3D 和 HOT3D 包含双目视频,两者均由 Quest 3 的两个前置相机录制。ARCTIC 的第一视角视频来自单个头戴式相机,因此只出现在单目评测结果中。对于单目模型,我们使用左相机图像,并在同一批手部样本上评分。
令人意外的是,其他专为双目设计的模型相比单目基线的提升很小。UmeTrack(Han 等人,2022)是 Meta 的多视角手部追踪器,也是这些双目方法中表现最好的:在 SHOW3D 上,其误差为 ,单目 HaWoR 为 ;在 HOT3D 上,UmeTrack 为 ,HaWoR* 为 。
数据集:
SHOW3D
HOT3D
SHOW3D:Quest 3 双目相机,93 个场景,32 人,143,900 个手部样本。参与比较的模型均未在 SHOW3D 上训练。单目模型使用左相机图像,并在同一批手部样本上评分。
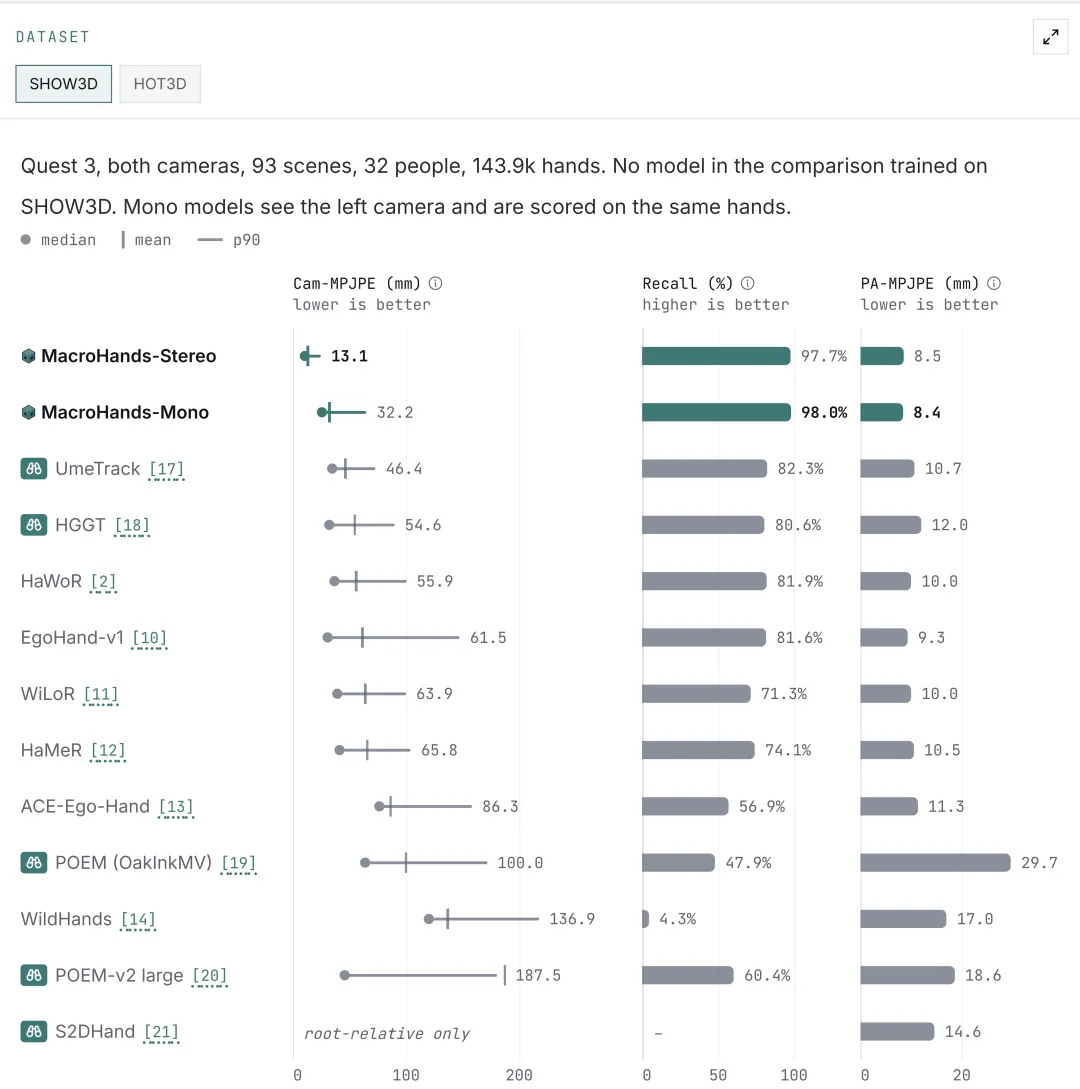
中位数 / 均值 / 第 90 百分位数
Cam-MPJPE(mm):在相机坐标系中,不进行对齐,预测关节与真实关节之间的平均距离。展示均值、中位数和第 90 百分位数。数值越低越好。
召回率(%):模型检测到的真实手部所占比例。模型须正确判断左右手,且预测包围框与真实包围框的 。数值越高越好。
PA-MPJPE(mm):将每只预测手部的旋转、平移和尺度与真实值对齐后的关节误差,因此只衡量手部形状。数值越低越好。
双相机 3D 手部估计精度。MacroHands 用蓝绿色表示,开源基线用灰色表示。UmeTrack(Han 等人,2022)没有手部检测器,因此使用 WiLoR 检测框生成的裁剪图像。
这一提升几乎完全来自深度估计。经过 Procrustes 对齐后,两个模型在 SHOW3D 上的 PA-MPJPE 基本相同:双相机为 ,单相机为 。
第二个相机带来的额外信息是手部距离,而单视角只能根据外观推断距离。因此,如果你正在选择采集设备,我们推荐使用双目相机。如果你已经花钱购买了大量单目视频,MacroHands-Mono 的表现仍然优于我们测试过的所有双目基线。
相机位姿
正如我们在上一篇文章中展示的,仅仅知道手部相对于相机如何运动是不够的。机器人训练和场景重建都需要知道相机自身的运动方向和路径,因此我们也训练模型来估计相机运动。
相机路径在两个时间尺度上都很重要:在整段记录中,路径不能出现明显漂移,这样才能重建场景或将其转换为仿真环境;在单个一秒时间段内,路径必须足够精确,因为策略通常在这一时间范围内学习预测 Action Chunk。
我们针对这两种用途设计了处理 pipeline,并分别报告两个时间尺度上的误差。Monado 和 Aria Gen 2 还会记录 IMU,即运动传感器数据;MacroHands 在有 IMU 数据时会使用它。在没有 IMU 数据的 HOT3D 上,所有方法都只使用相机,MacroHands 依然领先:在双目设置下,RPE 为 ,相比之下基线为 。
头戴设备:
HOT3D
Monado
Aria Gen 2
HOT3D:Quest 3,6 段序列,0.21 小时。
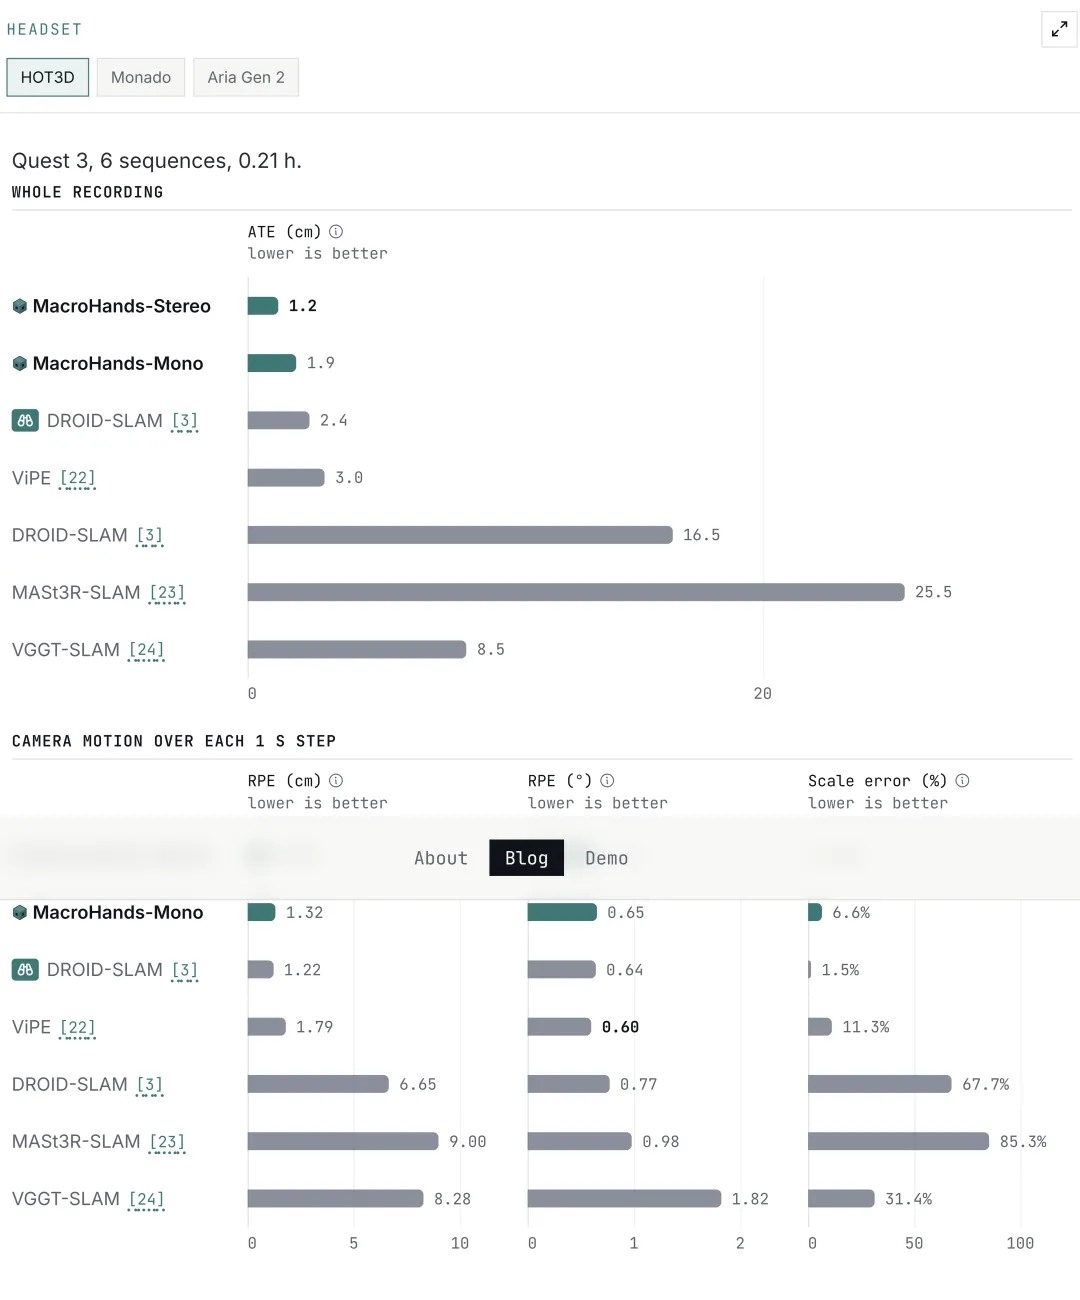
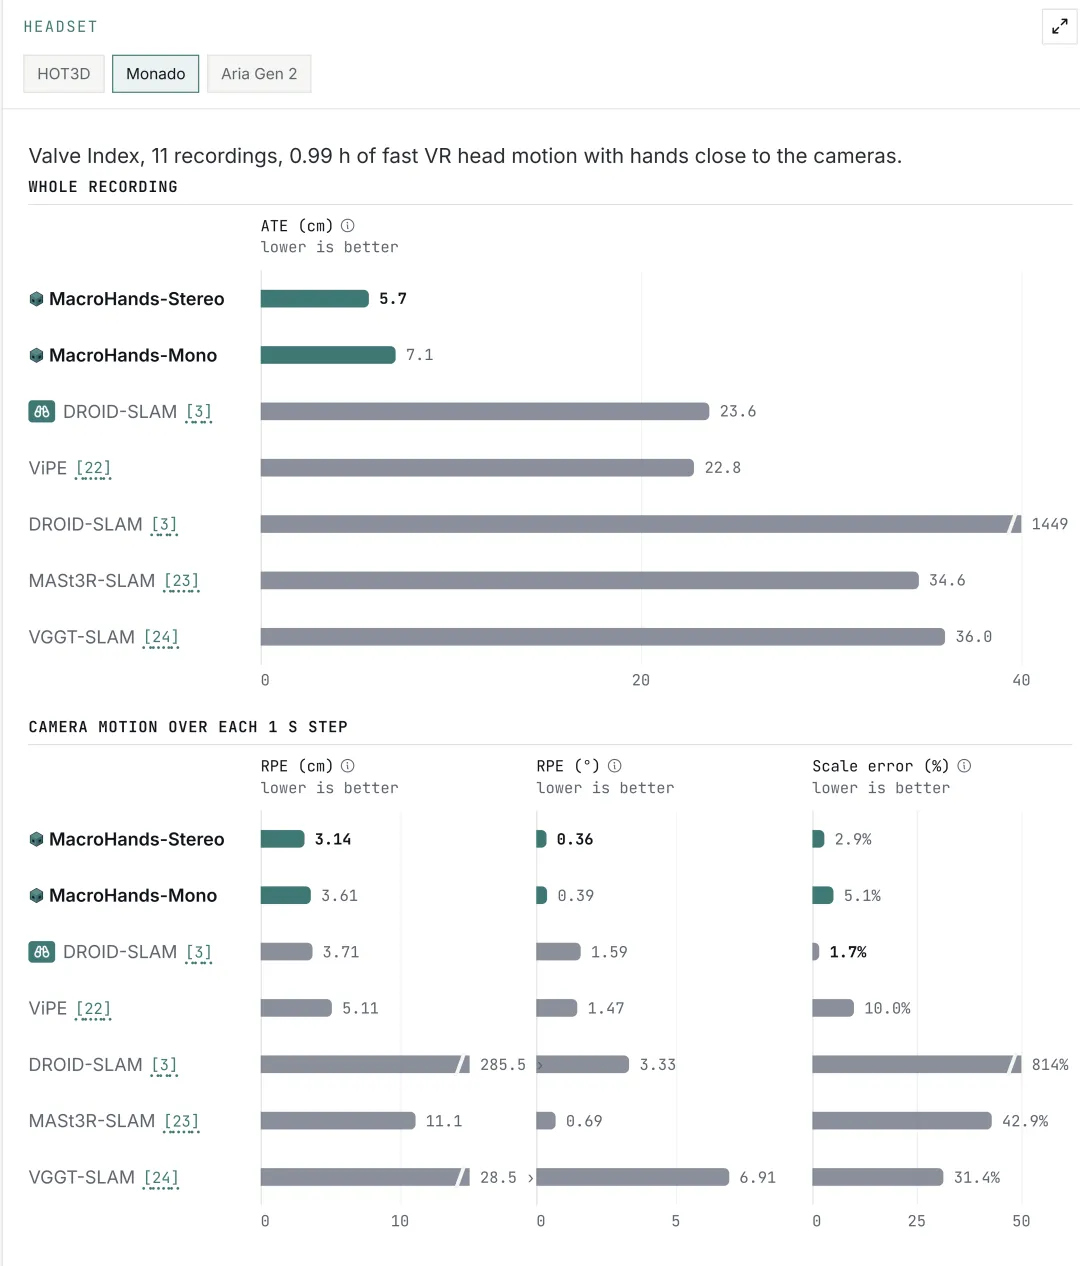
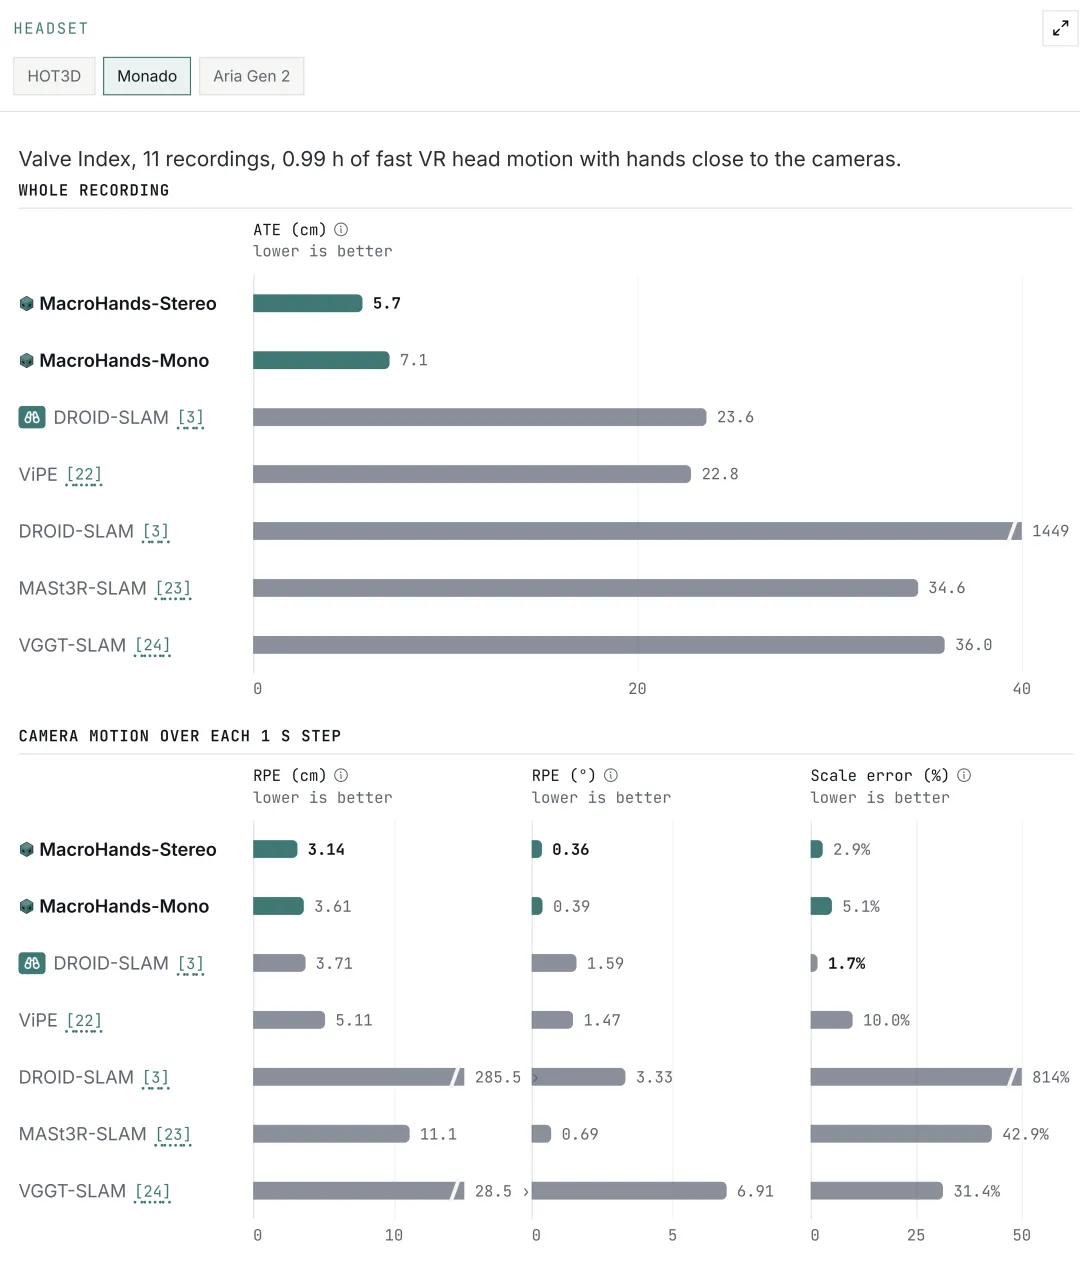
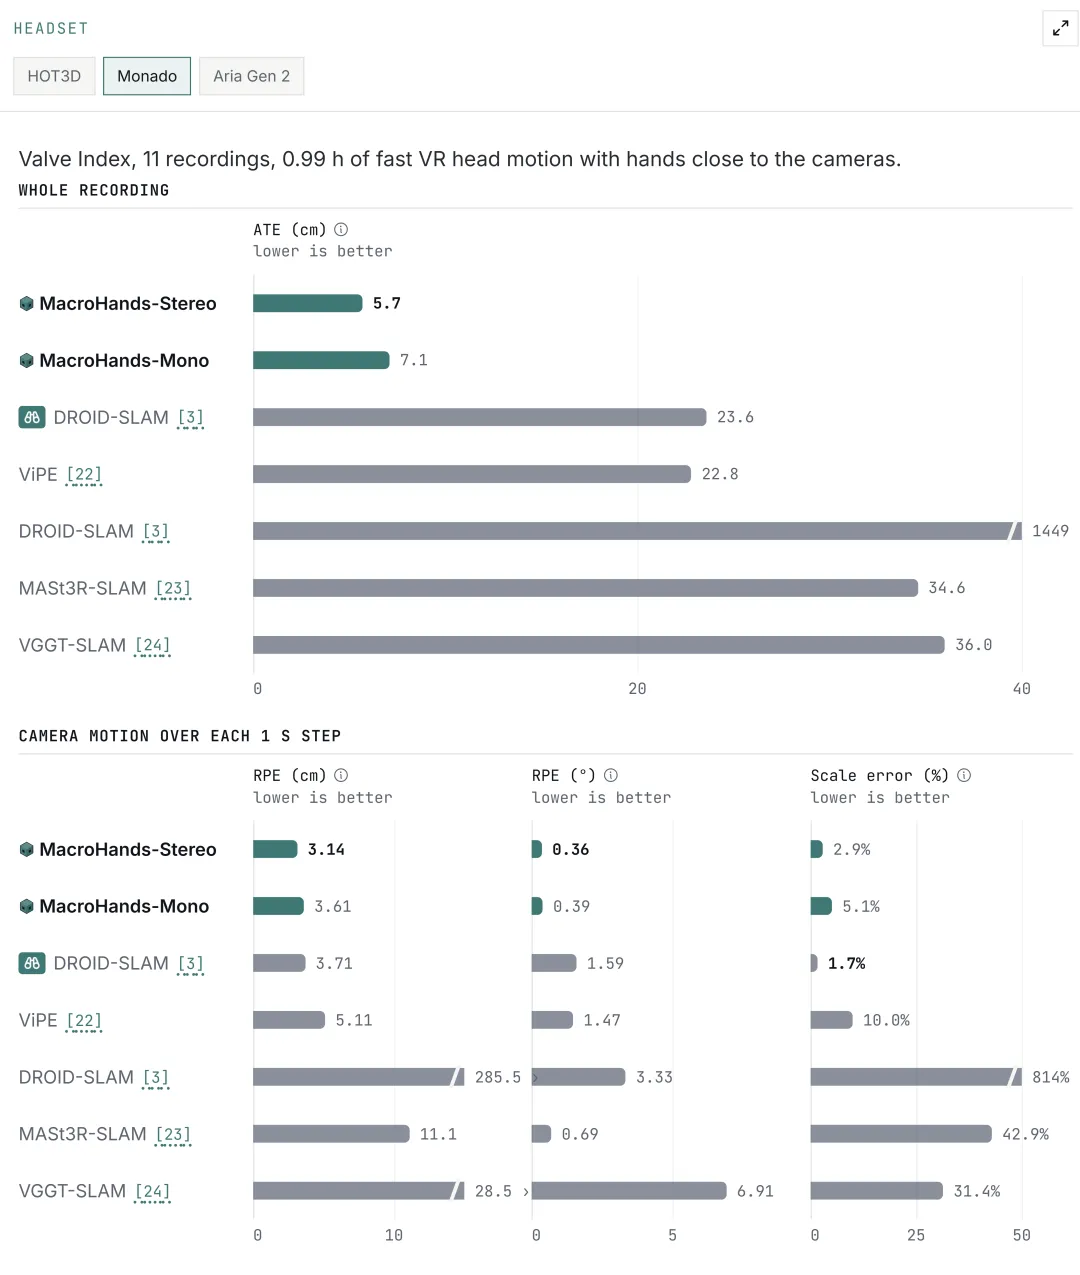
整段记录
ATE(cm):在对整条路径进行一次刚体对齐后,不调整尺度,计算整段记录中的相机位置误差,即均方根误差(RMSE)。数值越低越好。
| 方法 | ATE(cm)↓ |
|---|---|
| MacroHands-Stereo | 1.2 |
| MacroHands-Mono | 1.9 |
| DROID-SLAM | 2.4 |
| ViPE | 3.0 |
| DROID-SLAM | 16.5 |
| MASt3R-SLAM | 25.5 |
| VGGT-SLAM | 8.5 |
每个 1 秒时间步内的相机运动
RPE(cm):相机在每个 1 秒时间步内的平移误差,不进行对齐。数值越低越好。
RPE(°):相机在每个 1 秒时间步内的旋转误差,不进行对齐。数值越低越好。
尺度误差(%):相机运动在真实世界中的尺度偏差,即各个 1 秒时间步内预测距离与真实距离之比的中位数偏离 1 的程度。数值越低越好。
| 方法 | RPE 平移(cm)↓ | RPE 旋转(°)↓ | 尺度误差(%)↓ |
|---|---|---|---|
| MacroHands-Stereo | 0.96 | 0.64 | 1.1 |
| MacroHands-Mono | 1.32 | 0.65 | 6.6 |
| DROID-SLAM | 1.22 | 0.64 | 1.5 |
| ViPE | 1.79 | 0.60 | 11.3 |
| DROID-SLAM | 6.65 | 0.77 | 67.7 |
| MASt3R-SLAM | 9.00 | 0.98 | 85.3 |
| VGGT-SLAM | 8.28 | 1.82 | 31.4 |
各头戴设备上的相机位姿估计结果。MacroHands 用蓝绿色表示,开源基线用灰色表示;所有指标均为数值越低越好。
与手部估计一样,单相机最难处理的仍然是深度:仅凭图像,移动 和移动 看起来可能完全一样。
使用单相机的 DROID-SLAM 对运动尺度的估计误差从 到超过 不等;即便是估计实际尺度深度的 ViPE,误差也有 –。MacroHands-Mono 的尺度误差保持在 –。在所有三种头戴设备上,从整段记录来看,它的漂移都低于使用双相机的 DROID-SLAM。
使用双目时,MacroHands 的漂移约为双目 DROID-SLAM 的 到 。
整合:将手部放入世界坐标系
现在,手部追踪和相机位姿估计这两个部分都已具备,我们可以衡量机器人策略实际学习的内容:从运动开始时佩戴者相机的视角出发,手部如何在世界中运动。
我们使用上一篇文章中的 Action MPJPE 指标进行衡量。对于每一帧,我们取其后一个 Action Chunk 内的手部运动,使用各方法自己估计的相机路径确定预测关节的位置,使用真实相机路径确定真实关节的位置。
两者都以起始帧的相机坐标系为参考,然后不进行对齐,逐关节比较。即使一只手在图像中看起来正确,但如果它随着发生漂移或尺度估计错误的相机一起移动,仍然会被计为错误。
与上一篇文章一样,我们报告 Action Chunk 的结果,同时也报告 Action Chunk 的结果,见图 12。
我们在这里没有使用 SHOW3D,因为该数据集公开的相机位姿在 93 个场景中的 25 个场景里漏掉了大幅度头部转动。这些场景中的手部标注仍然准确,但世界坐标系下的相机路径并不准确。
数据集:
HOT3D
ARCTIC
HOT3D:Quest 3,6 段序列,包含双目和单目设置。
Action MPJPE(mm):未来 或 的手部运动,使用各方法自己的相机路径确定位置,不进行对齐,逐关节与真实值比较。相机漂移或尺度估计错误都会计入误差。数值越低越好。
* 表示在这些序列上训练过。
未来 和 内,世界坐标系中的手部运动误差。
在 HOT3D 上,对于一个 的 Action Chunk,MacroHands 双目版本的手部运动误差为 ,单目版本为 。使用自身 SLAM 的 HaWoR 误差为 ,约为前者的 – 倍。
在 ARCTIC 上,MacroHands-Mono 的误差为 ,HaWoR 为 。
结论
大多数开源手部追踪器在真实第一视角视频中的表现仍然不够好,而每一处缺陷都会影响后续 pipeline。
漏检手部会降低数据的可用比例,导致有价值的视频记录被丢弃;追踪结果跳到其他人或脚上,则会给训练数据带来毫无意义的动作,导致训练不稳定。手部形状不准确会增加精细操作的学习难度;在真实视频中,达到或超过 的深度误差会让机器人学会伸向错误的位置。
我们认为,数据质量以及从数据中提取的训练目标的质量,是提升机器人策略性能的主要抓手。这也是我们构建 MacroHands 的原因:在策略学习所使用的 Action Chunk 上,它在 HOT3D 中的手部轨迹误差仅为我们测试过的最佳开源 pipeline 的约 到 ;在 ARCTIC 上,误差也降至不到一半。
引用
@misc{macrodata2026_macrohands, title={MacroHands: 3D hands and camera pose from egocentric video}, author={{Macrodata Labs}}, year={2026}, url={ }
脚注
即使是动作捕捉也达不到这一精度:贴在皮肤上的标记点会相对于手指骨骼滑动(Metcalf 等人,2020);专用手部捕捉设备报告的中位误差为 –(Rim 等人,2026)。
VGGT-SLAM 的公开版本只输出关键帧的位姿,其自身评测也只对这些帧进行评分,因此我们按照其公开版本的方式报告结果。误差只在输出了位姿的帧上计算。此外,它在两段 Monado 记录上发生崩溃,没有输出位姿,因此这两段记录未计入其 Monado 结果。
来源:human five