随着 Fable 和 GPT-6 Astra 相继问世,具身智能领域受到巨大冲击,甚至掀起了一股「通用大模型能搞定机器人一切」的热潮。
开发者们争相将这两个模型接入机器人,尝试完成各种复杂任务。但随着探索深入,模型规模庞大的问题也逐渐显现:高昂的推理成本、难以满足实时控制需求的响应延迟,以及端侧算力、功耗和散热限制,都让这些强大的模型难以直接落地。
如何让通用大模型能够让机器人用得起、跑得动,成了新的难题。
但这一切都将开始改变。MIT 韩松团队公布了机器人后训练项目 PEAR (Post-training Engine for Agentic Robotics),把一个 27B 参数的千问模型接上一台真实的双臂机器人。
让我们看两个实机演示效果。研究者给它一张梵高《星空》,它在白板上用夹爪画出了线稿。桌上摆碘水、酚酞、乙醇三瓶试剂,问它怎么验证溶液是否呈碱性,它挑了酚酞滴进去,溶液变粉。

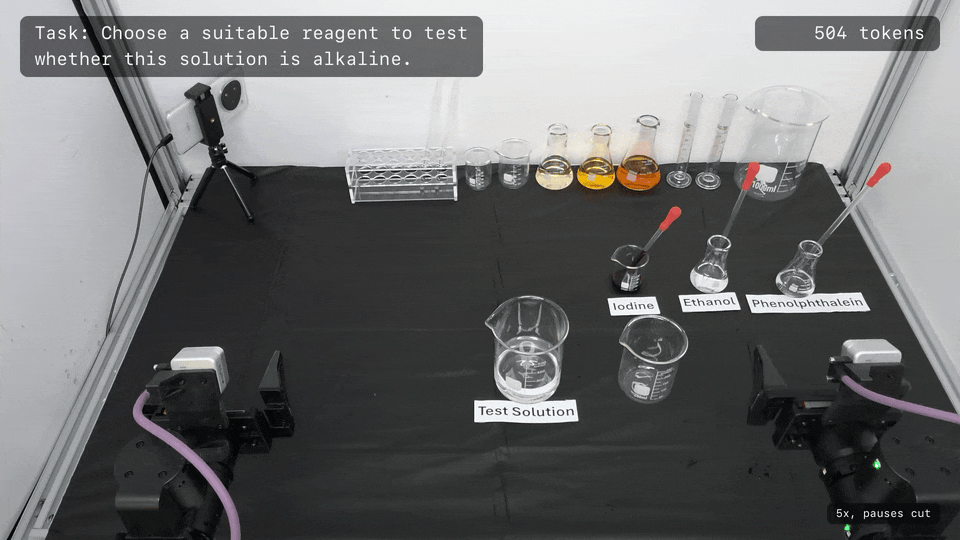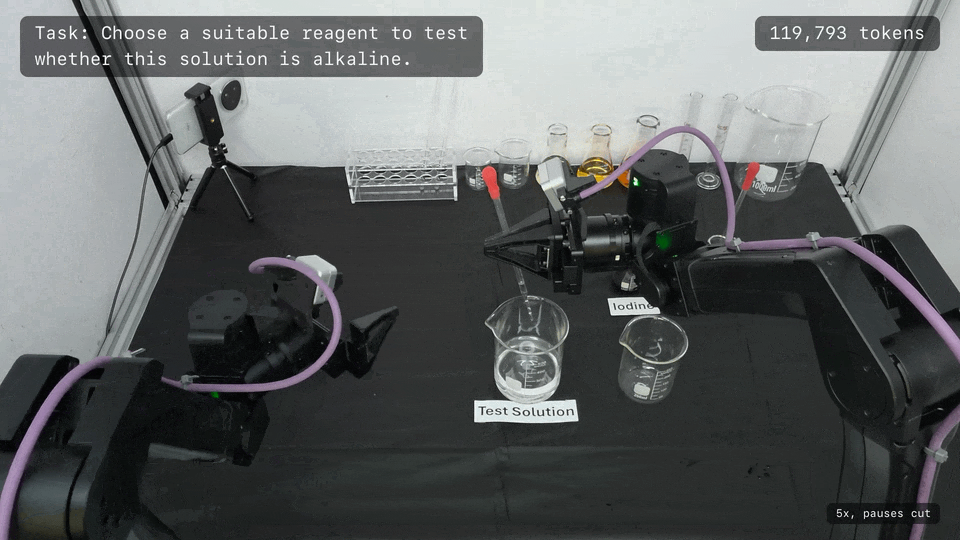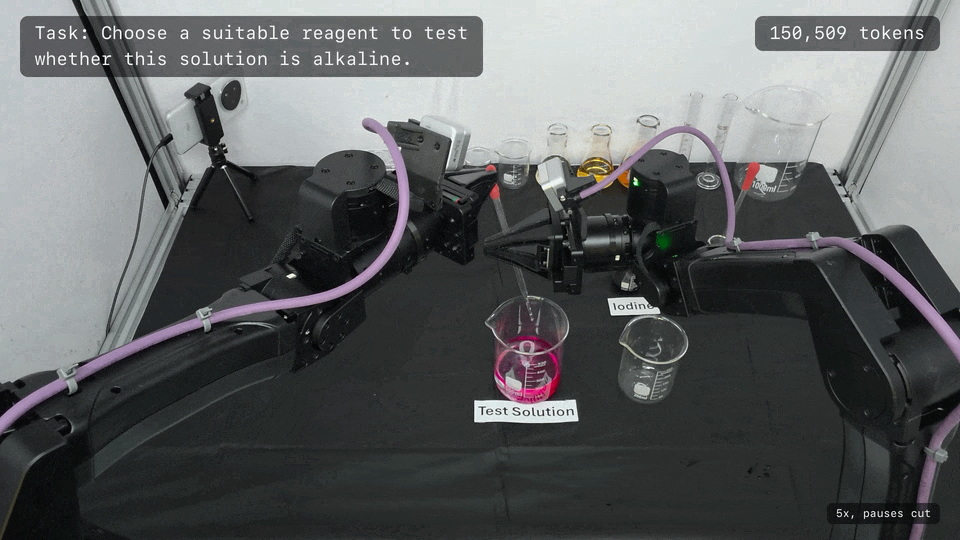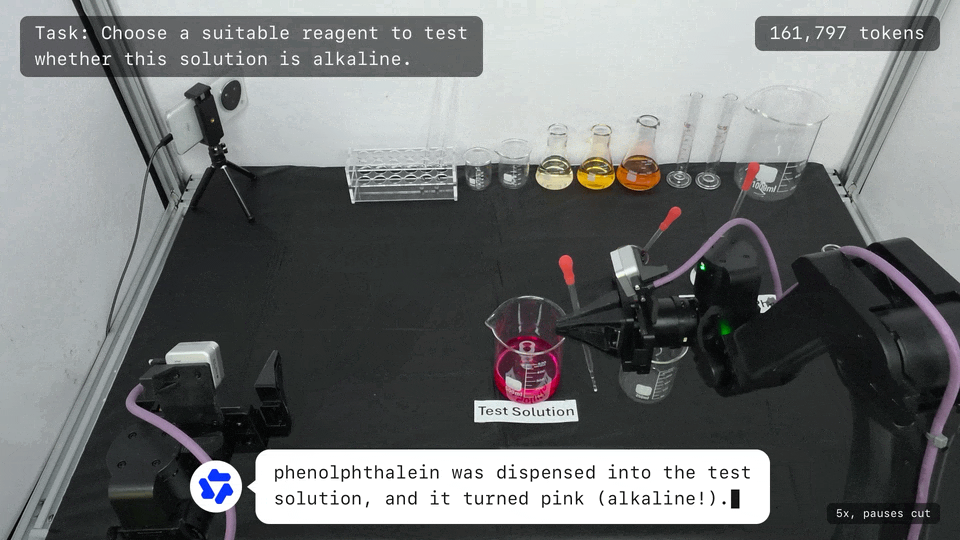
PEAR 基于开源的 Qwen3.8-27B,不需要一帧人类遥操演示,不需要一条真机数据,只在仿真环境里做强化学习。训完之后直接拉到一台它从未见过的双臂 YAM 真机上,30 次测试成功 18 次,而训练前是 0 次。通用性更强,执行指令的能力也比 π0.5 要好。在 LIBERO 模式下,它的表现几乎可以与 Astra Max 相媲美。
在 RTX 5090 显卡上,它的运行速度可以达到 220 以上 tok/s 的水平,完全可以本地运行。
值得注意的一点是,它相比 Qwen3.8-27B 在 AIME、GPQA、LiveCodeBench 等九项通用 benchmark 上的分数几乎不变,模型不会失去数学和编程等通用能力。
Github 链接:
博客链接:
用电脑的方式,就是用机械臂的方式
这很巧妙,机械臂的操作本质上和电脑的操作很相似,只不过是二维与三维的区别。
智能体的 Computer Use 干了什么?看一张截图,思维链里想「保存按钮在右上角」,吐出 click (812, 431),操作系统挪鼠标。
PEAR 对机械臂做的是同一件事。每回合输入三路摄像头画面加机械臂当前的关节状态,它在思维链里分析「夹爪在橡皮正上方,把手指降到橡皮两侧」,然后输出一段 JSON,包含末端执行器的下一个目标位姿(x、y、z、roll、pitch、yaw)。逆运动学算出关节角,底层控制器驱动机械臂到位。这一回合连同新拍到的画面一起回填上下文,开启下一回合。
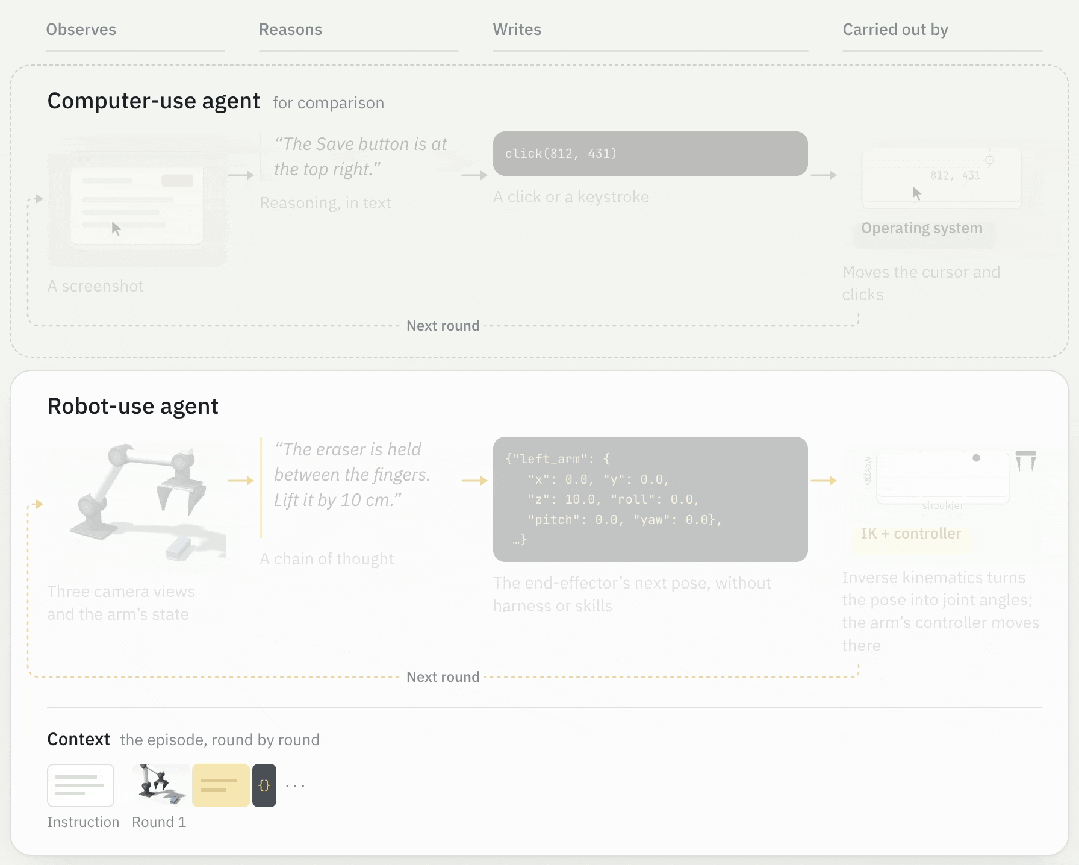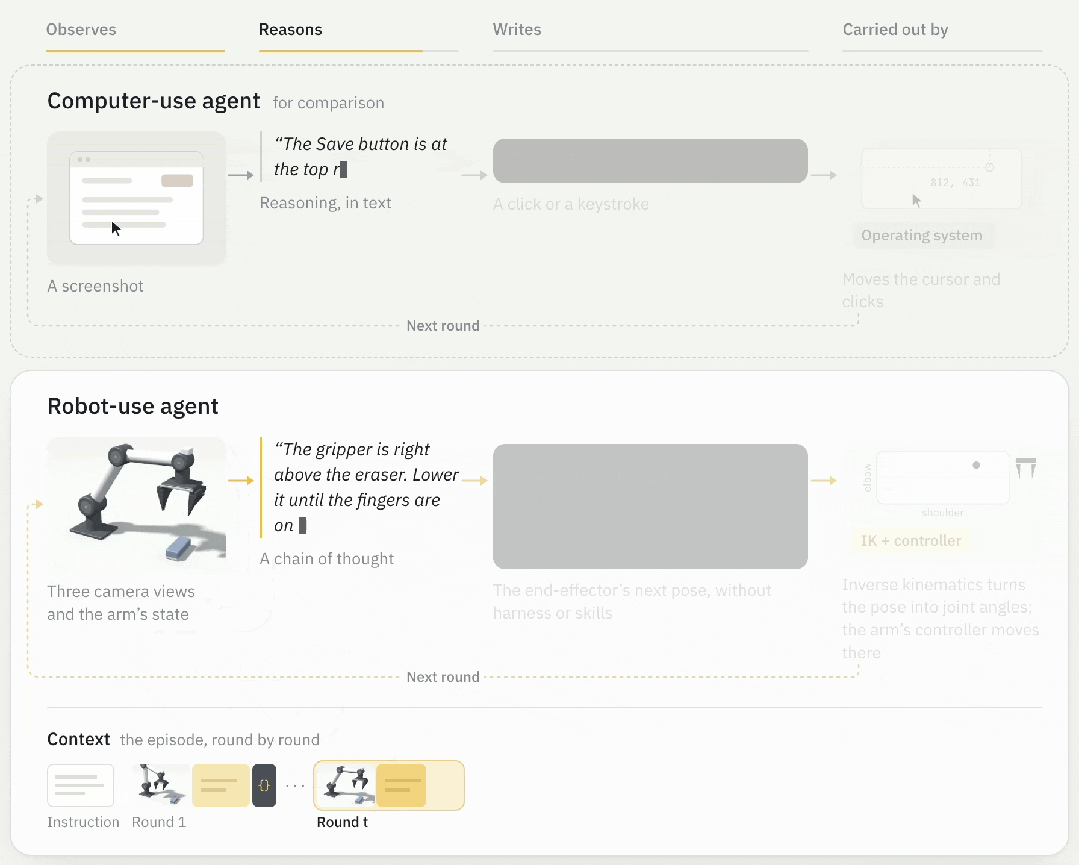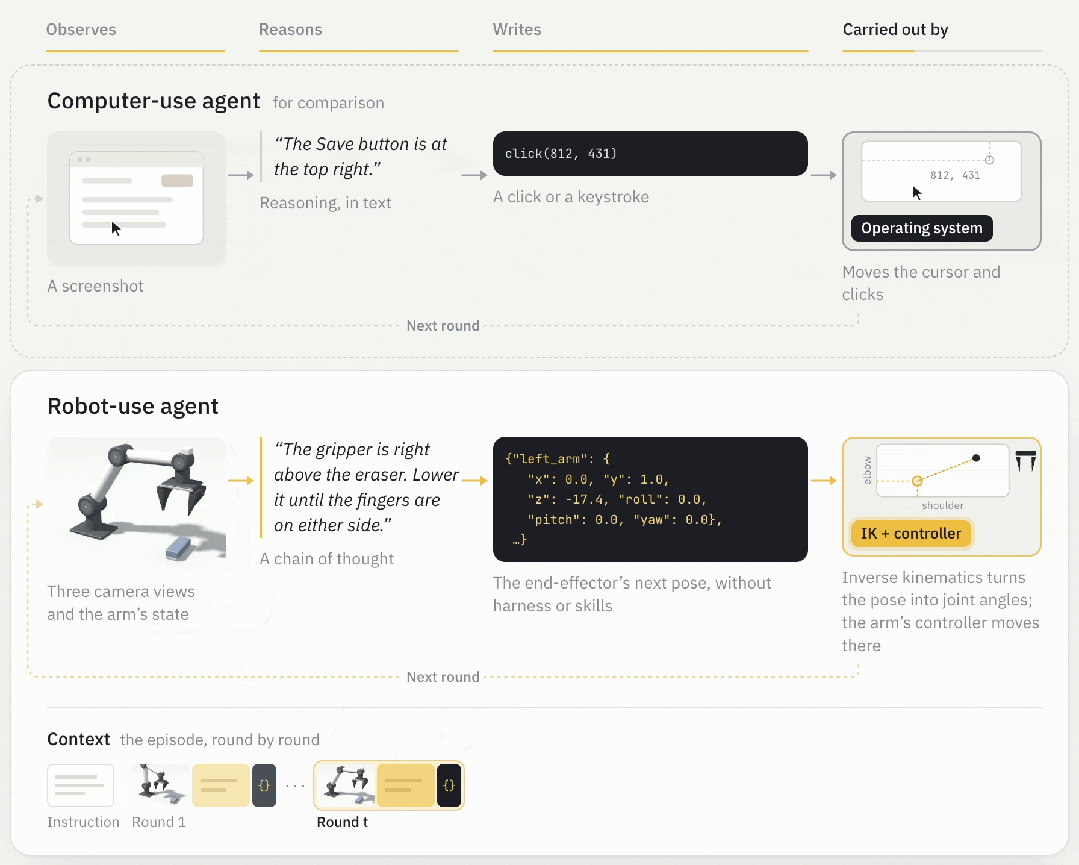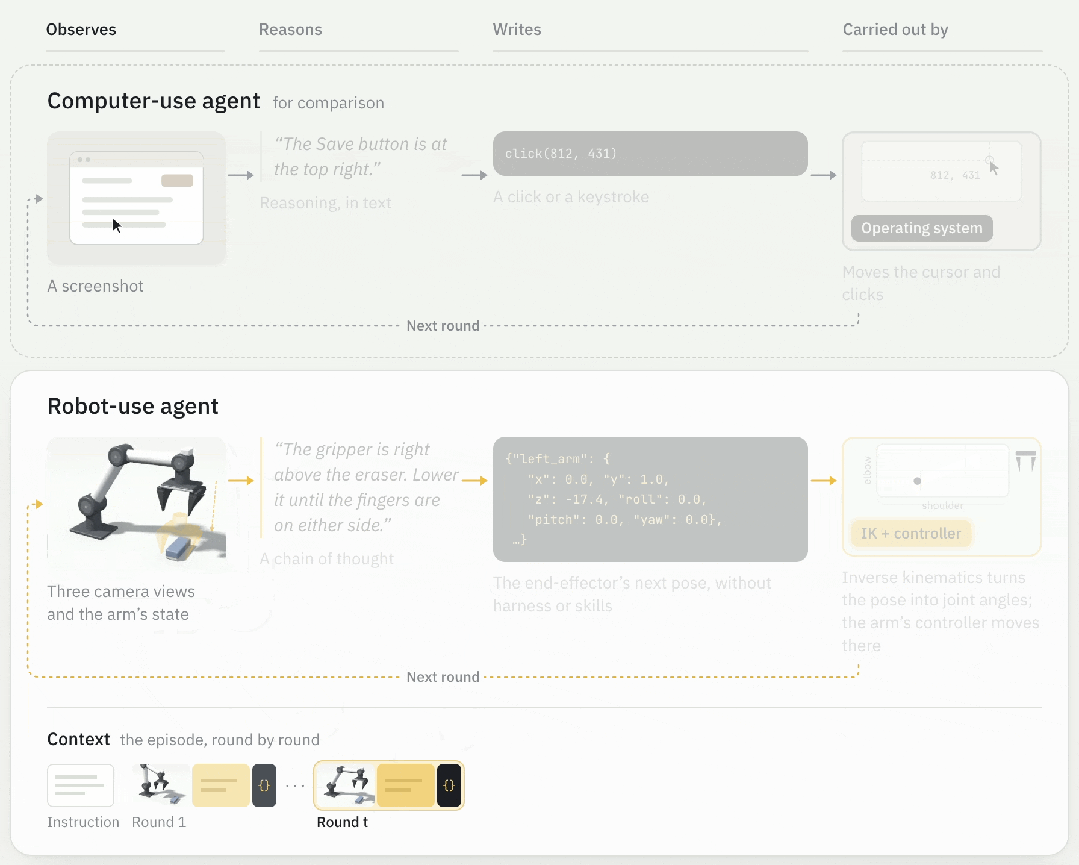
机器人操作智能体拾取橡皮擦的最后三轮交互过程,上方展示了计算机操作智能体作为对比。
每一轮中,机器人操作智能体都会观察摄像头画面和机械臂状态,通过思维链进行推理,并输出末端执行器的下一个目标位姿。随后,逆运动学算法和机械臂控制器驱动机械臂完成动作,该轮交互记录也会被加入上下文,供下一轮决策使用。
从头到尾没有感知模块、没有抓取规划器、没有技能库。定位物体、规划路径、判断上一步的偏差,全是模型自己从相机画面中完成的。这套训练方案叫 Robot-Use RL,和前沿模型学会使用电脑的逻辑一模一样。
具身上逼近 GPT-6 Astra 的小模型
LIBERO 是机器人操控领域的经典 benchmark,包含四个子套件(Goal、Spatial、Object、Long),合计 2000 个评测 episode。
Qwen3.8-27B 零样本只有 1.6%,经过 RL 训练后的 PEAR 达到 74.4%。同场的闭源旗舰:GPT-6 Astra medium 档 49.3%,max 档 76.2%;GPT-6.1 Sol medium 档 48.1%,max 档 80.6%。PEAR 用的是 xhigh 档。
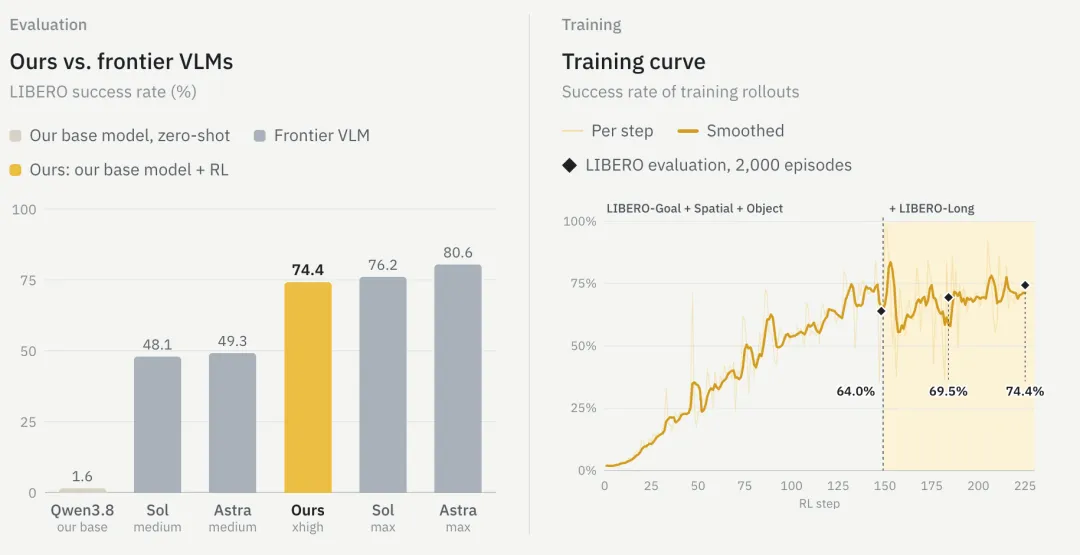
左图:LIBERO 任务成功率。 右图:强化学习(RL)训练过程中,每一步训练采样轨迹(rollout)的成功率。
LIBERO 原版上,π0.5 跑出 96.9%,PEAR 74.4%,看起来差距明显。但研究者引入了两个扰动版本 LIBERO-Plus 和 LIBERO-Pro,结果就完全不同了。
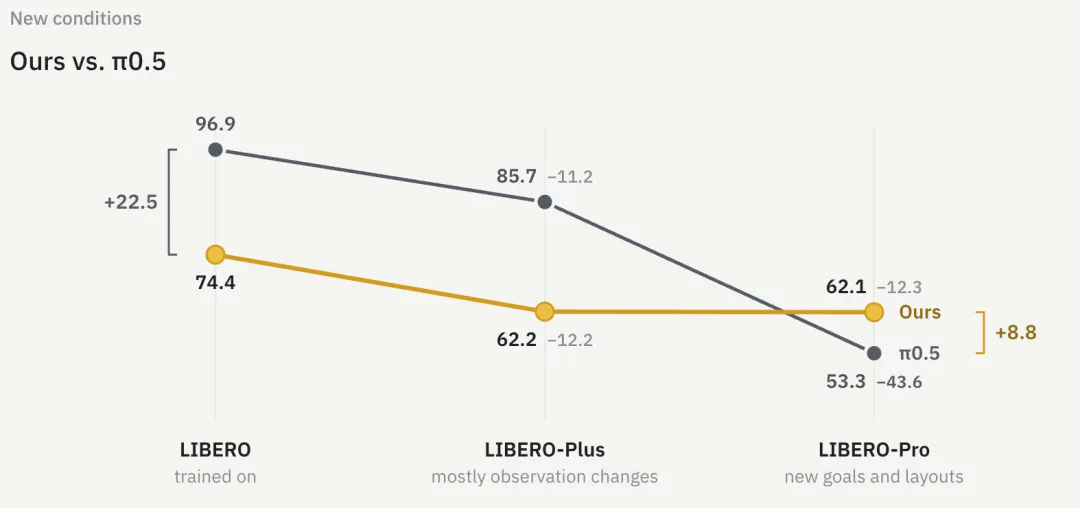
模型在 LIBERO 及其两个扰动版本上的任务成功率(%),两种策略均基于 LIBERO 训练。
LIBERO-Plus 主要扰动观测条件(相机角度、光照、背景、传感器噪声),两个模型下降幅度接近,LIBERO-Pro 则直接改变了任务目标和物体布局。看两种关键扰动:
任务替换。场景、物体、初始状态均一致,只替换指令。训练时指令为「把碗放到盘子上」,评测时改成「把碗放到炉灶上」。π0.5 从 96.9% 坠到 0.75%,掉 96.2 分。PEAR 从 74.4% 降到 57.4%,掉 17 分。
布局替换。指令不变,物体位置对调,完成同一句指令需要走不同的运动路径。π0.5 跌到 20.8%,掉 76.1 分。PEAR 落到 57.5%,掉 16.9 分。
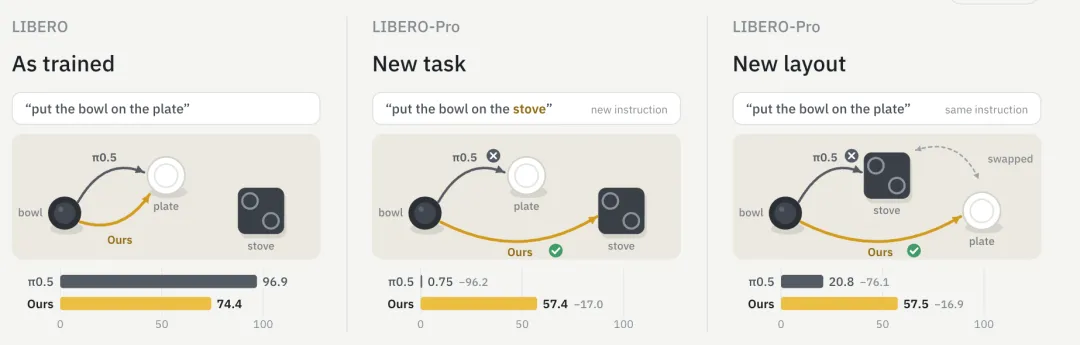
π0.5 在另外两种扰动(改写指令措辞、替换物体外观)上仍然领先,因为这两种情况下正确的运动轨迹没变。π0.5 记住了训练时见过的运动模式,模式适用就高分,模式失效就完全失败;PEAR 保留了基础模型的指令理解和视觉感知能力,RL 教它根据当前画面和指令重新生成位姿。一个在模仿,一个在推理,任务条件一变,差别巨大。
纯仿真训练
PEAR 的训练流程全程在仿真中完成,没有碰过任何真实机器人数据。迁移测试从三个维度展开。
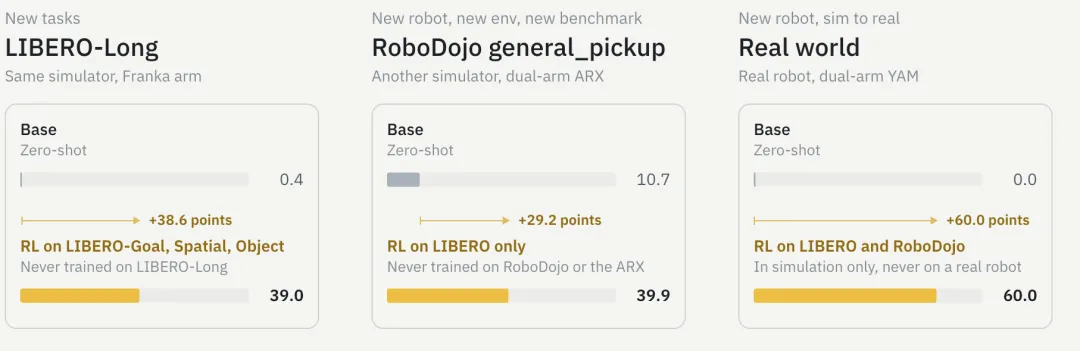
新任务。模型在 LIBERO-Goal、Spatial、Object 上训练后,零样本在 LIBERO-Long 上拿到 39.0%(底座 0.4%),在一个长程任务套件上从几乎零能力跳到接近四成。
新机器人、新仿真器。RoboDojo 是一个完全不同的仿真环境,机械臂从 LIBERO 的单臂 Franka 换成双臂 ARX。PEAR 只在 LIBERO 上训练,没碰过 RoboDojo 或 ARX,直接在 general_pickup 上拿到 39.9%,底座是 10.7%,近四倍的提升。
新 benchmark。第三个仿真评测平台 RoboLab-120,包含 120 个桌面任务,三个难度级别,每个任务 10 次评测。PEAR(在 LIBERO + RoboDojo 上训练后)跑出 37.3%,底座 5.4%。作为对比,RoboLab 排行榜上的通才机器人策略成绩如下:NVIDIA Cosmos3-Nano-Policy 36.8%、π0.5 28.0%、DreamZero 25.7%、GR00T N1.6 7.2%。PEAR 和 Cosmos3 几乎打平,高于其余三家。
真机。在 LIBERO + RoboDojo 都完成训练过后,研究者把模型拉到一台双臂 YAM 真机上。这台机器人在训练中从未出现,从仿真器到机械臂型号到物理环境全是陌生的。
30 次测试分两组。Align blocks 组用三角尺把三个积木摆成直线,5 个场景各 2 次,共 10 次。General pickup 组抓取 10 种物体(绳子、螺丝、遥控器、毛绒乌龟、网球、订书机、洗洁精、喷雾罐、气泵、刷子),每种 2 次,共 20 次。
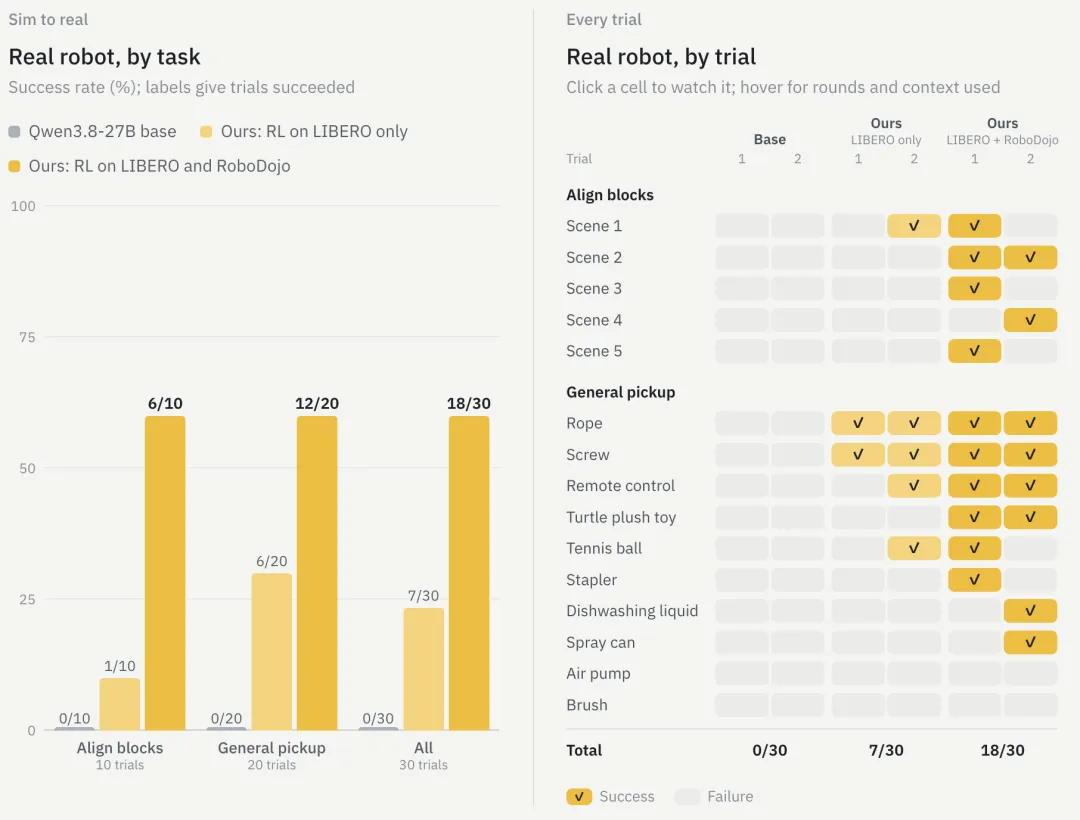
底座模型 Qwen3.8-27B 在真机上完全失败,成绩为 0/30。只在 LIBERO 上训过的中间检查点获得 7/30 的成绩。完整版能够达到 18/30,成功率 60%。
完全保留模型通用能力
通过强化学习学了机器人操控之后,原来的推理、编程、视觉能力还在吗?
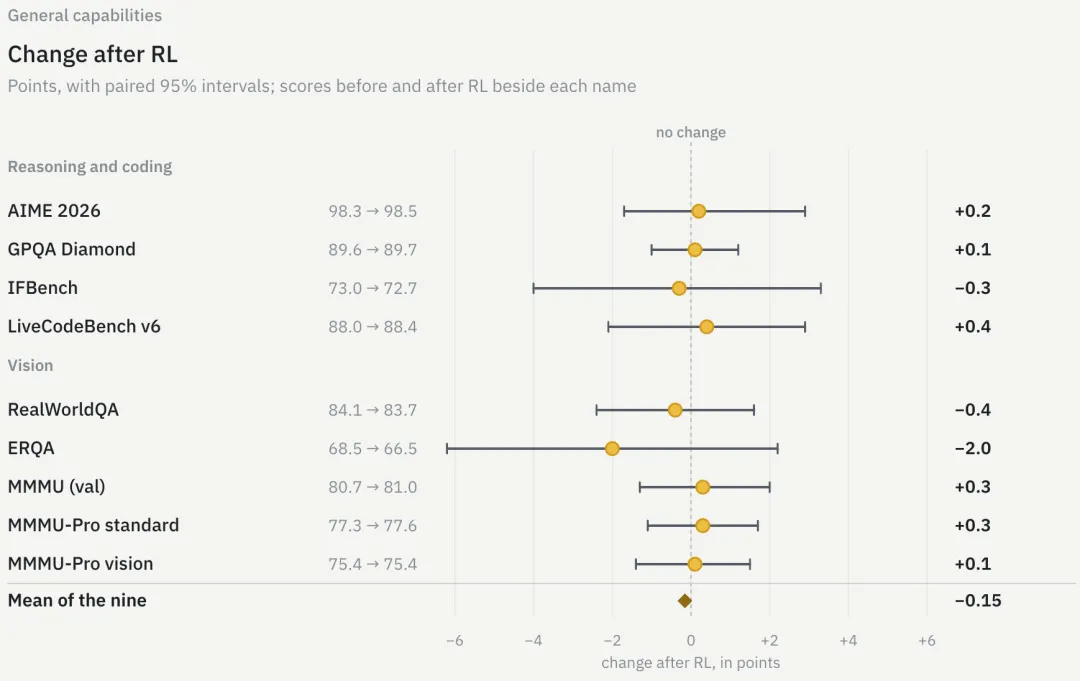
PEAR 与基础模型在相同问题上的表现对比。圆点表示得分变化,线段表示配对比较的 95% 置信区间。
从上述评测结果可以看出,模型依然保留了强大的通用能力:在 AIME 2026 数学竞赛测试中得分 98.5,GPQA Diamond 科学知识测试中得分 89.7,LiveCodeBench 代码能力测试中得分 88.4。在所有视觉基准测试中,其得分与基础模型的差距均不超过 2 分。
这意味着,同一个模型如今既能进行推理、编写代码、回答图像相关问题,也能操控真实机器人。
一张 RTX 5090 跑 220 token/s
每步动作之前都要走一遍思维链,解码速度直接决定机械臂的响应节奏。
推理栈的配置是 NVFP4 权重量化(NVIDIA ModelOpt)加 Inco AI 的 DFlash2 drafter(平均接受长度 3.2 token)。在不同硬件上的解码速度:
Apple M5 Max(Inco Splash 引擎):52 tok/s
单张 RTX 5090(megakernel):221 tok/s
单张 GB300(megakernel):747 tok/s
以 GB300 为例,xhigh 档一回合思考约 4.3 秒,low 档约 1.1 秒。模型训练时只用了 xhigh 档,但推理时 effort 仍然可调。low 档思考 token 约 0.86k(xhigh 约 3.23k),LIBERO 成功率从 74.4% 掉到 21.9%,成功率和思考量基本成正比。
一个带思维链的 27B 机器人模型在一张消费级 GPU 上就能实时驱动机械臂,这件事的实用意义可能比 60% 的真机成功率本身还大。
PEAR 验证了一条值得关注的技术路线:当基础模型的推理能力足够强,仿真环境中的强化学习就有可能教会它操控真实机械臂,无需额外构建复杂的感知管线、技能库,也不必依赖大量遥操作数据。
更重要的是,PEAR 在展示通用模型具身操作潜力的同时,也进一步降低了实现这种能力所需的模型规模和算力门槛。
过去,行业往往将更强的机器人智能寄托于更大的模型、更多的数据和更昂贵的算力。PEAR 则提供了另一种可能:机器人未必需要一个专门训练的庞大「大脑」,也有机会通过相对轻量的通用模型,获得足够实用的操作能力。
当然,距离复杂、开放的真实物理环境还有很长的路要走。但至少,PEAR 让行业看到,通向通用机器人智能的道路,或许比想象中更加多元,也更加经济。
更多信息,请参考原论文。
来源:机器之心