一段操作,一条进度曲线
——让机器人每一步操作都有迹可循
机器人完成一次复杂操作,可能需要连续执行十几甚至几十个动作。抓取、移动、对准、放置,每一步都可能改变任务的完成进度,但这些动作对最终结果的贡献并不相同。
以机器人插接网线为例,机械臂需要先抓住线缆,调整插头姿态,再对准路由器接口完成插入。即使机器人已经执行了多个正确动作,只要最后没有完成插接,传统的任务评价通常只能给出一次“失败”。
至于前面的哪些动作已经有效完成、任务究竟推进到了什么程度,单靠最终结果很难判断。
因此对于包含多个操作阶段的任务,训练系统不仅需要判断最终有没有完成,还需要知道执行过程中何时取得了进展、何时停滞,以及哪些动作导致了此前成果的损失。
这是机器人长程任务评价长期面临的痛点,也是日冕开物近日发布 NimCritic 的出发点。
作为面向长程操作的预测性进度评价模型,NimCritic 提出了动作感知量化(Action-Aware Quantification)这一机器人任务进度统一量化体系,仅需输入任务说明和操作视频,就能实时输出连续的任务进度曲线并判断任务成功状态。
在实验评测中,NimCritic 在公开权威基准 VPB 上的进度评价相关性指标(PRC-F1)达到 0.77,终态成功判断准确率(TSA)达到0.82,超越 GVL(GPT-6-Sol)约 65%;
在自建长程任务基准 LOOM上的这两项指标分别达到 0.86和0.92;
在大规模策略评估基准 RoboArena 上,更以约 97%的总体召回率精准识别人类偏好的成功轨迹。
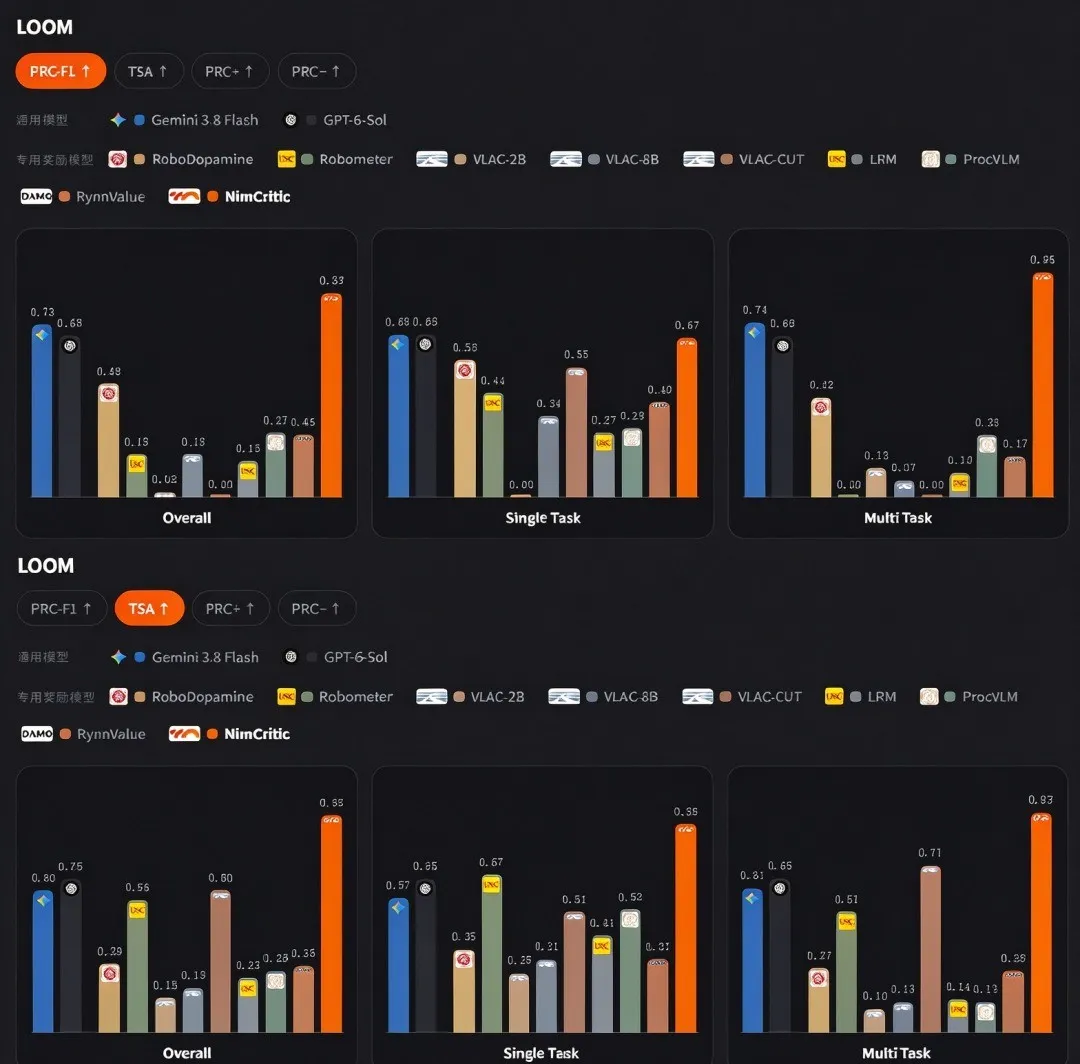
相比“只看成败”的二值结果,这种密集、可回溯的过程反馈,正在为操作数据清洗、策略评估与强化学习提供一把统一的标尺。
机器人干了十分钟,进度到底该怎么算?
机器人长程任务的过程评价,首先需要明确不同动作对任务目标的实际贡献。
常见的做法是人工标注关键阶段,或者给每个任务单独设计奖励规则。对比较固定的任务,这样可以工作;但换了物体、操作顺序或执行速度,评价标准就需要重新调整。
更根本的是,现有过程奖励模型(Process Reward Model,PRM)大多隐含了一个不成立的假设:进度在整条轨迹上均匀分布,且只增不减。
因此,NimCritic 先把“进度能不能往回走”这件事在规则层面承认下来。
它提出动作感知量化:把复杂的长程任务按操作对象拆解为清晰的物体级子任务,再在每个子任务内部,为不同阶段的动作分配差异化的进度权重。
简单来说,不再是“动了就给分”:
伸手靠近物体只占小权重,真正完成“插接、拧紧、放置”等核心状态改变才拿到大头贡献;
接触到了物体但还在调整尝试时,先给部分临时贡献,一旦后续操作手滑破坏了此前的成果,系统就会立即回撤对应贡献。
对于尚未完成的子任务,系统还会结合目标状态动态估计剩余动作,从而精准算出当前的真实完成度。
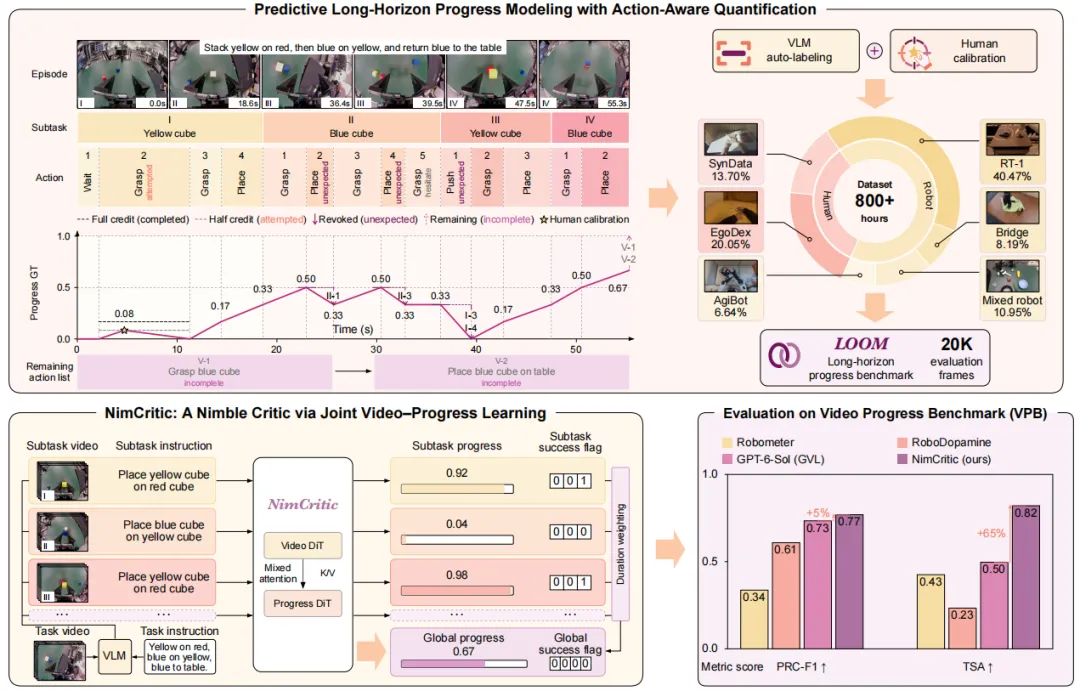
▲图2| 论文总览图首先给出了一套长程操作的“绝对进度量化体系”:不同物体对应不同子任务,动作按照是否真正推进目标来获得贡献,已有成果被破坏时则可以扣回。上方折线里的下降段代表动作破坏了已完成动作的贡献。图的下半部分进一步连接到 NimCritic 的模型训练与进度预测,说明这套规则不仅用来画图,也是构建训练监督信号的基础。©【深蓝具身智能】编译
这样一来,“倒退”,这个需要被容忍的异常,变成了评价规则里正式承认的一种状态。
只要任务目标和动作效果能够被识别,进度就有了相对统一的计算依据。下一步才是让模型从真实画面里学会这种判断。
NimCritic 如何从视频里看出进展与倒退?
定义好进度,并不意味着模型已经会评价操作。摄像头看到的是手、物体和环境连续变化的画面,系统需要从中判断某次接触有没有成功、东西是否被放到了目标位置,以及后续动作有没有改变原有状态。
日冕团队先利用视觉语言模型辅助拆分操作对象和动作,结合人工校验生成训练标注,整理了 253,276 条轨迹、约 857 小时视频,既包含机器人示范,也有人类第一视角操作。训练数据覆盖的动作与执行方式越丰富,模型就越有机会学会跨任务的进度判断,而不是记住某一种固定流程。
NimCritic 在模型设计上把视频预测与进度预测放到一起学习。
视频分支学习物体如何移动、接触后发生了什么变化;进度分支学习这些变化在任务目标中意味着推进、停滞还是回退。两条分支共享一部分视觉动态信息,使得进度估计能参考动作带来的物理后果。
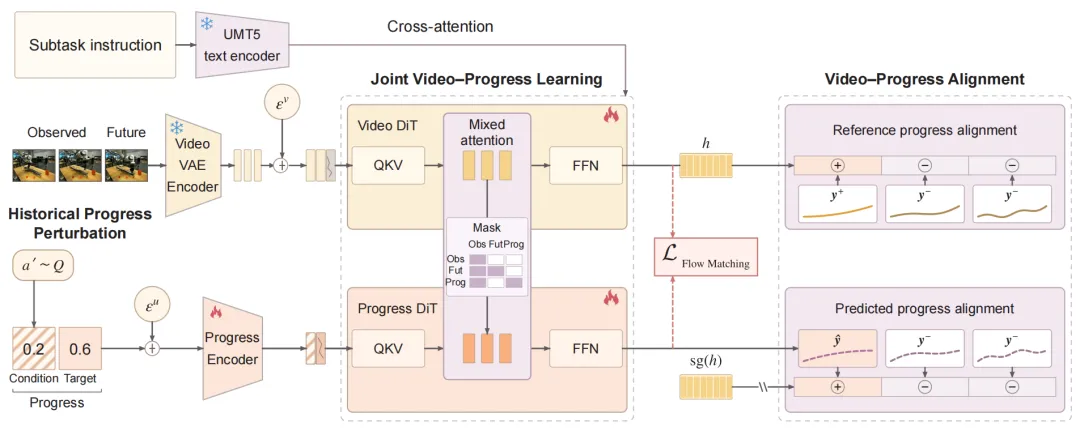
▲图3| NimCritic 的双流结构分别处理视觉动态和任务进度。上方视频分支学习操作前后的状态变化,下方进度分支预测当前进度与完成状态,两者通过交互和特征对齐建立联系。模型在长视频上还会参考历史进度,因此论文加入了历史进度扰动训练,让下一段预测在先前估计不准时仍有机会依据新画面修正。图中各模块的共同作用,是让进度判断更多地跟随实际物体状态,而不是单靠任务文字猜测。©【深蓝具身智能】编译
但长视频通常需要分段处理,这也带来了历史进度误差累积的问题。
后一段依赖前一段的进度估计,前面哪怕只偏了一点,误差也可能像“滚雪球”一样一路累积。
为此,论文在训练中引入了两大核心机制:
一是历史进度扰动(Historical Progress Perturbation)
故意在历史参考值中加入扰动,逼迫模型在“进度参考不准”时学会根据最新画面主动纠偏,抑制长程漂移;
二是精巧的对比式视频—进度对齐(Video–Progress Alignment)
在非对称的视频与进度双专家流之间建立“双向锚定”——既用进度信号去引导中间层的视觉动态特征(让模型盯住真正推进任务的物理变化,而非背景干扰),又让去噪后的进度轨迹贴近真实的视觉状态转移。
经过这样的训练,NimCritic 试图把原本需要逐段人工判断的操作视频,转成一条连续的进度记录,并附上任务完成状态。
从真实操作到公开测试,模型判断得准不准?
在下面展示的方块堆叠 Demo 中:随着积木被放好,进度曲线上升;当后续操作破坏了之前的摆放结果,曲线又往下走。
这也体现了动作感知量化和普通“做了多少步骤”之间的区别,之前做过的动作不等于成果一定还在。

▲图4| 三色方块堆叠是观察进度回退最直观的例子。画面中的积木从被抓起、放置到摆放状态发生变化,下方曲线会相应上升或下降。尤其值得看的是下降部分:机器人可能仍在积极操作,但如果新动作破坏了已完成的摆放,任务总体进度就应回撤,而不能只因为时间过去了就继续加分。©【深蓝具身智能】编译
日冕还开放了 NimCritic 在线体验页面,用户可以上传自己的操作视频,查看模型对任务进度的判断。
小编也体验了一段机器人抓取-放置的案例,执行的任务是“将香蕉放在碟子上”。
▲视频|NimCritic 在线体验,实操案例©【深蓝具身智能】编译
画面左侧是机械臂在桌面上抓取、移动和放置物品,右侧显示模型输出的进度曲线。随着任务执行,曲线在开始阶段较快上升,中间一段变化较为缓慢,最后随着机器人将香蕉放在碟子上,再次增长,和任务的进度保持一致。
它让操作过程里的阶段差异变得直观,也方便对照画面判断进度是否合理。
演示之外,研究还在 VPB 和 LOOM 两个进度评价基准、 RoboArena 评估基准上进行了测试。
进度评价
长程任务基准 LOOM 包含 300 条轨迹、19,618 个人工校准评估帧。
NimCritic 在这个基准上的进度评价指标 PRC-F1 达到 0.86,终态成功判断准确率为 0.92;
在公开的 VPB 基准上,两项指标分别为 0.77 和 0.82;
在 VPB 的终态成功判断上,相比所使用的 GVL(GPT-6-Sol)对照模型,相对提升约 65%。
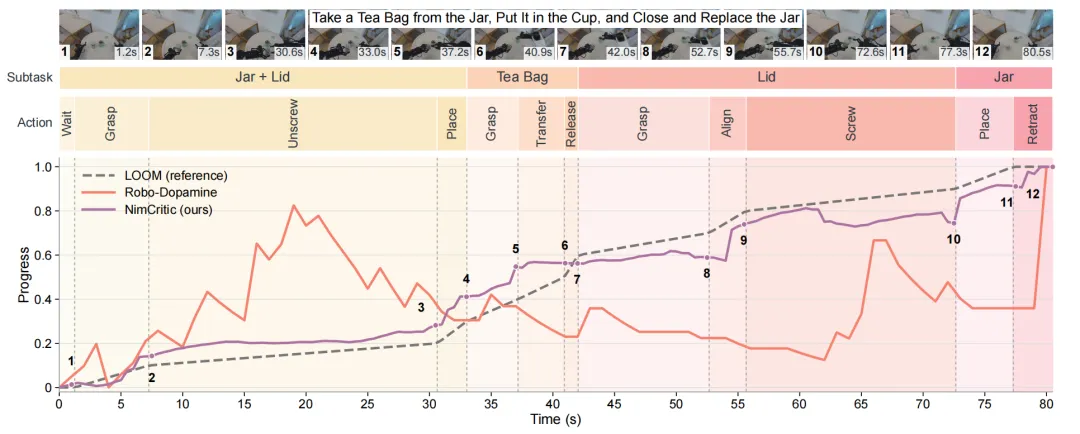
▲图5| LOOM 基准中的泡茶操作需要依次处理茶包、杯盖和容器等对象,每个子任务耗时不同,进度也不可能平均分配到视频每一秒。图中把人工校准的参考进度与模型预测曲线放在一起,可观察模型是否在关键操作发生时给出相应变化。它检验的是模型追踪长程任务过程的能力,而不只是看最后一个画面判断“完成没完成”。©【深蓝具身智能】编译
轨迹检索
如果一批操作视频里有成功也有失败,模型能否把值得保留的成功轨迹筛出来?
NimCritic 在这项测试中的总体召回率达到 96.72%,集合命中率为 98.09%。这意味着它在所评估的轨迹集合中,能够较好地识别人工选出的成功执行轨迹,为后续训练数据筛选提供支持。
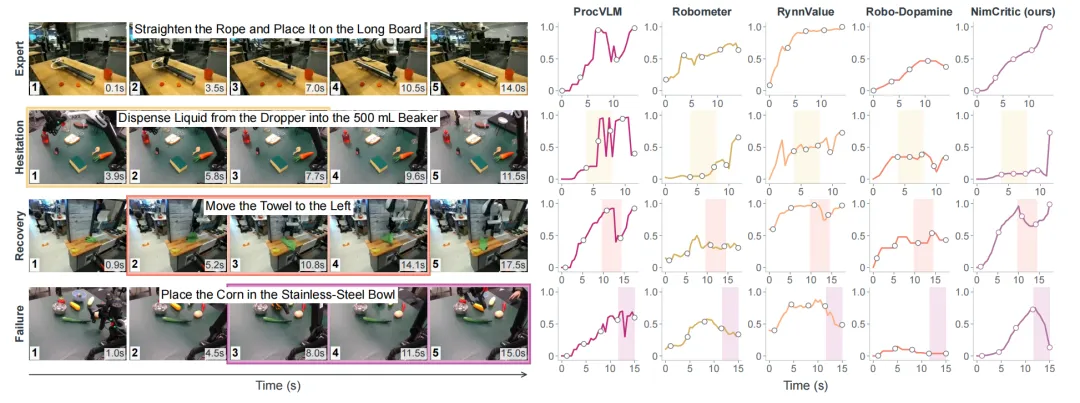
▲图6| VPB 对比图同时展示了熟练执行、犹豫停顿、纠错恢复和失败等不同轨迹。左侧是视频中的实际操作过程,右侧是不同方法预测的进度变化。对同一类任务,动作快慢和尝试次数可能差很多;好的进度模型需要识别物体状态是否真正向目标靠近,而不是把每条曲线都画成平滑向上的直线。©【深蓝具身智能】编译
广泛的评测结果表明,NimCritic 不仅能看懂每一步操作的细微进退,还能在海量演示中精准筛选出高质量成功轨迹。
那么,当这套定量、密集的进度反馈真正接入机器人学习闭环,会带来什么改变?
从筛轨迹到做奖励:让过程评价成为学习信号
机器人学习正在积累越来越多的操作数据,但数据量增加之后,如何判断哪些经验值得学习,也成了一个实际问题。
如果只按照最终结果对整段轨迹进行筛选,就容易丢掉其中有价值的操作经验。

▲图7| 这段研究 Demo 展示了机器人将插座类物体抓取、搬运并放入容器的过程。完整任务由多个前后关联的动作组成,模型给出的进度预测可以帮助区分“已经抓起”“正在移动”和“放置到位”等不同阶段。©【深蓝具身智能】编译
这也是过程评价模型可能发挥作用的地方。
通过持续预测任务进度,模型能够识别操作在哪些阶段取得了有效进展、在哪里出现停顿或倒退。研究人员可以根据这些信息筛选训练轨迹、定位容易出错的阶段,并尝试为策略训练构建更细致的奖励反馈。
对于机器人强化学习,这一点尤其重要。
传统奖励设计往往需要根据任务设置不同规则,涉及新物体、新操作流程时还可能需要重新调整。具有跨任务泛化能力的过程评价模型,有机会让部分反馈信息从执行视频中直接获得,从而减少重复设计奖励规则和人工标注的工作。
从角色分工来看,如果把机器人的运动控制策略(Policy)比作一线执行的“操作员”,那么 NimCritic 扮演的就是实时盯场的“过程评估专家(Critic)”——
它与底层控制策略解耦,不直接接管关节指令,而是专注于从视觉动态中持续输出高频、定量的价值标尺。
当“操作员”与“评估专家”在真实产线中配合起来,机器人自主进化的闭环才真正跑通。
NimCritic 的研究结果,对工业操作有什么用?
日冕做NimCritic的顺序,可能和很多基础模型研究的叙事是反过来的:不是因为有了一个评价模型,所以去找工业场景;而是工业现场先把“过程反馈缺失”这个缺口暴露了出来,才决定把这件事当成一个基础问题来做。
真实产线上的要求很具体:“新物料切换要在分钟级完成,POC成功率要稳定在99%以上,换型不换设备、不改造工位”。这种节奏下,“每换一道工序就重新设计一遍奖励规则”在工程上不成立。
过程评价如果不能在跨任务之间复用,它对工业现场的价值就几乎为零。
日冕与远图围绕服务器制造场景推进的“超级工站”合作,以及Physical RSI递归加速进化体系,提供的正是这样一个压力测试场:新工序部署从周/月级压缩到小时级,产线上的每一次操作、每一次意外、每一次“没做成”,都回流为学习信号。
NimCritic补的是这个闭环里“反馈信号”那一环。
对日冕来说,工业落地和基础模型研究不是两条平行线:问题从产线来,数据从产线来,验证也要回到产线去。
NimCritic目前做到的,是把“机器人每一步到底干得怎么样”从一个依赖人工判断的工程问题,变成一个可以用模型持续回答的问题。
这件事本身,在工业长程操作还普遍依赖“最后成功/失败”二值反馈的当下,已经是一个值得认真对待的起点。
Ref
论文题目:Predictive Long-Horizon Progress Modeling with Action-Aware Quantification
论文地址:https://arxiv.org/abs/2610.32776
NimCritic 项目主页:
NimCritic 在线体验:
来源:深蓝具身智能